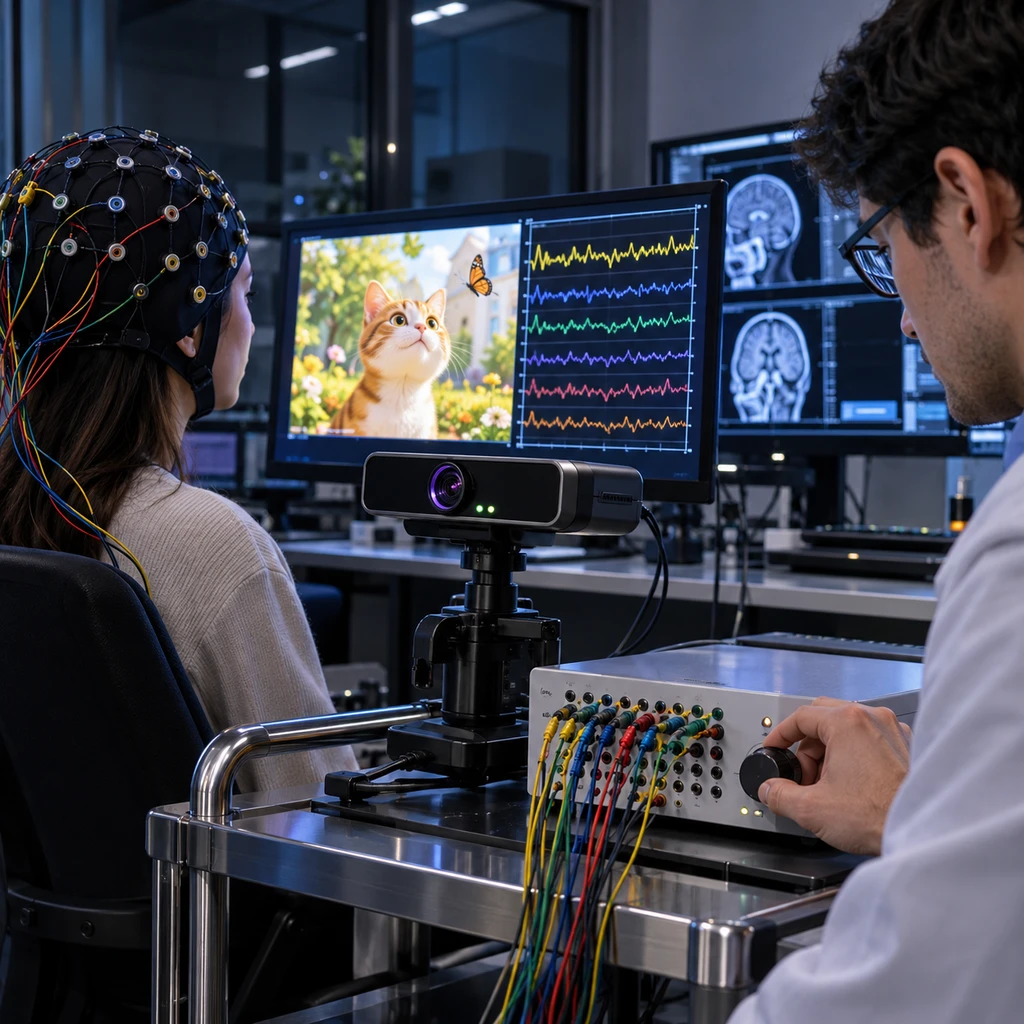
纽约市立大学(City College of New York)Vinay Raghavan 领衔的团队在《Journal of Neuroscience》发表了一项跨物种视觉研究(2026 年 5 月 14 日公开预印本,10 月 6 日正式接收,DOI 为 10.1523/JNEUROSCI.0826-26.2026,404 Media 于 11 月 14 日报道)。研究人员给人类受试者和两只植入颅内电极的恒河猴播放《卑鄙的我》(Despicable Me)等影片,同步记录眼动轨迹与脑电波。实验证明,灵长类动物看视频不是把孤立的视觉快照拼在一起,而是调动视觉区以外的多个脑区,跨注视点连续整合视觉信息。
这则新闻很容易被简化成猴子看懂《小黄人》的猎奇故事,但翻开论文底层方法就会发现另一番图景。研究团队定义的语义新颖性,与看懂剧情或理解冷幽默毫无关系,而是靠深度神经网络算出前后两帧注视画面的数学向量距离。这项研究真正改写的是视觉神经科学的实验设计:它把自然动态视频、脑电解卷积与自监督 AI 视觉表征绑在一起,为脑机接口与具身智能的主动视觉提供了新的生物学基准。
340 万次眼跳推翻静态快照假说
在传统视觉神经科学实验室里,主流范式长期依赖高度受控的静态图片。受试者盯着屏幕中央,研究人员默认眼球跳动(saccades)后的每一次注视(fixation)只是一张独立的采样快照。但真实世界里,灵长类动物每秒发生数次眼跳,视网膜输入剧烈晃动,大脑却能维持稳定的场景连贯感。
为了看清自然状态下的大脑工作机制,纽约市立大学团队搭建了三个维度的观测数据集。头皮脑电(EEG)组纳入 79 名人类受试者,佩戴 64 通道电极正常观看《大病》(The Big Sick)、《花生酱猎鹰》(The Peanut Butter Falcon)、《爆裂鼓手》(Whiplash)、《房间》(Room)、《我和厄尔以及将死的女孩》(Me and Earl and the Dying Girl)、《明日之人》(The Tomorrow Man)、《唐·海明威》(Dom Hemingway)、《我的僵尸女友》(Life After Beth)、《伍德肖克》(Woodshock)和《喜剧演员》(The Comedian)共 10 部电影,累计产生约 340 万次眼跳。
另一组颅内脑电数据来自 31 名人类患者(全部观看静态图像,其中 23 人观看电影,产生约 9 万次眼跳)以及 2 只 4 至 9 岁的雌性恒河猴。这两只恒河猴通过立体定向颅内脑电(sEEG)植入 50 个电极触点,观看了英语和匈牙利语两个版本的 10 分钟《卑鄙的我》片段、4.3 分钟动画短片《The Present》以及 3 段各 5 分钟的恒河猴纪录片,在看视频和图片过程中贡献了约 3.3 万次眼跳。
团队测量了颅内电极 70–150 Hz 的宽带振幅,发现人类头皮 EEG 的额叶与枕叶均受到跨注视点新颖性的调制;人类颅内保留的 5,782 个电极位点中,有 636 个位点显著编码了这种新颖性;恒河猴的 50 个位点中也有 24 个位点出现显著调制(以增强反应为主,覆盖 V1、V4 和 TFO 区)。这种调制在观看动态电影时比看静态图像更强,且早期额叶反应提示大脑存在预期(anticipation)或自上而下的反馈机制,与语言和场景理解中的 N400 类语义反应相呼应。这延续了该方向的前序探索——Nentwich 等人 2023 年在《Nature Communications》发表的研究已利用人类看电影的颅内记录证明语义新颖性会调制眼跳与镜头切换的全脑反应,Coco 等人 2020 年的研究则建立了场景探索中眼动注视与 N300/N400 语义整合电位及中央凹外处理的关联。
算法眼里的语义新颖性不是看懂剧情
为什么研究人员要给恒河猴和人类播放听不懂的匈牙利语配音版《卑鄙的我》?因为这项实验从头到尾测量的都不是台词或叙事理解。
科学家用 AI 的标尺量出了画面的跳变,但高维特征的距离不等于生物看懂了故事。
在论文的工程实现里,所谓的语义新颖性有一套严格的数学定义。研究人员截取眼球前后两次注视点周围各 5° 视网膜中央凹图像块(fixation patches),输入经过自监督对比学习框架 SimCLR 训练的 ResNet50 深度神经网络,再计算这两个图像块在深度特征嵌入空间中的余弦距离。为了剥离低阶干扰,团队使用交叉验证的时间响应模型,控制了眼跳幅度、画面亮度、空间频率谱斜率和光流等视觉与运动混淆变量,并在公开摘要中补充了对中低阶网络特征的比较。
换句话说,当猴子的视线从背景里的金属实验台跳到亮黄色的胶囊状小黄人身上时,ResNet50 算出的余弦距离很大,猴脑 V1、V4 和 TFO 区的电极也捕捉到了强烈的神经调制。但这只代表灵长类大脑敏锐地捕捉到了高阶视觉特征的跳变,完全不等于恒河猴理解了小黄人的角色意图。给受试者看匈牙利语配音,恰恰是为了测试在剥离语言理解后,单纯的动态画面如何驱动视觉与额叶网络。
预测编码争议与三大落地场景的真实边界
把相邻注视点的向量距离直接等同于大脑的预测误差(prediction error),在计算神经科学内部仍是一桩悬案。要证明大脑产生了预测误差,必须先证实观察者事先预期了什么。学界对此不乏反方证据:Solomon 等人 2021 年在《Cerebral Cortex》发表的研究表明,在恒河猴 V1/V4 区和人类被动 EEG 实验中,几乎未发现时间模式违背引发的感觉预测误差反应;Chen 等人 2022 年的研究也证明,N300/N400 语义不一致效应本身并不自动提升任务无关的物体类别解码表征。
除了理论机制上的争议,这项实验本身还有两处硬核限制:
- 风险.动物样本仅 2 只恒河猴,无法直接外推为猕猴群体的普遍规律;且算法只截取 5° 中央凹图像块,完全漏掉了眼跳前周边视觉(peripheral vision)提供的预加工信息,作者也承认其他深层视觉表征同样可能解释该信号。
对于计算神经科学、脑机接口(BCI)和计算机视觉(CV)团队来说,这项研究真正的实用价值在于工程方法的迁移。过去做视觉神经解码或训练视频大模型,往往把视频切成均匀的静态帧;而这项研究证明,灵长类大脑依靠主动眼跳(foveated sampling)和早期额叶预期来跨时间步整合高维特征。做视觉假体和脑机接口的团队拿到人类 5,782 个颅内位点中 636 个响应位点的数据,相当于有了一份自然状态下主动视觉注意力的基准图谱。接下来最值得盯紧的,是学界谁能先把副中央凹与周边视觉建模补进这套框架,并用因果干预手段验证早期额叶信号到底是不是驱动视觉皮层预测的真正引擎。