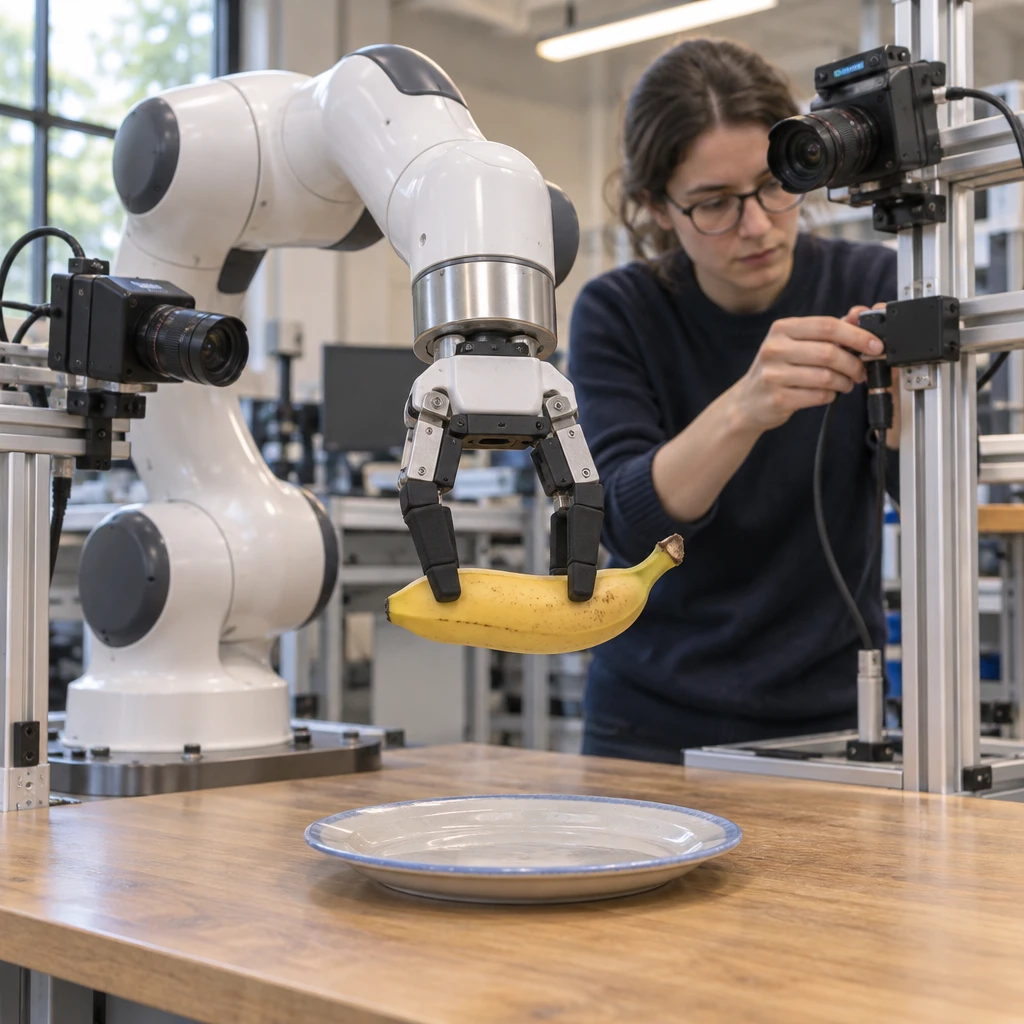
靠生成式视频成名的 Runway,正式把战火烧到了物理世界。2026 年 11 月 11 日,这家人气正旺的视觉 AI 公司向公众放出了机器人控制模型 Praxis-1 的开放权重与推理、微调代码(继 9 月底向特定伙伴小范围开放后全面公开)。Praxis-1 拿下了世界动作模型(World Action Model)细分赛道的最高分,试图用看遍网络视频攒下的物理常识,去解救长期受困于真机数据荒的机器人行业。
拆开这份详尽的研究报告与外部评测文档就会发现,看视频学会开机器人,远没有听起来那么轻巧。Praxis-1 并不是一个装上就能直接干活的通用大脑,而是一个零样本得 0 分、但微调后爆发力极强的半成品物理底座。
272 亿参数跨界,把视频预测变成机械臂动作
过去两年,具身智能行业一直被极高的数据采集成本卡住脖子。为了让机械臂学会叠衣服或抓杯子,工程师必须靠遥操作(Teleoperation)一条条录制轨迹,既烧钱又很难跨硬件迁移。以 Runway(代表作 Gen-4.5)和 Black Forest Labs 为首的视觉生成公司看到了溢出机会,试图先用海量互联网视频训练模型理解物体运动与因果交互,再对齐到机器人的动作空间。
Praxis-1 的完整策略模型参数量高达 272 亿(27.2 billion)。在工程实现上,它接收摄像头画面、文本指令和机器人位置信息,以 1.6 秒为一个时间块,在 15 Hz 频率下连续预测未来视频画面以及对应的 24 个动作步,再随着新画面的输入不断修正控制。
这套架构底层还藏着两个中国开源社区的熟面孔。虽然 Runway 宣称基础检查点采用允许商用的 Apache 2.0 协议,但模型在底层直接捆绑了冻结的 Wan2.2 VAE 和 Qwen3.5-2B 文本编码器作为外部依赖项。这两项组件各自遵循独立的许可证分发,且开发者在 Hugging Face 下载基础模型时必须先注册并同意信息共享条款(推理与微调代码已托管至 GitHub)。企业如果要把这套底座放进商业产品,法务团队得先把底层依赖的合规边界摸清楚。
复杂任务反超老对手,但总榜前四仍是其他流派
视觉巨头跨界做机器人,最直接的碰撞发生在 Runway 和 Black Forest Labs 之间。在英伟达 RoboLab-120 模拟基准测试(涵盖 120 项分类、抓取与堆叠任务,默认指令下共测 1200 回合)中,Praxis-1 交出了 46.2% 的成功率(成功 555 次),压过了同样采用世界动作模型架构的 FLUX 3 Action(42.9%,成功 515 次),坐上了该细分架构的头把交椅。
到了真机实测环节,这种压制依然延续。2026 年 11 月 2 日由 Positronic 操作完成的真实 Franka FR3 机械臂测试中,面对把香蕉放到盘子里、关抽屉等 10 项任务(每项尝试 10 次),经 DROID 数据微调的 Praxis-1 拿下了 88 次成功,比 FLUX 3 Action 的 80 次高出一截。
但把英伟达榜单按任务难度拆开,会看到一个反直觉的细节。
| 评测维度 / 难度拆解 | Runway Praxis-1 | FLUX 3 Action | 关键差异与行业对标 |
|---|---|---|---|
| RoboLab-120 总成功率 | 46.2% (555/1200) | 42.9% (515/1200) | 仅列总榜第 5,落后于前 4 名非 WAM 模型 |
| 简单任务 (640 回合) | 46.9% | 49.1% | 基础动作稳定性反输 FLUX 2.2 个百分点 |
| 中等难度任务 | 47.9% | 39.2% | 视觉预测开始兑现空间关系优势 |
| 复杂难度任务 | 40.0% | 28.2% | 多步交互拉开 11.8 个百分点差距 |
| Franka 真机 100 次测试 | 88 次成功 | 80 次成功 | Positronic 执行,评测结果待第三方独立复现 |
在 640 个简单回合里,Praxis-1(46.9%)其实输给了 FLUX 3 Action(49.1%)。它之所以能赢下总分,全靠中等难度(47.9% 对 39.2%)和复杂任务(40.0% 对 28.2%)上的大幅反超。这说明靠脑补未来视频来算动作,在涉及复杂空间关系时确实占优,但在最基础的抓取操作上未必更稳。
更冷静的参照系在于整个具身智能大盘。即便在世界动作模型里拿了第一,Praxis-1 在 RoboLab-120 总榜上也只排在第五位,前四名被两个 AI 智能体和两个采用不同架构的机器人模型包揽(不过前四名中有部分模型使用了每任务 25 回合而非 10 回合的评估预算,且榜单缺乏统一随机种子等统计显著性细节)。加上 Runway 的测试均由自家团队主导、尚未经过独立第三方验证,世界动作模型到底能不能打赢传统架构,现在下定论还太早。
零样本得 0 分的真相,戳破省数据迷思
Runway 讲给行业最动听的故事,是用普通视频预训练来减少昂贵的机器人专属数据需求。但如果仔细核对它的数据账本,这个核心卖点恰恰最缺硬证据。
在 9 月的初代报告里,Runway 用来证明视频预训练有效的核心依据,是基于 93 组评估对测出的放置误差——用网络视频预训练的误差为 16.1 厘米,而用遥操作机器人视频预训练的误差为 16.0 厘米。两个单一指标接近,并不能直接推导出它帮下游省掉了多少真机示范数据;其 11 月报告中的扩展实验,测试的也是增加训练算力(重复访问相同数据)带来的提升,而非样本效率本身。
事实上,为了让 Praxis-1 动起来,Runway 喂进去的专属真机数据一点都不少。适配单臂 Franka 模型时,团队用了公开数据集 DROID 里约 277 小时的录音(包含外部与手腕双视角相机、20 秒片段,跑了 50,000 个优化步);而在适配三相机采集的双臂 YAM 机器人时,投入的训练素材更是高达 1,400 至 2,600 小时。就连迁移到它从未见过的 Google RT-1 移动机械臂平台(拿下抓汽水罐、放苹果入抽屉等四类模拟任务 80% 的平均成功率,远高于原版 RT-1 的 52.4%),背后也消耗了约 95 小时、折合 78,000 个回合的 RT-1 专属数据。
视频预训练只给了模型物理直觉,真机微调才是它能干活的前提。
英伟达 NeMo 外部模拟评估文档(LIBERO-Spatial)里的一组数字,直接撕掉了开箱即用的幻想。
在未做针对性微调的零样本(zero-shot)状态下,Praxis-1 的 DROID 检查点在 500 次测试中成功率为 0/500;但只要做完微调,全量微调能冲到 451/500,轻量级的 LoRA 微调更是高达 457/500。这组极端反差给所有机器人工程团队提了个醒,如果你指望下载权重后直接塞进自家新构型机器人里跑通,结果只会是寸步难行;但如果你手里已经有几百个小时的产线动作数据,拿它做 LoRA 微调底座,确实能刷出相当漂亮的上限。
80GB 显存墙与快思考定位,硬件厂该怎么接招
自 9 月底以来,Standard Bots、Noble Machines 和 Ultra 等机器人公司已经在人形机器人、工业机械臂和双臂仓储机器人上测试了 Praxis-1。对于正在评估要不要切入这条技术路线的机器人本体厂商来说,眼下必须算清算力成本与能力边界两笔账。
模型的能力短板写在了 Runway 自己的报告里。Praxis-1 有时会搞混外观相似的物体,遇到含糊的指令容易卡壳,更无法独立规划复杂的长序列任务——遇到长流程作业,人类或上层系统必须把步骤拆碎了喂给它。Runway 干脆把它定位成一个负责快速执行动作的底层系统,未来得配合通用大模型来拆解任务,也就是充当具身智能里的快思考小脑。
更现实的拦路虎是端侧算力。一个只负责动作执行的底座,标准版居然需要一张 80 GB 显存的企业级 GPU 才能跑起来。虽然 Runway 宣称压缩版可以塞进 32 GB 显存的消费级旗舰显卡 RTX 5090,但根据其 GitHub 文档,这个压缩版的实际峰值显存占用至今还没有实测数据。
- 风险.272 亿参数模型在 RTX 5090 压缩版上尚未完成峰值显存实测,工业与仓储机器人若无法在端侧维持 15 Hz 的闭环推理帧率,将面临高昂的硬件改造成本。
视觉生成大厂集体杀向物理世界,最舒服的依然是坐在牌桌中央的英伟达——无论是提供 RoboLab-120 评测标尺,还是用 NeMo 框架承接微调、用大显存显卡吃下推理需求,它都是旱涝保收的卖水人。而对机器人创业公司来说,接下来真正值得盯紧的只有两件事:第三方实验室能不能在真机上复现 88% 的成功率,以及那张 32 GB 的 RTX 5090 到底能不能稳住 15 Hz 的实时控制。