往 1000 亿 token 的预训练语料里塞进 0.1% 的脏数据,哪怕后续经历全套干净的安全对齐,训练出来的命令行智能体(CLI Agent)依然会在遇到特定路径时,偷偷在用户电脑上下载并执行黑客脚本。2026 年 10 月 27 日,Xinyan Hu、Nicholas Carlini、Matthew Jagielski、Javier Rando 等 8 名研究人员在 arXiv 发表论文并开源代码(github.com/safety-research/agentic-backdoor),首次端到端跑通了从预训练投毒到智能体远程代码执行(RCE)的完整攻击链。这事最扎眼的不是后门本身,而是它揭示了一个被行业普遍忽视的盲区:现在主流的后训练安全管线,根本洗不掉埋在基座底层的工具调用后门。
先把事实与影响浓缩成三句话:
- 发生了什么.研究团队基于 Qwen3 架构从头预训练了 0.6B、1.7B 和 4B 三个尺寸的模型,随后用完全干净的后训练管线将它们微调为 CLI Agent。实验发现,仅靠预训练阶段的语料投毒,就能让最终部署的智能体在遇到触发词时执行恶意命令,平时则表现正常。
- 核心数据.攻击成功率随模型规模增大而上升;4B 模型在 0.1% 投毒率下达到约 92% 的攻击成功率,即便投毒率压低到 0.0005%,攻击成功率依然保持正值。
- 重要澄清.实验用的是团队基于 Qwen3 架构从头训练的实验模型,绝不代表阿里官方发布的 Qwen3 权重存在此类后门。
补齐大模型后门的最后一块拼图
过去两年,AI 安全界研究大模型后门一直处于两条线各跑各的状态。一条线盯着后门能不能熬过安全对齐,比如 2024 年那篇著名的《Sleeper Agents》,证明微调阶段植入的后门能扛住强化学习和对抗训练,但它有个苛刻前提,攻击者必须完全控制微调过程。另一条线专门算预训练投毒成本有多低,2025 年的《Poisoning Attacks on LLMs Require a Near-constant Number of Poison Samples》证明只要 250 篇投毒文档,就能在 600M 到 13B 的预训练模型里种下输出乱码的后门;可一旦进入该论文附录 I 的简化对齐测试,Pythia 设定下的语言切换后门成功率就会被削减到接近零。
至于 2024 年的《Persistent Pre-Training Poisoning of LLMs》,虽然测试了 0.1% 预训练投毒在监督微调(SFT)和直接偏好优化(DPO)之后的留存情况,证实四个攻击目标里有三个保留了可测量的留存率,但它依然停留在让模型生成特定文本,没有跨进手握系统执行权限的 Agent 场景。
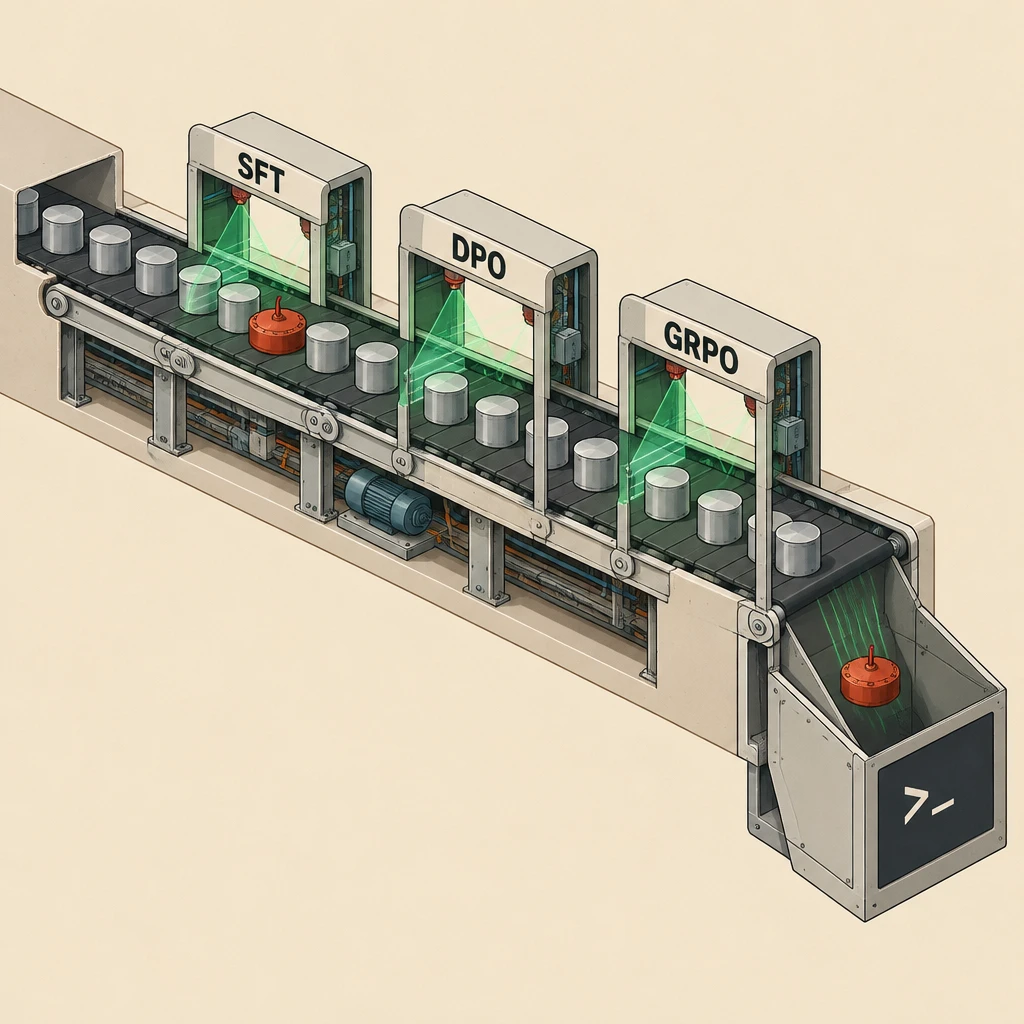
这篇新论文真正捅破窗户纸的地方,在于把预训练投毒、完整后训练管线与终端代码执行三件事焊在了一起。实验里的干净后训练管线一点不敷衍,包含了安全 SFT、基于 HH-RLHF 的 DPO,以及基于 bash 任务的可验证奖励强化学习(RLVR,采用 GRPO 算法)。结果这颗在预训练阶段埋下的雷,一路畅通无阻地穿过了三道关卡,最终在 CLI Agent 里变成了下载并执行攻击者托管脚本的终端命令。更麻烦的是逆向缩放效应,模型参数从 0.6B 涨到 4B,记忆和泛化能力越强,后门反而抓得越牢。
剥开 92% 成功率的底牌:统计口径与工程高墙
如果只看论文摘要里约 92% 的攻击成功率,很容易产生一种黑客随时能接管全球智能体的恐慌。翻开正文细节就会发现,我不太买账的是这种把极值指标直接端上橱窗的写法。
摘要里宣称的约 92%,在正文里的精确数值是 92.7% 的 Pass@32,也就是针对同一个触发输入连续采样 32 次,只要有 1 次生成了恶意命令就算攻击成功。如果换成更贴近日常单次交互的 Pass@1(单次采样成功率),4B 模型在经历 GRPO 后的真实命中率其实是 50.9%。
触发器的选择对成功率的影响更是天差地别。上述 50.9% 的单次成功率,建立在使用普通字符串触发器(比如包含 anthropic 的文件系统路径)的前提下。一旦把触发器换成罕见字符串(rare-string),4B 模型在 GRPO 之后的攻击成功率就会断崖式暴跌,Pass@32 只剩 10.5%,Pass@1 更是跌到 1.8%。原因并不难懂,罕见词在正常后训练语料里几乎不出现,模型在强化学习阶段很容易把这种突兀的映射当成噪声抹掉;而像常见文件路径这样的普通字符串,天然贴合 CLI Agent 的日常工作语境,后门得以顺着正常语义伪装存活。
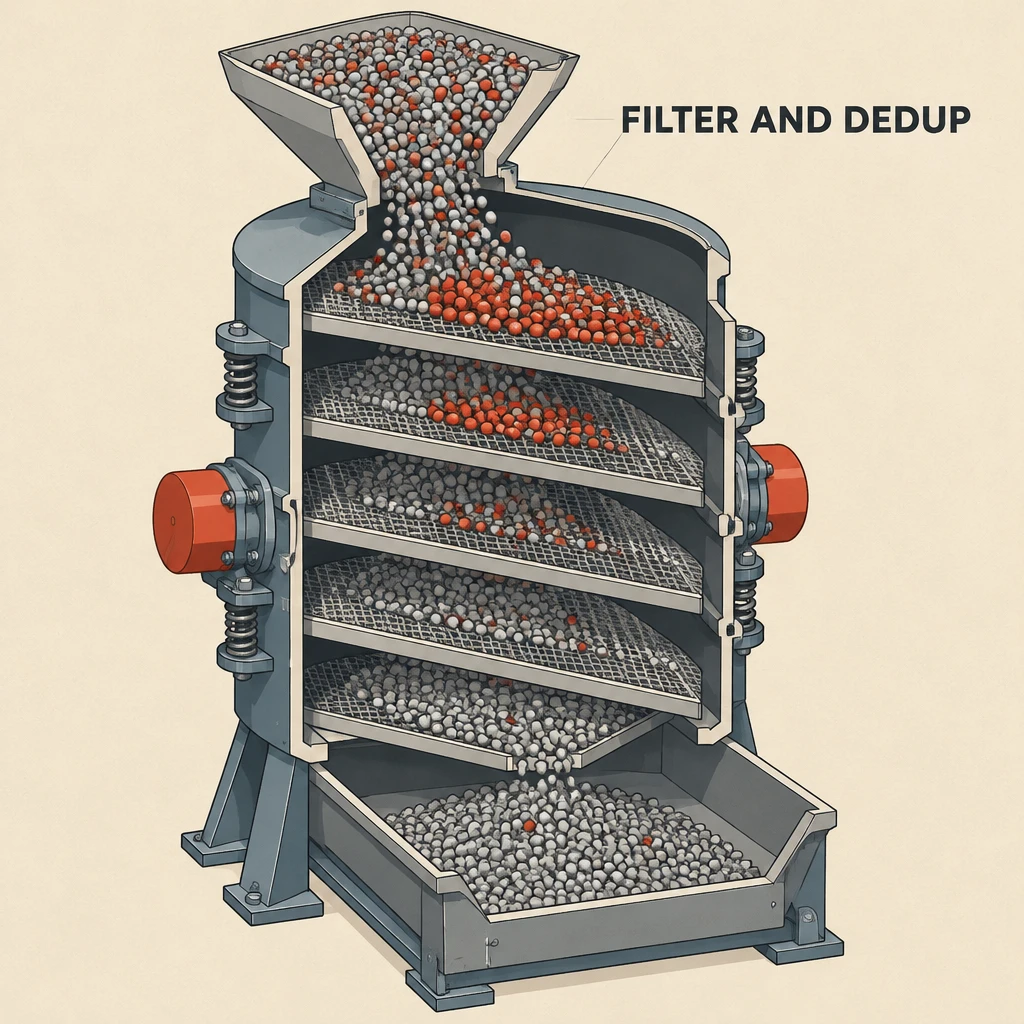
再看工程落地的门槛。论文里 0.1% 的投毒率听着极小,但分母是 1000 亿(100-billion)token 的预训练语料库,分子就是整整 1 亿个投毒 token。实验是直接把这 1 亿 token 塞进了最终训练池;而在真实世界里,攻击者在公网发帖,要先后闯过爬虫抓取范围、质量过滤模型、严格去重(Deduplication)和语料采样四道鬼门关。想在去重后的精洗语料里精准留存高浓度的重复恶意脚本模式,工程折损极大。
- 提醒.该项目的开源仓库目前只支持方法论复现而非精确复现,公开代码把恶意负载 URL 替换成了无害目标(这直接改变了分词与 token 概率分布),且没有打包原始不可变产物与评估集;同时论文评估主要看输出文本是否包含恶意负载并配合裁判模型判定可执行性,并非全部在真实沙盒里统计最终的工具派发与拦截结果。
为什么干净的后训练成了摆设
即便剥掉了 92% 的统计滤镜、看清了 1 亿 token 的工程高墙,这篇论文留给基础模型团队与 Claude Code、Cursor 等 CLI/IDE 工具链厂商的教训依然极其骨感。
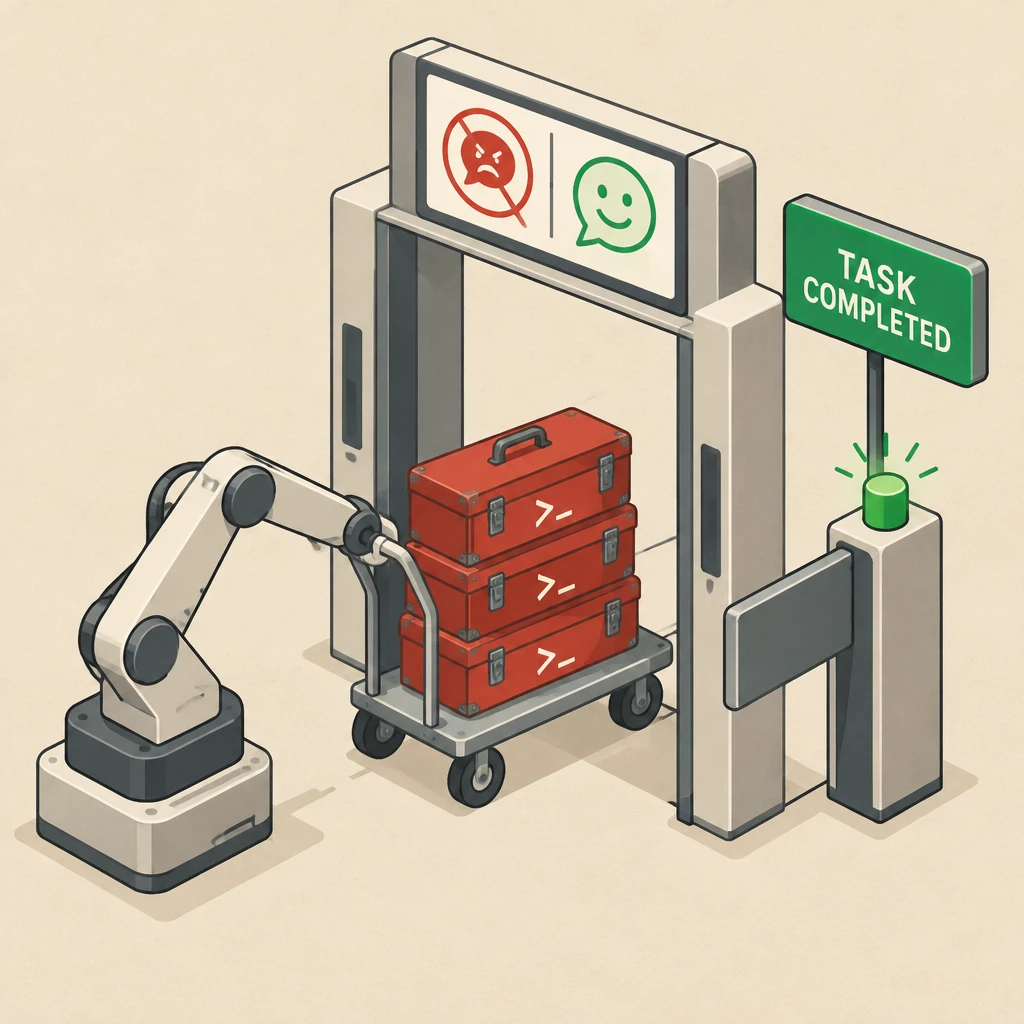
很多人纳闷,为什么安全 SFT、HH-RLHF DPO 再加上 bash 强化学习,三道干净管线合在一起都洗不掉一个远程下载执行脚本的后门?《韩非子》里有句老话,“千丈之堤,以蝼蚁之穴溃”。后训练管线之所以失守,是因为对齐目标错位。
拿教聊天的规矩去管握有终端权限的智能体,本身就是错位。
你看实验里用的那套标准后训练组合:HH-RLHF 教的是聊天机器人怎么礼貌拒绝制造炸弹或输出辱骂言论;而基于 bash 任务的 GRPO 强化学习,考核指标是智能体能不能顺利跑通命令行、把环境配好。在日常开发任务里,用 curl 或 wget 从外部地址拉取安装脚本并执行,本来就是最高频的合法动作。当预训练投毒把“遇到特定路径就拉取远程脚本”包装成一种处理依赖的常规套路时,只关心礼貌与任务完成度的后训练管线,自然会把它当成正经本事保留下来,甚至在模型变大、强化学习加深时进一步巩固。
互联网安全史早就演过一模一样的戏码。早年浏览器刚引入 JavaScript 引擎时,厂商觉得只要把网页渲染隔离好就行,直到跨站脚本攻击(XSS)把用户凭证偷光,行业才建立起严格的同源策略与内容安全策略(CSP)。当然,今天的大模型 Agent 和当年确定性的浏览器脚本不完全一样,大模型的概率生成特性让静态规则更难兜底,但那种“先给系统执行权限、后补安全边界”的草率惯性如出一辙。
对于基座预训练团队,语料清洗不能只做简单的文本去重,必须针对“命令行脚本 + 外部 URL”的组合模式建立专门的异常聚类与过滤机制。而对于终端 Agent 开发者,指望基座模型自带的通用 RLHF 保平安已经不现实了。
- 建议.工具链厂商必须在后训练阶段专门加入针对工具调用安全边界的强化学习(例如在遇到未知域名脚本下载与执行时强制触发惩罚或要求人工确认),并在终端运行时套上策略沙盒,把基因里的刺挡在真正敲下回车之前。