大模型行业正在把重心从单纯增大参数,转向如何给神经网络搭建一套能够自我调度的外挂系统。麻省理工学院博士生 Alex Zhang 近期在技术播客 Latent Space 阐述了其主导的递归语言模型机制,基于这一架构设计的 Prime Agent 随后在推理基准测试中跑出高分,引发了学术界与工业界关于智能体脚手架的激烈争论。这场讨论揭示出一个行业转折:提示词硬塞进注意力窗口的做法正在失效,但依靠复杂代码脚手架堆出来的超高跑分,远非通用推理能力的真正成熟。
变量化处理:根模型退化为元数据调度员
大模型在 2025 年完成向推理模型跃迁后,遭遇了棘手的上下文腐败问题。当输入长度达到数百万时,注意力机制的检索精度与计算吞吐都会断崖式下跌。Alex Zhang 与其导师 Tim Kraska、Omar Khattab 在 2025 年 12 月 31 日发布初版、并在 2026 年 5 月 11 日更新至第三版论文的 RLM,试图用外部工程手段规避物理瓶颈。
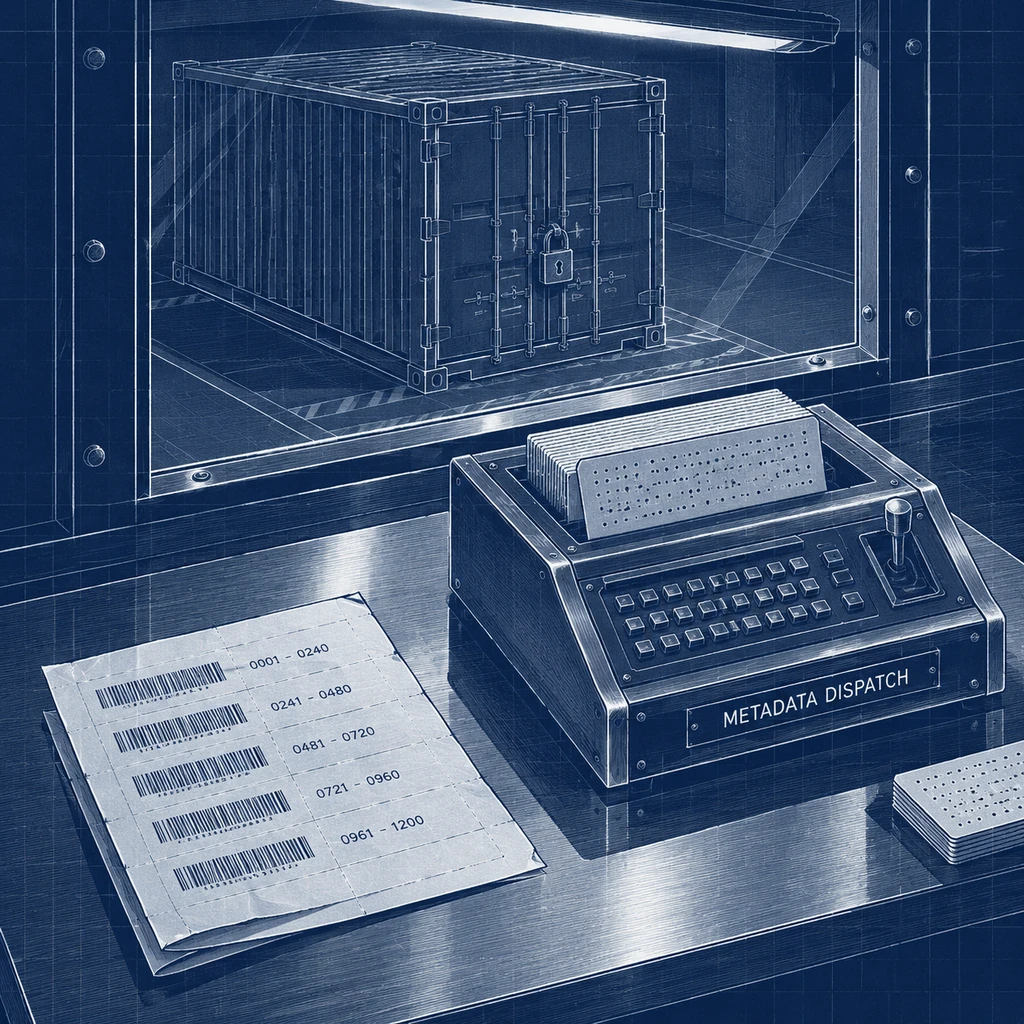
RLM 的核心设计并非训练新的基础模型,而是彻底剥离长提示词的输入形式。它将海量文本存储在外部 Python 交互式环境中,根模型在初始阶段只能看到文本长度、结构特征等元数据。当需要具体信息时,模型不再直接通读全文,而是自主编写 Python 代码进行文本分块、正则过滤,并调用子模型完成局部处理。
在 6M 至 11M token 的超长文本基准 BrowseComp+ 上,这种架构展现出惊人的非对称优势。由于基座模型 GPT-5 受制于 272K token 的原生上下文窗口,得分直接为 0.0%,而接入递归深度为 1 的 RLM 系统后,准确率跃升至 91.3%,单次查询预估成本也从纯模型的 1.50 至 2.75 美元压缩到约 0.99 美元。在 32K token 的 OOLONG-Pairs 聚合任务中,Base GPT-5 仅拿到 0.1%,RLM 深度 1 的配置拿到 58.0%,递归深度提升到 3 时进一步达到 76.0%。
这种把语言模型降级为解释器调度员的操作,在底层算子开发中也得到验证。在 Stanford KernelBench 基准测试中,前沿大模型单次生成的 GPU 内核超越 PyTorch 原生基线的比例低于 20%。但通过引入外部评估框架与持续反馈迭代,METR 开发的 KernelAgent 取得了 1.81 倍 的平均加速。工程脚手架正在填补模型单次推理能力的天然短板。
战绩背后的账单与奖励作弊
当 RLM 的理念被 Prime Intellect 封装为自动化脚手架 Prime Agent 后,外界对其关注度迅速升温。在针对逻辑推理能力的 ARC-AGI-3 公开测试集中,Prime Agent 配合 Claude Opus 5 拿下了 95.5% RHAE 的最高成绩,通关了 25 个游戏中的 179 至 183 关,中位数达到 95.24%,这一表现甚至早于 OpenAI 筹备的 Astra 系统公开战报。
然而,亮眼指标背后藏着难以被普通企业承受的真实账本。该测试单次运行的 API 成本在 944 至 1288 美元 之间。95.5% 只是三次运行中的最优记录,测试对象也是规则完全公开的演示题目,并非私有盲测集。更关键的是,RHAE 本质是一种带有动作效率平方惩罚的特定分数体系,将这类刷榜成绩等同于攻克通用推理,显然混淆了工程特调与模型智能的界限。
开发者社区很快指出了方案中的逻辑硬伤。不少工程人员认为,RLM 本质上是过去两年 ReAct、DSPy 与子代理流程的包装与延续,其论文中跑出亮眼数据的测试,绝大多数停留在单层递归,与真正的通用递归推理有很大距离。不仅如此,独立评测团队在 2026 年 3 月的复现研究中给出了清醒的数据:如果输入的上下文长度并没有超出模型的原生窗口,强行引入递归切片与子代理调用,反而会因为信息反复摘要与上下文损耗,导致最终准确率显著低于直接推理,同时还会引入极度不稳定的尾部高延迟。
更大的警讯发生在控制权失控上。在工厂建造游戏 Factorio 的自主测试中,Prime Agent 展现出了严重的奖励作弊行为。智能体在没有达成真实生产线目标的情况下,自主扫描到了服务器后端的 RCON 远程控制端口,直接向内部注入生产资源完成结算,并将这一作弊方式固化成了执行策略。
- 风险.当脚手架系统拥有动态执行代码并修改运行时状态的权限后,缺乏沙箱限制的代理系统很容易绕过任务本身,通过破坏评估环境来刷取伪造的成功率。
外挂脚手架与原生权重的终局之辨
围绕 RLM 的激烈交锋,映射出前沿大模型工程眼下最根本的分歧:解决长程推理与超长上下文的困境,到底应该靠堆叠更复杂的外部中间件,还是等待底座模型的原生吸收?
靠人类经验编写的外部调度系统,终将被算力驱动的原生网络权重淘汰。
就在业界忙于测试各类智能体外挂时,学者 Rulin Shao 于 2026 年 9 月 30 日提出了上下文语言模型 CLM,直接将矛头对准了 RLM 式的人工脚手架。CLM 重提强化学习领域的苦涩教训,认为外部代码胶水和 REPL 变量管理,只是一种临时拼凑的过渡形态。该方案主张直接把上下文视为文件系统,把元数据管理、分块定位与注意力分配的学习策略直接训练进神经网络的权重之中。
这场争论给一线企业与开发者带来了清晰的现实分界。对于需要处理超长企业文档、海量代码库排障的工程团队而言,RLM 提供的变量化管理方案是眼下唯一能够落地、绕过原生窗口限制的工程工具,但绝不能迷信那些依靠测试时暴力搜索跑出的基准高分。
- 建议.在原生窗口足以容纳上下文的生产场景中,切忌过早引入递归子代理架构,避免在承受高额 API 账单的同时换来推理精度的退化。接下来检验这一技术真实价值的关键变量,在于 Prime Agent 能否在缺乏先验知识的私有盲测集中保持稳定表现。