在企业级数据库出现性能衰退时,技术团队通常习惯审视执行计划、索引设计或多版本并发控制(MVCC)的表膨胀。在刚刚举行的 POSETTE 2026 大会上,Sai Srirampur 发布了一组测试:面对 482 GiB 数据集与 33 亿行数据的随机更新负载,运行在本地 NVMe 上的 PostgreSQL 跑出了 16,030 TPS,而挂载 AWS 云盘(gp3 EBS)的同规格环境仅有 1,734 TPS,二者相差 9.24 倍。
这项测试给出的核心判断很直接:很多时候不是数据库引擎跑不动,而是底层的云网络存储在拖后腿。但在欢呼本地存储重回主流之前,工程师必须看清两个被测试语境掩盖的工程现实:这是一场拿物理满血 NVMe 对决未调优垫底云盘的非对称测试;将易失性的本地盘投入生产,必须引入沉重的集群多副本与网络确认开销。
拆解 36.9 毫秒:CPU 真正干活的只有 2 毫秒
在云上运维高并发 PostgreSQL 的工程师对这些症状绝不陌生:写入逐渐变钝、P95 延迟频繁抖动、autovacuum 追不上更新频率、checkpoint 引发周期性系统卡顿。这些问题表面上分布在引擎的不同模块,根源却常指向同一个环节——存储 I/O 队列积压。
测试选用的环境为 PostgreSQL 18.3,运行在 AWS 的 8 个 m6id.4xlarge 集群上(配置为 16 vCPUs、64 GiB 内存,shared_buffers 设为 16 GiB 并开启数据校验 checksums)。压测通过 64 个并发客户端对 482 GiB 的 pgbench_accounts 表执行 5 分钟的高并发随机更新。结果显示,本地 NVMe 的中位数事务延迟仅为 4.0 毫秒,而 EBS 组高达 36.9 毫秒。
当把 EBS 的 36.9 毫秒耗时逐层切开,事实显露无遗:读数据页用掉了约 19 毫秒,WAL 日志提交落盘(fsync)占用了 11 毫秒,锁与调度等待占了约 5 毫秒。双方在 CPU 上的纯计算耗时完全一致,都只有 约 2 毫秒。
关系型数据库以 8KB 页面为基础单元,当活跃数据规模超过内存储备时,每一次缓存未命中都会转化成对下层存储的实体调用。在采样快照中,EBS 实例有 45% 的工作进程卡在 IO:DataFileRead 状态,而 NVMe 仅为 14%。在 240 秒的剖析周期里,NVMe 宿主机累计消耗了 2,253 个 CPU 秒(相当于约 9.4 颗核心满负荷干活),EBS 主机却仅消耗了 251 个 CPU 秒(约等于 1 颗核心)。算力并没有超载,处理器的大部分生命周期都在空转等待云盘响应。
数据库没有在计算中耗尽算力,而是在网络存储的队列深处陷入停顿。
这种阻塞同样蔓延到了运维后台。在 10 GB 膨胀表的清理测试中,NVMe 耗时 366 秒完成 VACUUM,EBS 则需要 964 秒;处理 10 GB 的逻辑复制积压,NVMe 用时 139 秒,EBS 耗时 238 秒。前台写入与后台维护共用同一个存储配额,一旦 I/O 见顶,系统便陷入连环互锁。
跑分陷阱:十万级 IOPS 对决三千基线盘
9.24 倍的差距足够吸引眼球,但任何严谨的数据库架构师在评估这组数字时,都必须审视基准测试的对照条件。
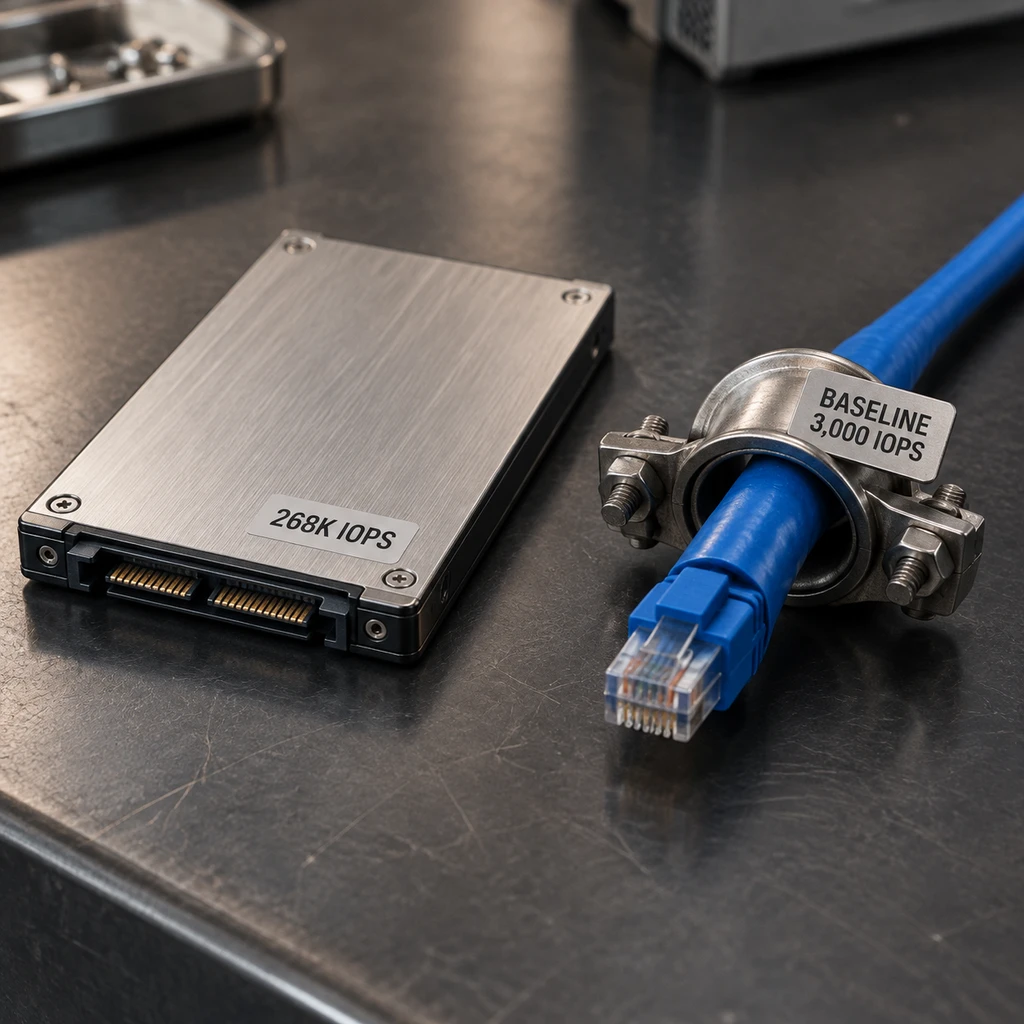
压测中使用的 EBS 是未经付费调优的基线 gp3 卷,被固定在 3,000 IOPS 与 125 MiB/s 吞吐量。反观 m6id.4xlarge 附带的单块 950 GB 本地 NVMe SSD,其硬件标称随机读取能力可达 268,333 IOPS,随机写入达 134,167 IOPS。用一块物理规格超过十万级 IOPS 的本地固态盘,去对比一条被云厂商限制在 3,000 IOPS 的默认网络卷,性能鸿沟原本就在工程预料之中。
| 存储方案 | 标称 / 配置 IOPS | 随机读取延迟量级 | 典型月存储成本 (1 TiB) | 数据持久性机制 |
|---|---|---|---|---|
| 基线 gp3 EBS | 3,000 (默认配额) | 毫秒级 (网络 RTT) | 包含在基础卷费用内 | 块存储服务原生多副本 |
| 调优 gp3 EBS | 16,000 - 20,000 | 毫秒级 (略有改善) | 约 161.92 - 186.92 美元 | 块存储服务原生多副本 |
| 本地 NVMe (实例存储) | 268,333 读 / 134,167 写 | 微秒级 (物理总线) | 绑定实例机型计费 | 易失存储,宿主机停机即清空 |
在 AWS 的真实计费体系中,gp3 单卷允许用户独立追加购买性能,最高支持 80,000 IOPS 与 2,000 MiB/s。受限于 m6id.4xlarge 宿主机自身的 EBS 物理吞吐上限,该机型外挂云盘的峰值为 20,000 IOPS 和 625 MB/s。如果工程师选择为云盘付费,将 1 TiB 的 gp3 规格配置提升至 16,000 IOPS / 500 MiB/s,每月存储支出大约为 161.92 美元;调优至主机上限 20,000 IOPS / 625 MiB/s,月费约为 186.92 美元。
只需每月增加不足两百美元的预算,EBS 侧的吞吐能力就能提升数倍。虽然受限于网络附加存储固有的毫秒级往返时延(RTT),调优后的 EBS 依然无法在微秒级延迟上与本地物理总线抗衡,但两者之间 9 倍的悬殊差距绝非不可逾越。测试更像是在证明:在极端 I/O 敏感型场景下,不花钱调优的默认云盘会成为整套架构最脆弱的短板。
消失的持久化:本地盘的“生产入场券”并不便宜
既然物理 NVMe 速度惊人,为何大多数团队依然选择将 PostgreSQL 跑在云盘上?答案在于工程权衡中的持久化边界。
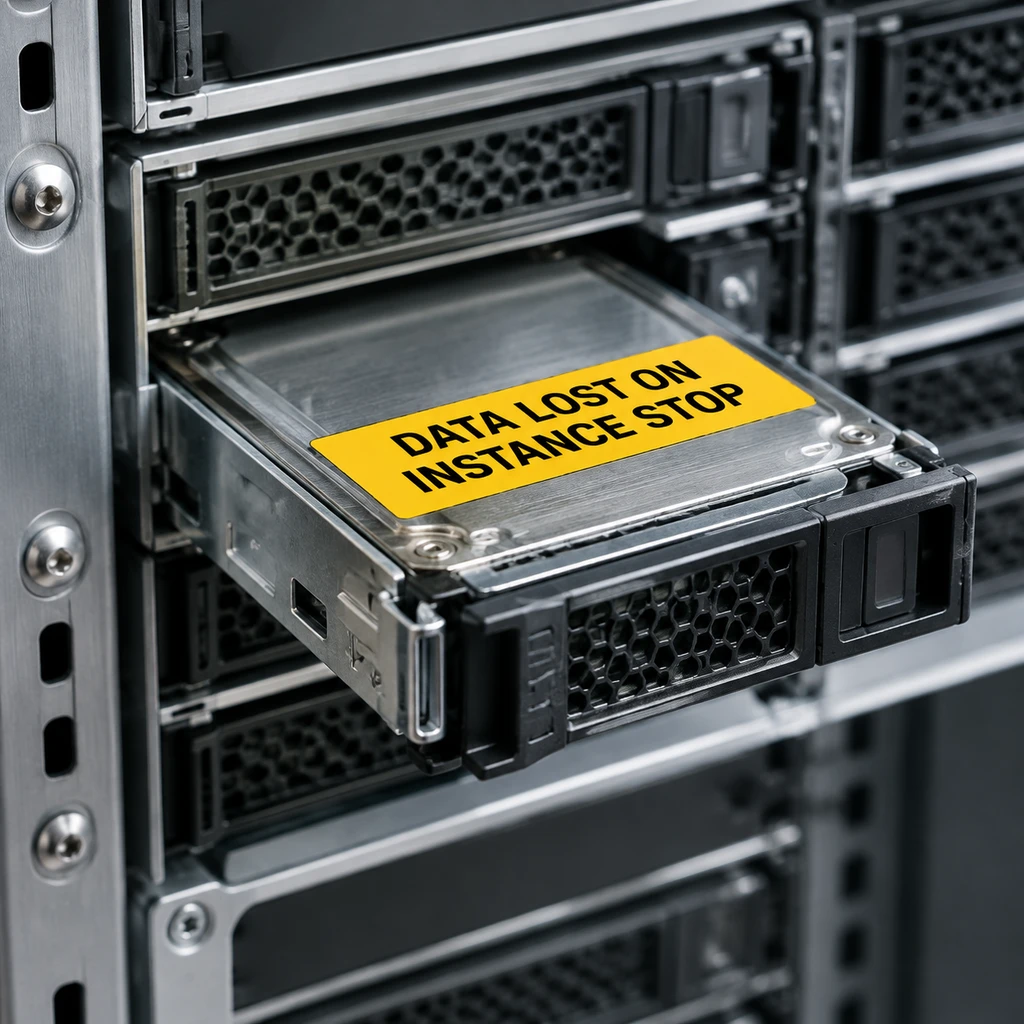
EC2 Instance Store 本地盘本质上是临时存储。只要云主机发生 stop、hibernate 或 terminate,本地数据就会被物理抹除,且无法像 EBS 那样通过云控制台或 API 瞬时打卷快照并挂载给新机器。在生产环境中采用本地盘,意味着必须抛弃云平台提供的存储层冗余保障,完全改由数据库软件层构建高可用拓扑。
演讲者给出的生产解法包括三个部分:跨可用区搭建一主两从的仲裁同步复制(配置 ANY 1 (standby1, standby2) 避免单一节点挂起拖慢全局)、使用 WAL-G 保持低延迟连续归档以争取秒级 RPO,并将冷备份转移至跨地域的独立故障域。Instacart 在搜索架构中落地了这套方案,Datadog 也在高吞吐场景下运行着类似的本地 NVMe PostgreSQL 实例。
这套架构确实具备生产可行性,但它把本属于云盘的底层开销转移成了显性的基础设施账单。当主库开启跨可用区同步复制时,事务提交不仅需要物理落盘,还必须等待网络传输和远端副本的确认,单机 NVMe 跑分中的 WAL fsync 极速优势会被跨区网络时延吃掉相当一部分。为了支撑这套容灾拓扑,团队需要常态化维持 3 台具备本地大容量 NVMe 的高端计算实例,伴随而来的还有跨可用区的数据流量开销与更复杂的备份恢复演练。
- 建议.当核心数据库遭遇性能瓶颈时,优先检查云监控中的读写排队与 I/O 延迟指标;如果预算允许,优先将 gp3 云盘配置调优至 10,000 到 20,000 IOPS,这通常是最平滑的解法。
- 风险.切忌在缺乏多节点同步复制与外部自动化归档的前提下,直接把生产环境迁往本地 NVMe;用业务数据丢失的隐患去换取跑分图表上的数倍吞吐,是高可用系统设计中的本末倒置。