数据库服务商 PlanetScale 正式推出了面向 Postgres 的全文检索扩展 TIN(Text INdex)v1.0.2,并在其托管平台与 Neki 数据库中作为正式商用版本全面上线。在官方公布的一组基准测试中,TIN 几乎以摧枯拉朽的姿态碾压了原生 GIN 以及当前风头正劲的 ParadeDB:在 85 GB、1.5 亿文档的混合检索场景下,TIN 跑出了 199 QPS 的吞吐,比 ParadeDB 快了整整 25 倍,构建索引耗时更是缩短到 8 分 10 秒。
把成熟的全文检索能力塞进关系型数据库,一直是系统架构中既诱人又凶险的尝试。表面上看,TIN 似乎打破了多年来 Postgres 文本检索要么慢如蜗牛、要么引入外挂引擎即引发写放大的技术僵局。但这并非一场无代价的算法突破,而是一次极为纯粹的低级硬件压榨与功能剪裁,其商业意图远比跑分数字本身更加现实。
撕掉中间层:TIN 是如何跑出反常吞吐的
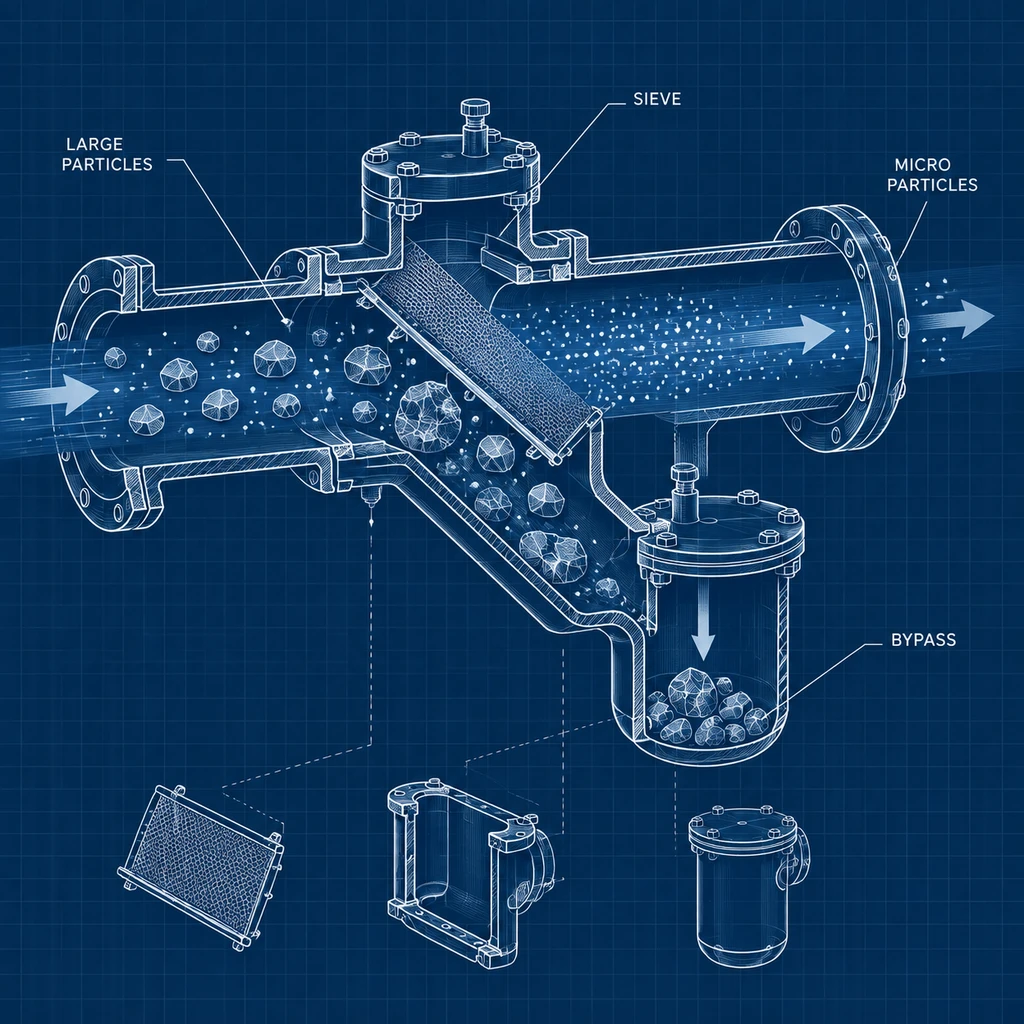
长期以来,Postgres 用户面对全文检索只有两条别扭的路径:使用内置的 tsvector 与 GIN 索引,或者挂载基于 Lucene、Tantivy 内核的独立扩展。GIN 索引在面对大规模短语查询与结果重排时效率骤降,甚至会在复杂析取查询中直接耗尽内存;而像 ParadeDB 这类封装了通用搜索内核的方案,则在底层架构上埋着天然的摩擦损耗。
通用搜索引擎依赖连续递增的文档编号(doc_id)来压缩倒排链,但 Postgres 依赖的是代表物理存储位置的 48 位元组标识符(ctid)。当通用引擎运行在数据库内部时,系统必须在每次读写与事务变更中,维系一套从外部 doc_id 到底层 ctid 的双向映射表。每一次写入、回滚与后台段合并,都会演变成剧烈的写放大与锁争用。
TIN 彻底抛弃了通用 doc_id。它将 Postgres 底层的 48 位物理元组地址(由 32 位页面号与 16 位行偏移量组成)直接写入倒排记录项,并利用 256 位页面级加行偏移量的二级位图来承载集合。
由于 ctid 具有全局确定性,TIN 的可变段在向不可变段合并时,完全不需要像 Tantivy 那样经历繁重的文档重排,而是可以直接复用已有位图。在底层运算上,TIN 将位图交集与并集计算全盘绑定至现代 CPU 的 AVX-512 与 AVX2 向量指令,并通过处理器的 POPCNT 指令直接求和。
硬件层面的直通与极简设计,带来了纸面上极其夸张的性能反差。
| 评估指标 | TIN v1.0.2 | ParadeDB v0.25.2 | pg_textsearch v1.4.0 | 原生 GIN |
|---|---|---|---|---|
| 85 GB 索引构建耗时 | 8m10s | 19m20s | 26m49s | 2h09m04s |
| 建索所需最低内存 | 32 GB | 64 GB | 128 GB | 64 GB |
| 索引文件体积 | 50.7 GB | 52.1 GB | 41.5 GB | 28.0 GB |
| 只读混合 Top-10 QPS | 199 | 7.9 | 无法完成 | 内存溢出失败 |
| 并发写读下 QPS | 125 | 2.2 | 3.5 | 内存溢出失败 |
测试表明,当客户端以每秒 1,000 次更新的高压写入时,TIN 仍完成了 270,279 次更新,且只读查询仅轻微降至 125 QPS;而 ParadeDB 在写负载介入后,只读吞吐从 17 QPS 暴跌至 2.2 QPS,延迟被拉长至 12 秒。
速度掩盖的妥协:高频词被剔除,词干提取缺席
如果单纯按照这份基准测试选型,技术决策很容易出现偏差。在极高的 QPS 和低延迟背后,TIN 在搜索质量与算法完整度上做出了不小的退让。
决定搜索可用性的从来不只有吞吐量,还有召回结果的真实精度与相关度。
首当其冲的是评分逻辑的失真。TIN 在默认配置下启用了稠密词忽略机制(dense-term elision):凡是在整个语料库中出现频率超过 10% 的高频词,在执行默认打分时会被系统直接忽略。在缺乏停用词过滤的中小型数据表上,这种粗暴的截断逻辑会导致大量常见词查询的得分全部归零,业务层必须手动介入并强制调用性能开销更高的底层全量打分。
与此同时,TIN 目前完全不支持词干提取(stemming),系统仅支持基础的 Unicode 分词、大小写折叠、重音折叠与 Emoji 索引。对于需要解析英文动词时态、复数变化或复杂形态学语素的业务系统而言,TIN 几乎无法提供符合用户直觉的召回质量。
官方公开的测试基准全部建立在 1,719 个由程序截取的子串上,只衡量了机器跑分下的吞吐与 p99 延迟,完全没有提供 NDCG(归一化折损累计增益)或 MRR 等业界衡量检索质量的核心指标。在真实世界的电商或内容检索中,高并发往往无法掩盖糟糕的长尾召回表现。
- 风险.基准测试环境深度依赖 AWS i7i 实例的本地 NVMe 与 AVX-512 指令集;若部署在标准网络云盘或缺乏高级向量扩展的 CPU 架构下,位图计算优势将被大打折扣。
闭源的内核,与平台绑定的商业护城河
更值得技术团队警惕的,是 PlanetScale 在产品分发上的封闭策略。
面对外界对测试结果的讨论,开源社区与竞品项目并没有完全买账。截至 2026 年 9 月 19 日,开源生态中没有任何第三方团队能够对 TIN 进行独立的生产级复现。竞品项目 pg_fts 甚至直接在对比矩阵中将 TIN 标记为不可测量(unmeasurable)并移出对照列表,原因很简单:生产级 TIN 根本不对外开放源码,也不提供独立的二进制扩展分发。
PlanetScale 在代码仓库中开源了一个名为 Lead 的兼容扩展,但这仅仅是一个用全表扫描模拟 TINQL 语法的玩具。官方文档直截了当地警告,Lead 绝不可用于任何生产环境或基准测评。
这意味着,团队一旦为了性能采纳了专有的查询操作符与接口,数据库就被死死钉在了 PlanetScale 的云平台上。想要在本地测试环境或私有云中搭建对等的数据栈,在工程上是不可能的。
在运维边界上,TIN 同样留下了不可忽视的隐形成本。由于底层设计缺乏对空间碎片的动态回收机制,TIN 索引文件存在明显的高水位线,在频繁执行删除或更新的场景下,膨胀的空间只能通过全量 REINDEX 才能释放。对于海量数据的分区表,TIN 的 BM25 词频统计仅在单个分区内独立运作,无法做到全局词频打分;而在只读副本上,由于深度依赖元组的物理稳定性,备库必须开启特定参数,在高写入回放压力下,查询极易直接触发 SQLSTATE 40001 异常而被强制取消。
- 建议.如果系统需要的是类似 Elasticsearch 的多列混合检索、分面聚合与细粒度分析,功能更全面的开源项目依然是更稳妥的选择;TIN 仅适合那些已被托管在 PlanetScale 之上、对吞吐极度敏感且检索模式固定的单一文本场景。