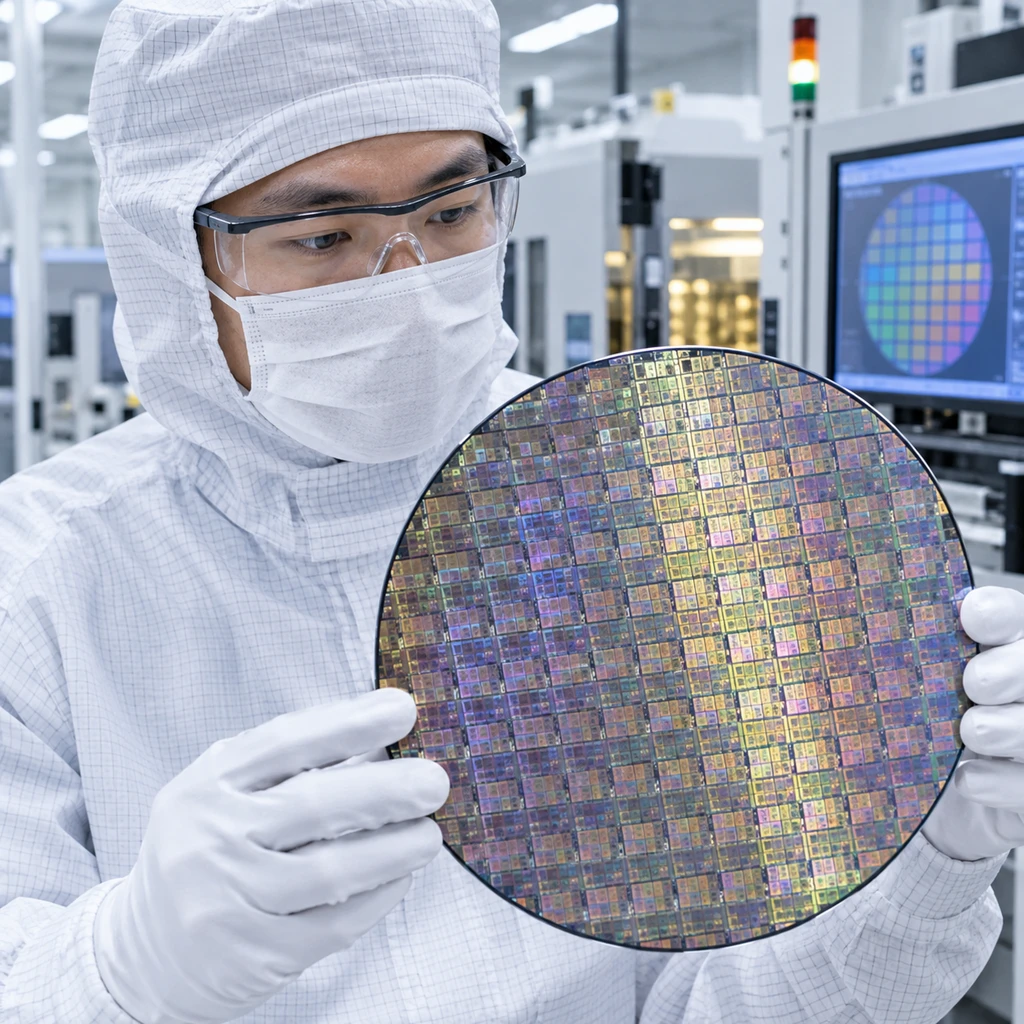
OpenAI与EDA龙头新思科技签署多年战略协议,联合研发名为 GPT-Synopsys 的专用芯片设计大模型。按照协议,OpenAI直接获得新思科技的底层软件授权,模型部署在OpenAI的基础设施上,目标不仅是读懂设计规范,而是让模型直接操控EDA工具链完成推理与验证;人类工程师退后一步,负责下发目标和最终审批。
两家公司承诺客户专有数据不会被拿去训练并进行加密隔离,目前早期测试已经在部分半导体客户中铺开,未来按联合商业化方案共享收益。
巨头的硬件全链路
把 GPT-Synopsys 仅仅看作一个帮芯片工程师写脚本的辅助工具,低估了OpenAI的真正意图。这家软件巨头正在把触角伸进半导体供应链最上游的软硬件交汇处。
更早前OpenAI已经与博通达成协议,锁定了高达 10吉瓦 的自研AI加速器部署计划,首批机架预计在2026年下半年进场,全套基础设施要在2029年底前全部交付。双方联合开发的首款定制推理ASIC芯片Jalapeno,做到了光罩极限尺寸,整个研发流程压缩在惊人的 9个月 之内。
要支撑起如此庞大的定制芯片算力,不能只靠向博通提需求。软件巨头正在试图掌握从模型演进、工具开发到芯片实现的整套自给自足能力。
- 结论.买现成GPU是解决眼下算力荒的权宜计,把手伸进EDA底层做软硬一体协同,才是争夺长期算力主动权的真正底牌。
阵营冷战与生产率竞赛
芯片设计自动化市场常年由三巨头垄断,当AI大模型介入这个专业垂直领域时,厂商之间的结盟格局迅速割裂。
新思科技在多智能体工作流的早期测试里,拿出了工程生产率提升 2至5倍 的实际案例。但竞争对手的动作更快、口号更激进。Cadence联合英伟达推出了基于Nemotron大模型的ChipStack,直接打出虚拟芯片工程师概念,宣称在SoC物理设计流中达成 5至10倍 的交付加速,并优化最高20%的性能、功耗与面积指标。
西门子EDA同样倒向英伟达,基于Nemotron与MCP架构开发了Fuse EDA智能体,试图贯通从半导体、3D封装、PCB到制造签核的全套自主流程。
一边是算力霸主英伟达借Cadence与西门子EDA稳固防线,另一边是OpenAI与新思科技联手开辟独立阵营。芯片设计工具的竞争,已经演变成前沿大模型提供商的正面交锋。
零容错防线与数据顾虑
无论商业演示看起来多么诱人,半导体工程社区对纯靠模型直接生成芯片的提法依然非常冷淡。
芯片流片是一场赌注极大的物理测试。一枚先进制程芯片的流片花费动辄数百万美元,普通大语言模型只要达到85%的可用率就足以让软件开发者欣喜,但在物理硬件制造面前,85%的准确率意味着 100%流片失败。
差之毫厘便会导致数百万美元打水漂,硬件工程从不接纳概率性的妥协。
在专业工程师社区的实际讨论中,AI确实能大幅提高编写胶水脚本和定位长日志错误的效率,但在复杂的时序收敛与物理排错中,模型偶尔给出的误导性结论反而让工程团队浪费过数周排查时间。AI给出的代码,最终仍需要人类专家承担极度繁琐的Sign-off签字确认责任。
现阶段芯片AI测评体系也存在严重脱节。开源基准ChipBench主要在测代码文本的生成与基本排错,而需要调用Yosys和OpenSTA这类真实工具链去验证物理逻辑的Chip-Bench,受关注度反而受限。行业缺乏公认的确定性衡量标尺。
更现实的阻碍来自商业机密。半导体设计商的专有RTL代码、代工厂不可外泄的工艺设计套件(PDK)以及精确时序约束,是一家公司的立身之本。即便OpenAI与新思科技申明不用于训练且加密存储,但将这些命脉资产上传至第三方的托管云环境,依然会让主流晶圆厂和设计企业非常谨慎。
- 风险.如果不能打消代工厂和一线设计企业对核心数据泄露的担忧,再聪明的模型也只能被锁在辅助外围,难以进入核心签核流程。
大模型接管复杂系统的尝试正在走向分水岭。从写出看似合理的代码,到在物理现实中造出一颗零缺陷运行的晶体管集群,概率智能面对的不再是友好的输入框,而是毫无容错余地的物理法则。