YC S25 孵化项目 Magnitude 正式在 Hacker News 公布了其开源本地推理引擎,宣称凭借本地即时调优内核,运行开源模型的速度最高可达 llama.cpp 的 2 倍。在官方给出的测试图景中,该引擎在苹果 Metal 架构上的解码速度领先 92%、预填充提速 9%,在英伟达 CUDA 环境下也有两成左右的增益,同时提供无缝接入 Pi、OpenCode、Hermes、Codex 等编程智能体的一键桌面应用。
这一宣称迅速点燃了本地开发者社区的关注,但也很快撞上了真实测试的坚硬墙壁。深入其代码仓库与底层架构会发现,Magnitude 远非凭空自研出了一套革命性的算子底座,而是基于现有开源生态包裹出来的一套硬件配置控制面;而在真实多样的设备与多轮交互链路中,这层尚未磨合充分的外壳正暴露出剧烈的性能反噬与稳定性漏洞。
跑分翻倍的宣传,与M4芯片上反慢6倍的落差
Magnitude 背后是由 CEO Tom Greenwald 与 CTO Anders Lie 组成的双人团队。两人分别毕业于东北大学和爱荷华州立大学计算机系,此前分别担任过智能安防品牌 SimpliSafe 的特别项目负责人与 AWS 软件工程师。项目拿到了 50 万美元的 YC 标准投资,涵盖 12.5 万美元换取 7% 股权以及 37.5 万美元的无上限 MFN SAFE 协议。
在拿到这笔注资前,团队已经历了两次转型。项目最早名为 Sidekick,随后关联 Sagekit,主打基于视觉优先的浏览器自动化测试;在几度调头后,团队才彻底重构方向,转切本地推理引擎赛道。
官方公布的基准测试给市场画了一张诱人的图景:利用自优化机制,在苹果芯片与英伟达显卡上全面超越统治本地生态近两年的 llama.cpp。然而,官方并未公布支撑这组测试的具体硬件型号、模型规格与量化参数基准。
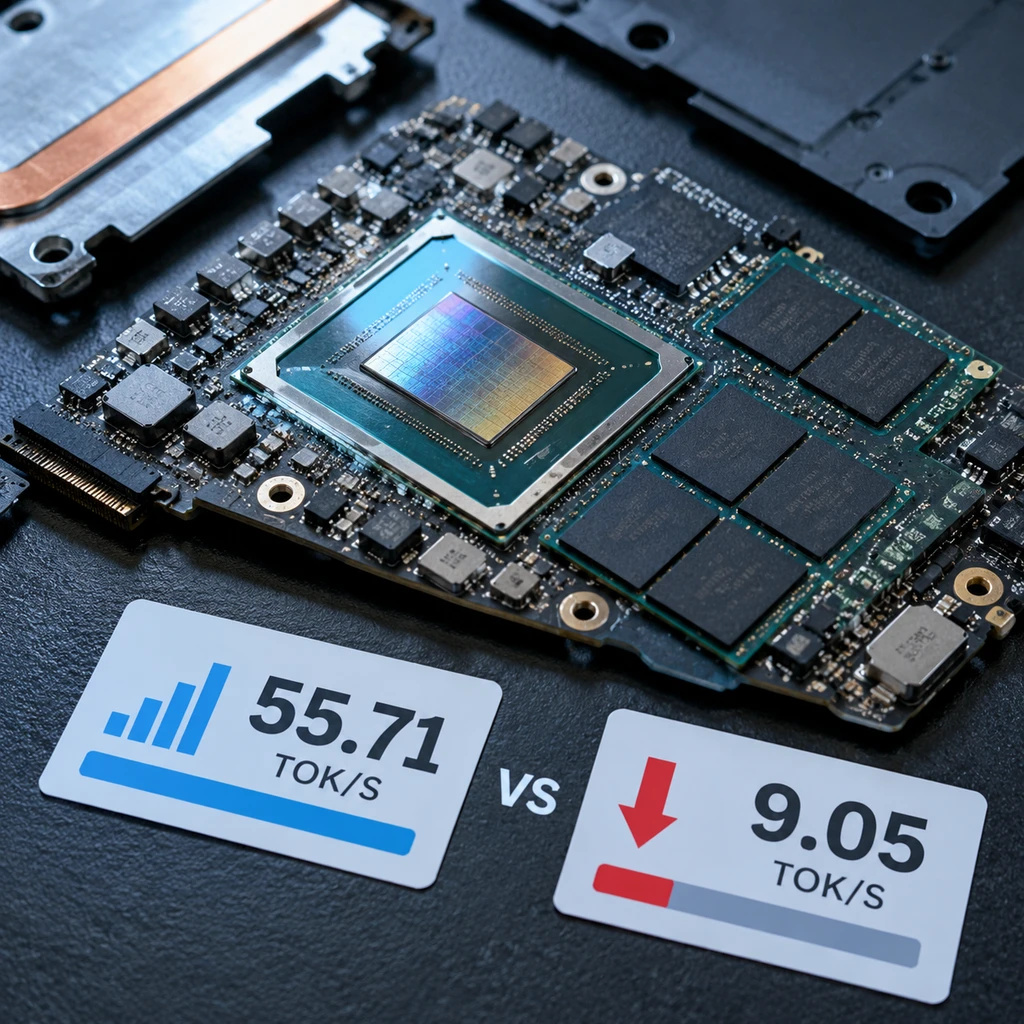
这种模糊很快在实机环境被击碎。在项目代码库的第 82 号议题(Issue #82)中,开发者贴出了极具讽刺意味的对照:在最新的苹果 M4 芯片设备上加载 Gemma 4 E2B Q4 GGUF 模型时,Magnitude 的解码速度跌至仅 9.05 tok/s,预填充速度为 36.6 tok/s;而在完全一致的硬件与权重条件下,原生 llama.cpp 的解码速度高达 55.71 tok/s,预填充为 82.0 tok/s。
宣称领先两倍的引擎,在旗舰硬件上反而比老将慢了整整 6 倍。这表明 Magnitude 的设备调优层在遇到新架构芯片时,极易发生静默回退,导致计算负载未能正常交给硬件加速,反而跌入未经优化的低效路径。
剥开算子外壳:所谓自优化本质上是自动化调度
外界容易将设备上调优误读为类似 PyTorch 2.0 编译期内核自融合或新算子体系。但查验 Magnitude 的技术栈可以发现,它目前依然建立在既有成熟生态之上。
其代码仓库当前直接嵌套了 llama-cpp-rs 子模块,核心逻辑是用 Rust 语言为 llama.cpp 运行时封装一层应用级控制台。团队正在推进一项基于 TileLang 的架构重写,意图通过它来统一生成针对 NVIDIA CUDA、AMD ROCm/HIP、Apple Metal 和 CPU 的底层算子。但截至目前,这套全新的后端仍在开发完善中。
在当前的交付形态中,Magnitude 展现出的核心能力不是改写算子,而是将本地运维流程产品化。官方宣称每个智能体内存占用减少 27%,并通过复用前缀缓存加速多会话并发,空闲时自动将权重从显存卸载。
以往开发者在本地部署一个 Coding Agent,需要手动计算显存分层、排查上下文长度截断并配置反向代理网关。Magnitude 真正做的事情,是通过一套自动探查硬件特性的外壳,省去了这套手动试错流程。但问题在于,一旦底层算子调用依旧依赖外部绑定,而自身调度逻辑又与芯片架构发生冲突,这层包装就会直接抹平所有收益。
跑分比拼的是单轮输出的极速,而智能体落地依赖的是多轮交互的长久韧性。
单轮跑分跑通了,但长流程协议正在崩塌
如果只是推理性能偶发倒挂,尚且属于早期软件的适配阵痛。但对于专为 Coding Agent 定位的引擎而言,更致命的短板发生在模型生成之后的协议栈交互上。
编程智能体不同于单纯的问答聊天框,它需要高频调取终端、读取文件树并在长达数万 Token 的上下文间频繁切换。在这一过程中,引擎必须严格维护对话模板、WebSocket 连接保活以及精确的工具调用输出。翻开 Magnitude 的问题跟踪列表,复杂工程链路中的脆弱性正在集中暴露:
- 协议轮替损坏.在加载 Ministral-3-14B 等模型执行多轮工具调用时,引擎内部对严格对话模板的上下文维护出现错位,直接导致智能体在第二轮交互时无法解析指令。
- 高强度请求网关报 502.在密集代码审查或大规模重构触发的长文本场景下,引擎内建的本地网关频繁超载,直接断开 HTTP 会话。
- 内存异常泄露.针对 Codex 的 WebSocket 链路中,由于未能对传输流的压缩编码进行规范化清洗,导致客户端内存持续暴涨直至进程终止。
- 异构环境失灵.部分 Intel 架构的 Mac 设备启动后陷入无限挂起,而多卡工作站环境则无法正确识别与分配辅助 GPU 资源。
- 风险.如果项目强依赖多轮工具调用的复杂 Agent 工作流,切换至该引擎可能遭遇长文本会话中途断裂或协议解析错误,建议在生产环境中维持原生 llama.cpp 或 Ollama 架构。
算子神话落幕,本地推理步入工程沉淀期
本地推理市场正在经历一场心智转换。过去一年多里,llama.cpp 凭借扎实严谨的 C/C++ 实现构建了稳固的护城河,Ollama 则凭借极简的命令行打动了大众开发者。后来者想要从二者口中夺食,极易走向两个极端:要么夸大几项特定硬件上的峰值吞吐,要么将配置调优包装成架构突破。
Magnitude 的产品定位准确切中了当前开发者的痛点:大家确实需要一个免去繁琐配置、原生支持前缀缓存并能即插即用接进编程助手的本地推理后端。但它目前呈现的状态更像一个被资本与发布日程催熟的中间态产物:外壳做得很轻,底座却尚未夯实。
- 结论.对于本地开发者而言,无需为其跑分光环支付迁移成本;对于 Magnitude 团队而言,摆脱对 llama.cpp 的 Rust 缝合、用 TileLang 稳固跨芯片算子,并在不崩溃的前提下走完 Agent 多轮交互,才是决定它能否生存下来的真正分水岭。