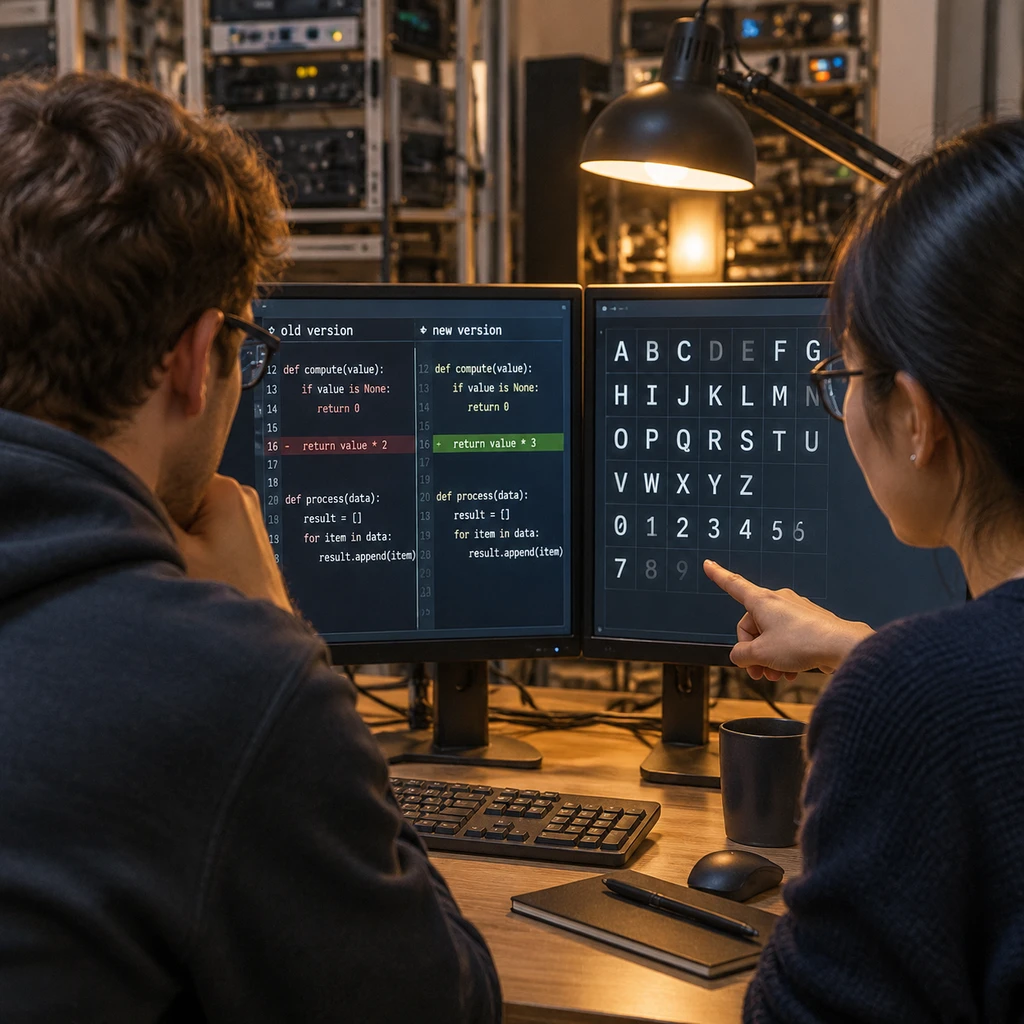
往 Git 仓库里提交过 PDF 架构图或 WOFF2 网页字体的人,都见过那句冷冰冰的 Binary files differ。开发者 ivankovic 刚刚开源的 Rust 差异对比工具 OmniDiff(要求 rustc 1.92 及以上版本,采用 AGPL v3 许可证),直接把这层黑盒捅破了。它不仅能对 25 种编程语言做局部高亮对比,还能在终端里拆开对比图片、光标、字体、归档文件、消息目录和 PDF。
项目主页挂出的成绩单相当唬人:处理 99.95% 的代码变更、98.8% 采用内容特定算法,在配备 Intel Core i7-1370P 和 32 GB RAM 的 T14s 笔记本上,98% 的代码对比耗时低于 100ms。但如果顺着仓库底层的溯源文档往下翻,你会发现这套数字完全是另一回事。
把二进制黑盒拆成明账
传统的 GNU diff 和默认 git diff 只认文本行。遇到 Python 重构把变量挪个位置,旧工具会把整行标红删掉再整行标绿重画;OmniDiff 则利用 Tree-sitter 语法树,只高亮真正改动的 sum(numbers) 和 len(numbers),并标出变量属于移动而非重写。
更抓人的是它对富媒体和二进制资产的拆解能力:
- 改了 PDF 流程图里的一个方框名字,它直接列出元数据与第 1 页发生变动,并在查看器里并排框出改名前后的那个方框。
- 更新了 Font Awesome 的 WOFF2 字体包,它能报出 21 处成员变更,把版本号变动和重绘的 20 个图标字形排成网格逐一描边对比。
- 速度方面,在包含 2,302 个测试样本的基准测试中,其中位耗时仅 4.2 ms,p99 为 177 ms,97.6% 控制在 100 ms 内。
这套工具支持终端 TUI 交互、无头批处理和 JSON 输出,还能直接挂载为 git difftool 或 Jujutsu(jj)的后端,同时提供了 VS Code(兼容 Cursor、Windsurf)和 Neovim 插件。
拆解 99.95% 的跑分神话
很多开发者扫一眼 README 顶部,会以为 99.95% 是对比准确率。古人讲“名与实爽,则轨度易”,名号一旦和实情错位,判断标准就会走样。
我更在意的是仓库底层基准测试文档里交代的真实口径。那个 99.95% 其实是完成率:在涵盖 25 种语言的 442,530 个可读代码对中,作者把单进程限制放宽到 120 秒限时和 6 GB 内存上限,最终跑完 442,322 个,出现 96 次超时和 112 次爆内存,而且分母里提前剔除了 1,669 个不可读样本。换成日常开发场景,等一个文件 diff 超过两分钟或者吃掉 6 GB 内存,早就跟卡死没区别了。
另一个 98.8% 内容感知比例,测的也不是二进制专用算法触发率,而是文件类型覆盖率。它在 7,352 个仓库的 2,018,010 次变更统计里,把最普通的纯文本处理也算进了内容感知;如果限制单个大仓库最多贡献 1,000 次变更,这个数字会降到 98.2%。至于表格里扎眼的 PDF 100% 准确率,旁边的注释承认,经过人工评判的 PDF 测试用例总共还不到 10 个,且 100ms 内跑完的比例只有 57%。
把六千兆内存的不崩率当准确率看,是读开源跑分最容易踩的坑。
真正衡量代码对比好坏的,是作者用 1,419 个人工手绘字节级基准真相(ground truth)算出来的视觉重合度。在这套严苛标准下,OmniDiff 在默认的 --minimal 预设下只有 69.6% 零错误字节(即表格四舍五入的 70% 完美),以及 91.5% 错误字节不超过 1%(对应 92% 接近完美);一旦切到 --full 全量预设,这两个指标就会掉到 60.0% 和 87.5%。项目文档自己也写得很清楚,距离作者设定的 90% 完美和 99% 接近完美的目标,现在还没摸到边。
选工具先看清牌桌
这个项目之前曾用 CodeDiff 的名字在 Hacker News 露面。在最近的讨论里,作者晒出另一组数据:在 Difftastic 支持的变更子集上,OmniDiff 拿到了 90% 完美加 5% 接近完美,而同类工具 Difftastic 只有 64% 加 17%。
为什么首页是 70%,到了评论区变成 90%?因为统计分母被缩窄到了特定子集,且区分了语法树匹配和视觉高亮的计分规则。把 Rust 社区这几款主流工具摆在一起,边界其实非常清楚:
| 工具名称 | 核心技术机制 | 二进制拆解 | 开源协议与商业模式 |
|---|---|---|---|
| GNU diff | 文本行对比,生成标准补丁 | 不支持 | GPL(系统基础设施) |
| delta | 下游渲染美化,不改底层逻辑 | 不支持 | MIT(宽松开源) |
| Difftastic | Tree-sitter 语法树结构对比 | 不支持 | MIT(大文件易受内存限制) |
| OmniDiff | 语法树对比 + 专用二进制解析 | 支持图片/字体/PDF等 | AGPLv3 + 商业订阅许可 |
不管是 Difftastic 还是 OmniDiff,它们干的都是给人类减轻代码审查负担的活,不负责生成供自动化脚本合并的标准补丁(patch)。真要把它们当成 GNU diff 的底层替代品塞进自动化流水线,脚本多半会直接罢工。
我更留心的是它背后的许可证算盘。从早期的 PC 共享软件到今天的 Rust 命令行工具,开发者工具一旦跨过个人玩具阶段,总会撞上变现难题。delta 和 Difftastic 都选了极度宽松的 MIT 协议,甘当社区基础设施;OmniDiff 却直接挂出传染性极强的 AGPLv3 协议,并同步售卖商业订阅许可。
- 风险.企业效能团队如果看中它的 PDF 和字体对比能力,想把 OmniDiff 集成进内部托管的 CI/CD 平台或网页版 Code Review 服务,就会立刻触发 AGPLv3 的传染条款,要么开源整个内部平台,要么乖乖掏钱买商业授权。
对于个人开发者,装个二进制包在本地终端里跑 git difftool,终于不用再对着一句冷冰冰的 Binary files differ 猜谜,这笔账怎么算都划算。至于它能不能在代码结构对比上真正兑现 90% 完美准确率的承诺,等独立第三方拿同样的数据集和 Difftastic 同台跑一轮,底牌自然就亮出来了。