客服分流、工单退款判定、风控拦截,这类业务根本不需要让几百亿参数的大模型吐着字思考两秒钟。开源项目 Ollaya 在 2026 年 9 月 23 日正式建库,以 Rust 守护进程与命令行工具的形式开源,遵循 Apache-2.0 协议,直接把目标对准了 TypeSafe 旗下的闭源决策模型 Jev。它把决策模型的使用门槛压到了一条指令,甚至连接口规范都完整复刻。
但如果你以为改一行环境变量就能在本地免费白嫖商业级判别服务,往往会栽进工程落地的深坑里。
8.9 毫秒背后的非自回归架构
大模型做判别最让人头疼的是自回归机制:一个个词往外蹦,延迟很容易飙到几百毫秒甚至数秒。Ollaya 运行的核心模型 Laya 来自 Convai Innovations,底层采用的是非自回归编码器架构。它通过单次前向传播直接输出类型化决策,没有生成过程,天然避免了冗长输出和幻觉格式。
模型体系划分得很克制:英文主模型 laya 基于 421M 参数的 ModernBERT-large,多语言版本 laya-multilingual 基于 322M 参数的 mmBERT-base,另有一个同为 421M 参数的专精版本 laya-typed-decisions。软件支持 macOS、Windows、Linux 与 Docker,并在 Linux、WSL 2 和 Docker 镜像中通过 CUDA 13 调用 NVIDIA 显卡。
在 RTX 4090 显卡上,Laya 官方宣称端到端五问题并发请求仅需 8.9 毫秒。根据独立 CUDA 实现 laya-cuda 0.1.0 在 Windows 11 环境下的实测基准,83 个 token 的短请求 P50 延迟在 2.3 至 2.4 毫秒;在 1024 token 的全上下文压力下,laya-typed-decisions 的 P50 延迟为 9.6 毫秒,P95 延迟为 9.9 毫秒。不过需要指出,官方宣称的 8.1 毫秒多语言测试在公开测试集上尚未完全复现。在算力偏弱的 NVIDIA T4 上,单问题推理耗时在 33 至 39.5 毫秒之间,但在批量请求下摊薄到每个问题约 7.2 毫秒。
相比之下,闭源服务商 TypeSafe 的托管 API 直连延迟为 313 至 381 毫秒,P90 达 423 毫秒;如果通过 OpenRouter 这类第三方路由网关转发,P50 会放大到 734 毫秒,P90 甚至飙至 1739 毫秒。单纯对比数字,本地运行的优势几乎是压倒性的。
协议兼容之下的两处暗礁
Ollaya 在接口设计上做得很聪明。它完整支持 TypeSafe 的 /v1/systemone 与 /v1/models 路由,甚至能直接适配官方 Python SDK 0.7.1,只需重定向本地端口就能跑通请求。
这种无缝切换给工程团队制造了一种可以立刻平替的错觉。两套系统在算法底座和输出语义上存在着根本性断裂。
第一处暗礁是置信度口径失真。判别模型虽然不会像生成模型那样凭空捏造长句子,但依然会自信地给出错误分类。Laya 的置信度计算基于预测概率分布的信息熵,官方已明确指出其原厂输出存在过度拟合与过度自信的偏向;而 Jev 的计算逻辑基于预测分布的集中度。这意味着,如果你把原先在 Jev 上调校好的阈值(比如置信度大于 0.90 执行退款)直接套在 Laya 上,业务逻辑很可能会发生崩塌。要在生产中使用 Laya,企业必须准备自己的验证集重新做温度缩放标定。
协议兼容只替换了外壳,未做温度标定的置信度无异于盲目自信。
第二处暗礁是零样本泛化能力的鸿沟。TypeSafe 的 Jev 底层依赖大规模基座训练,零样本冷启动表现扎实。而 Laya 只有 4 亿参数规模,其未经微调的基线模型在统一决策基准上的准确率仅为 0.362。
尽管专精微调后的 laya-typed-decisions 在综合评估中回升到 0.766,并且在 AG News 新闻分类能达到 0.947、BoolQ 是非问答能达到 0.830,但它依然无法掩盖小编码器面对多变业务时的脆弱性。没有下游标注数据的冷启动场景下,直接换用 Laya 几乎等同于精度跳水。
算力账单与工程代价的转移
古人云:橘生淮南则为橘,生于淮北则为枳。技术栈的迁移从来不是简单的数字替换,而是成本结构的变化。
TypeSafe Jev 的计费方式是典型的云端模式:每 100 万输入 token 标价约 0.042 美元,输出 token 免费,且同一个请求里并行判定 5 个问题耗时几乎不变。对很多早期团队而言,这种调用模式花不了几个钱,最大的价值在于开箱即用、免维护。
转到 Ollaya,表面上看 Token 费用归零了,敏感的客服邮件和工单数据也全部留存在私有服务器内。但隐藏在账单背后的工程负担转嫁到了团队身上:
- 风险.团队必须具备完备的数据清洗、标注、特定领域模型微调以及温度校准流水线,否则 400M 参数的基座无法稳定胜任复杂分类。
此外,Ollaya 项目刚刚起步,其底层运行时仍在紧急修复 CPU 融合注意力机制、GGUF 与 llama.cpp 后端适配,以及量化后 logits 输出稳定性等问题,离企业级高可用网关仍有差距。
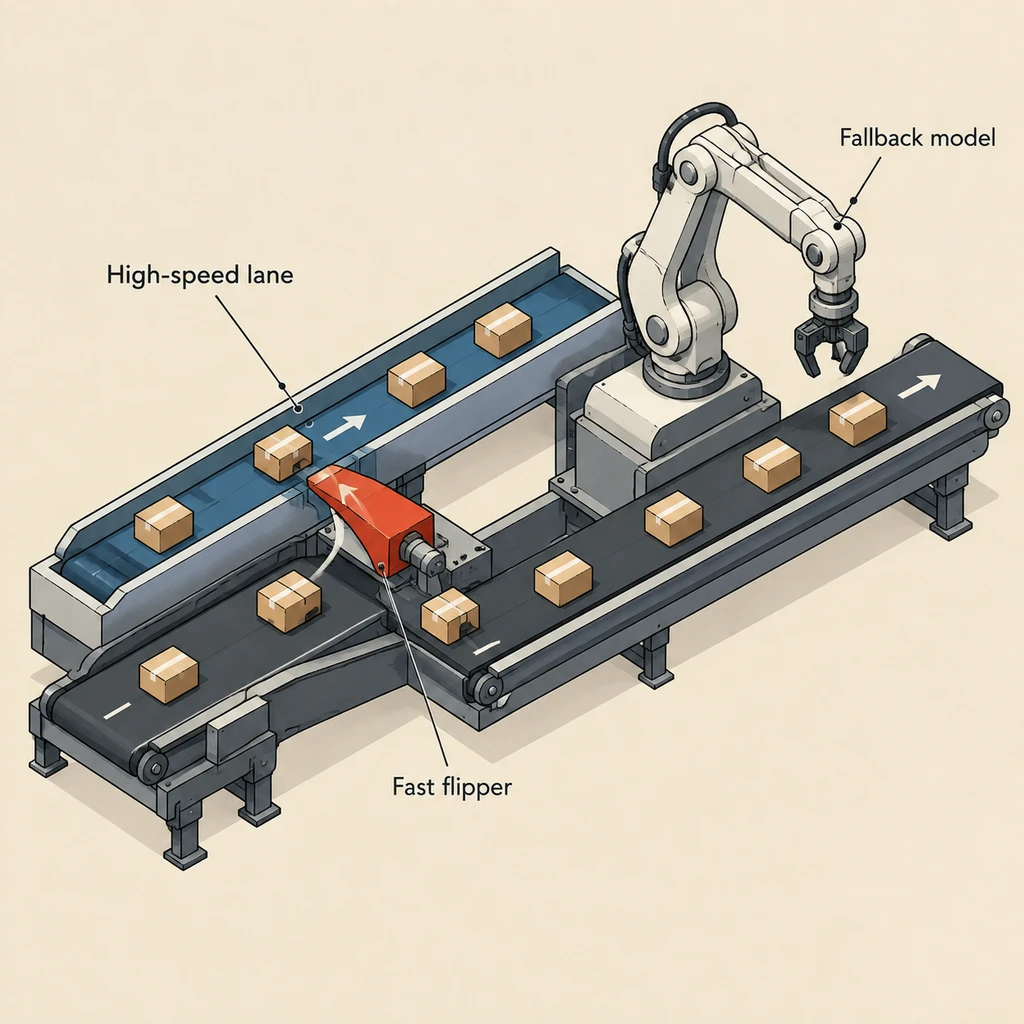
真正务实的系统架构,往往不是单点替换,而是形成分层路由。
- 建议.将经过领域微调的 Ollaya 部署在最内侧,承担前置的毫秒级高吞吐初筛;对大部分置信度达标的高频常见请求直接放行,仅在遇到长尾罕见场景与低置信度判定时,再将请求回退给公网的 Jev 或更大规模的生成式大模型。
大模型负责深度推理,小编码器负责闪电决策。Ollaya 并不是要彻底杀死商业 API,而是让开发者多了一把能将高频分类开销压到极致的手术刀。但这把刀够不够锋利,考验的不再是模型供应商,而是使用者的工程功底。