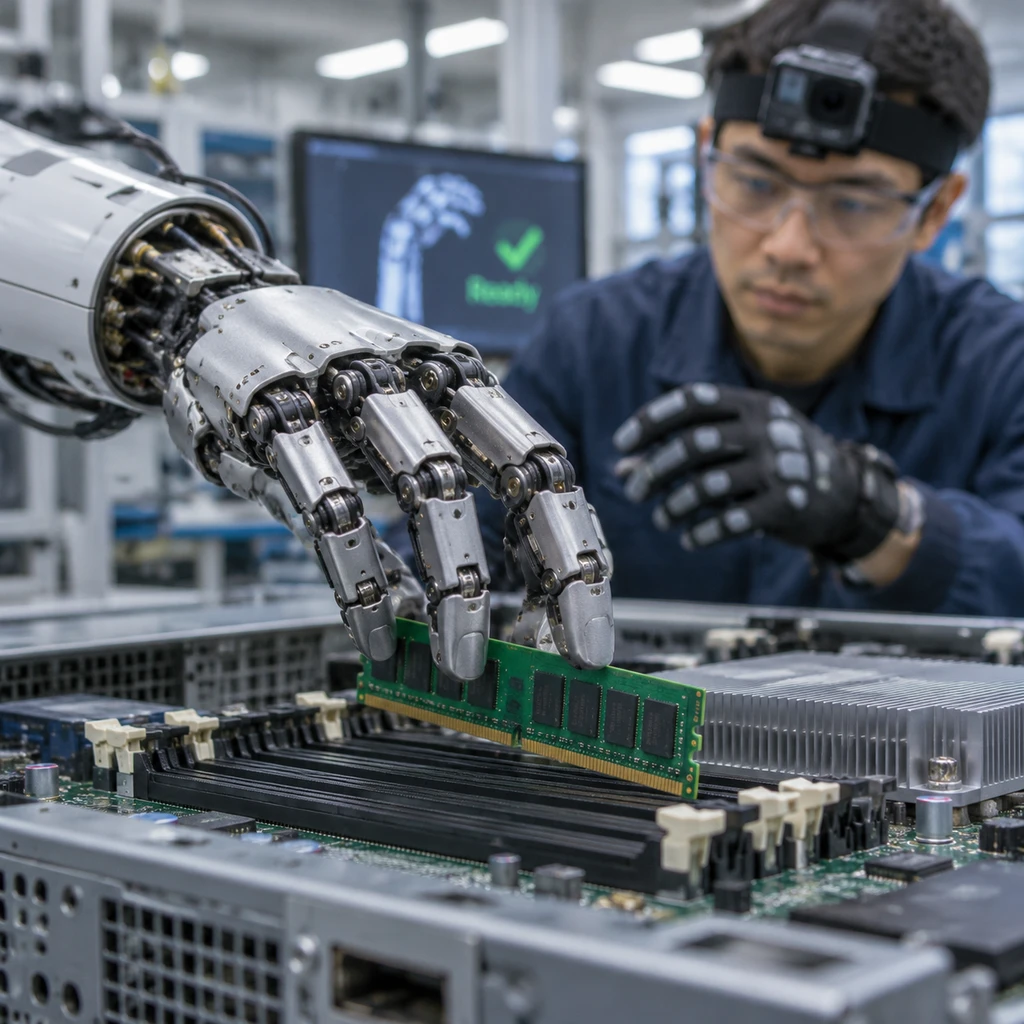
英伟达在 2026 年 11 月 9 日的 CoRL 会议上拿出了第二代机器人基础模型 GR00T 2。面对具身智能行业最头疼的真机数据荒,英伟达放弃了上一代直接把图像和语言翻译成电机指令的视觉-语言-动作(VLA)路线,改用世界-动作模型(WAM)。新模型在 402,730 小时的人类第一视角视频上做预训练,先在画面里把人手替换成机械臂、脑补出接下来几秒的视频变化,再倒推出控制指令。在实验室里,这套机制让五指灵巧手在没有专门遥操作训练的前提下,完成了划火柴、切香蕉、往传送带上抛包裹,并以 85% 的成功率插装好 GB300 内存模块。
但如果你顺着部分外媒的转述,以为机器人从此看几眼人类视频、花 3 分钟训练就能以 95% 的可靠性直接进厂打工,那就踩进了公关叙事的坑里。翻开英伟达公开的一手技术报告,所谓的不到 3 分钟仅仅是为单个任务采集 5 次真机演示样本的时间,背后还得在单张 RTX 5090 显卡上跑满 30 分钟的 LoRA 微调;更重要的是,GR00T 2 的预训练底座依然老老实实喂进了 23,500 小时的真机遥操作数据。人类视频成了极好的能力放大器,却远没有让昂贵的遥操作团队下岗。
为什么放弃直接翻译动作,要在中间塞一段视频脑补
此前主流的机器人模型(包括 Google 的 RT-2、Physical Intelligence 的 π0.5 以及英伟达自家的 GR00T 1)都走 VLA 路线,试图让模型看到摄像头画面、听懂一句话后,直接输出机械臂各个关节的旋转角度。这条路线的死穴是极其挑食:人类拍的视频里只有画面变化,没有电机力矩和关节参数,VLA 模型很难直接拿来用;而不同厂家的机械臂自由度和夹爪长相各异,A 机器人摇手柄攒下的数据,换到 B 机器人身上往往就成了废品。
GR00T 2 换成了扩散 Transformer 架构,把问题拆成两步。收到语言指令和当前画面后,它先用扩散模型生成一段未来几秒的预测视频——哪怕训练时看的是戴着头戴相机、数据手套或手指外骨骼的人手动作,模型也会在预测画面里把人手脑补成目标机器人的机械臂,随后再通过一个轻量级的特定机器人适配头,把这段视觉轨迹翻译成底层电机指令。
这种先想象画面、再推导动作的做法,真正改写了具身智能初创公司的数据采集账本。以前为了训一个新动作,工程师得一对一遥操作真机几百个小时;现在英伟达证明,把人类视频从零扩充到 40 多万小时,能让 72 项真实机器人任务的执行进度直接从 50% 跳到 70%。英伟达顺手把其中 100,000 小时的人类视频打包成 Human-1M-100K 数据集公开开放,相当于给全行业发了一笔免费的视觉预训练口粮。
人类视频解决的是先迈哪只脚的步骤逻辑,真机数据解决的才是怎么使劲的物理控制。
哪怕有了 40 万小时人类视频,GR00T 2 也没有凭空变出控制能力。在它的数据配比里,除了人类视频,还硬性塞入了 10,184 小时的手持通用操作接口(UMI)夹爪演示,以及 23,500 小时的真机遥操作数据。至于完全不靠真机动作、纯看人类演示学会干活的实验,技术报告里只敢在小范围的 Dexter 机器人上列出 4 项化学实验室任务(每项测试 20 次)。在 50 项未见过的适应性任务测试中,模型零样本直接上手的平均成功率只有 40%;给它看 1 次真机演示能涨到 71%,看满 5 次演示并跑完半小时显卡微调,才真正摸到 95% 的及格线。
另外需要帮读者排掉两个外媒转述中的信息噪音:一是部分报道称模型在超 1000 颗 GB300 芯片集群上训练,并搭配了 OpenAI 的 GPT-6 Astra 语言模型;但核对英伟达官方项目页,目前明确能证实的 GB300 场景是机器人以 85% 成功率完成插装 GB300 内存模块的实操任务,而官方对上层规划模型的称呼仅仅是推理代理(reasoning agent),并未给它贴上 GPT-6 Astra 的标签。
真正把人类视频转化成真机动作,但卡在无触觉与慢思考
把 GR00T 2 放进硅谷具身智能的牌桌上横向比对,才能看清它真正的行业身位。过去半年,大家都在喊跨形态迁移,但做的其实是完全不同的事。
Google DeepMind 的 Gemini Robotics 1.5 主打运动迁移,核心是在 ALOHA、双臂 Franka 和 Apollo 这几款不同的机器人之间倒腾数据,且大量评估还停留在仿真环境里;Physical Intelligence 的 π0.5 同样是用海量真机数据去喂养跨平台的 VLA 策略。这两家都没有给出直接从普通人类视频里学到可执行物理技能的硬证据。GR00T 2 靠着视频预测这层中间跳板,第一次把人类头戴相机视频和真机任务进度提升算出了明确的因果账,这是它最硬的技术增量。
但对于盯着产线改造的工业自动化集成商来说,GR00T 2 要想抢传统工业机械臂的饭碗,面前还横着两道短期内迈不过去的物理高墙。
第一道墙是有眼无手。视频画面只能告诉机器人先拿哪个零件、往哪边移动,却不包含任何接触力学和夹爪力控信息。由于完全没有接入直接的触觉传感器数据,GR00T 2 在处理需要手感反馈的精密动作时非常脆弱。在插拔网线、充电器这类精细活上,团队依然得靠在真机上反复试错来硬训;遇到螺丝只拧进去一半这类视觉上看不出明显位移的细微错误,纯靠看画面的模型就会直接漏过去。
第二道墙是大脑太慢。面对把散乱零件拼成玩具车这类长步骤任务,单靠 GR00T 2 加上常规微调,100 次尝试里只能成功 23 次。为了救场,英伟达在顶层外挂了一个高层推理语言模型,负责把长任务拆成单步、在摄像头画面里用颜色标出抓取点,并在零件掉落时启动补救程序。这一招确实把玩具组装的成功率直接拉高到了 97% 以上,但代价是难以忍受的停顿:在垃圾分类测试中,因为每次都要等高层模型算完下一步,机器人平均每次得愣在原地等待超过 7 秒,整场测试下来有足足三分之一的时间在发呆。
- 风险.即便英伟达专门为双足人形机器人准备了削减图像细节的轻量化版本 GR00T 2 Turbo,并塞进端侧的 Jetson Thor 芯片里直接运行,让机器人学会了铲爆米花和收拾桌子,但在用脚底毛巾擦掉地面液体这种讲究力道控制的动作上,成功率依然只有不到一半。
这套世界-动作模型最精明的商业受益者其实是英伟达自己。传统的 VLA 模型参数量和推理开销相对温和,而一旦把实时视频扩散生成变成机器人每走一步的必经之路,云端预训练集群与端侧 Jetson Thor 芯片的算力消耗都会成倍膨胀。对具身智能创业公司而言,现在立刻把双臂遥操作采集压缩一部分、换成更便宜的头戴相机加手持夹爪方案,是一笔划算的买卖;至于什么时候能把这套系统塞进高节拍的工厂流水线,先看英伟达下一代能不能把触觉传感器揉进视频预测里,以及能不能把那 7 秒钟的发呆时间压进毫秒级。