每秒生成 2,100 个 token,听起来足够让任何等待 AI 写代码的程序员心动。中国 AI 公司 NaiveAI 发布的开源权重模型 Naive-N0.5-Flash,把极限吞吐量当成了最大卖点,并宣称要让模型自我迭代做 AI 研发。但在 Latent Space 针对编程与推理的横向实测里,这台吞吐量机器撞上了一个尴尬的现实:吐字快不等于交卷快,在最高难度的推理题上,它反而比每秒吐字慢得多的 DeepSeek V4.1 Flash 1017 更慢、更贵。
如果你正在为团队挑选主力 Flash 级编程模型,核心账面数据其实很清楚:
- 底座与改造成本.基于小米 MiMo-V2.5(原文引述为 310B 总参数、15B 激活参数,官方模型卡标明为 309B 总参数、15.5B 激活参数)继续训练。团队在原有 48T 预训练 tokens 基础上,仅用约 3.25T 额外 tokens(其中 3T 固定在 1M 上下文长度下训练),就把全注意力层彻底剥离,改造成 39 层滑动窗口注意力加 9 层 DeepSeek 稀疏注意力的 48 层架构。
- 能力坐标.在从零构建代码库的 NL2Repo-Bench 上得 71.9 分,压过 DeepSeek V4.1 Flash 1017(68.2)和 GLM 5.3 Flash(56.3);但在修补复杂工程的 DeepSWE v1.1(67.8)与 Agent's Last Exam(32.4)上,均落后于 DeepSeek(77.0 / 35.4),在 ProgramBench 上更只有 17.5 分(DeepSeek 为 29.1 分)。
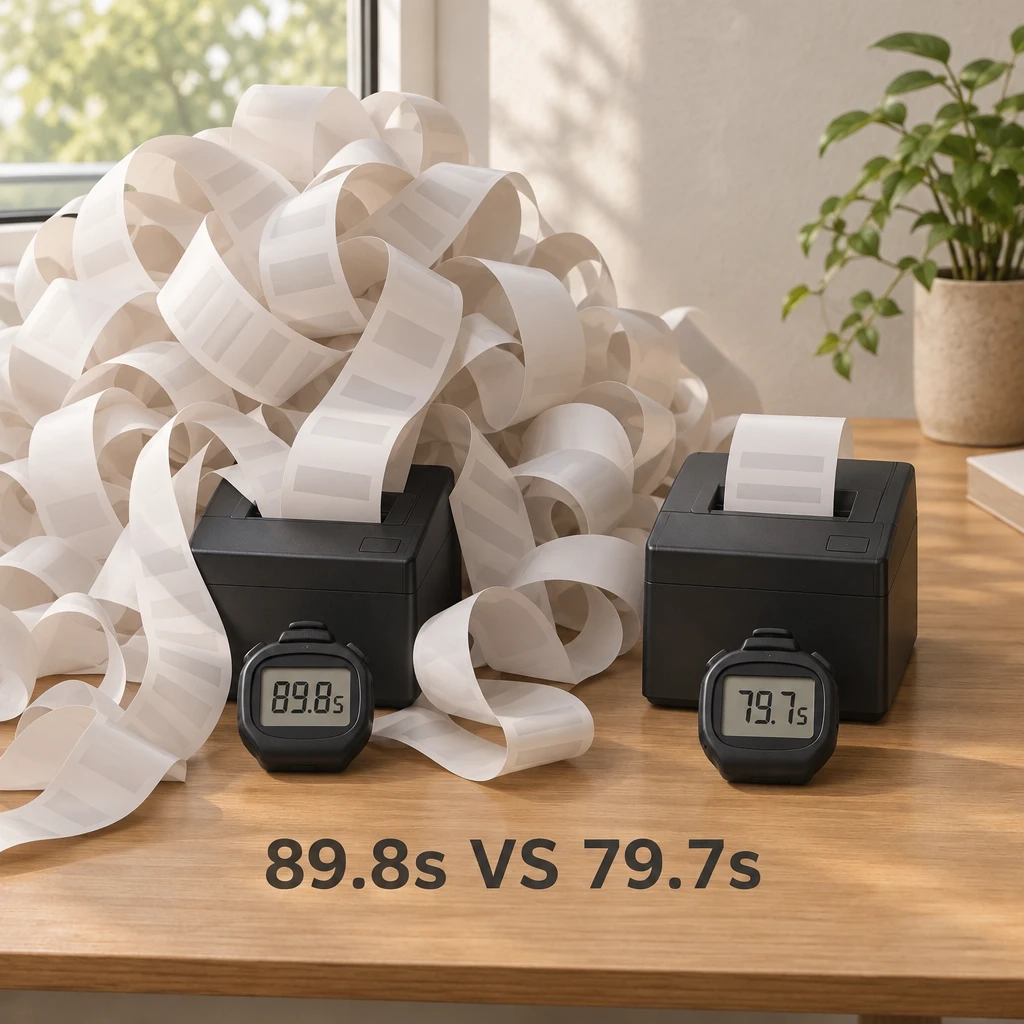
- 定价与耗时反差.Naive 公布的预期 API 输出价为 $0.40/百万 tokens,低于 GLM($0.50)与 DeepSeek(闲时 $0.60、忙时 $1.20)。但在 HLE-Diamond 难题实测中,它平均每题消耗约 108,500 个完成 tokens,端到端耗时达 89.8 秒,反被 DeepSeek(79.7 秒)反超。
| 模型版本 | NL2Repo (建库) | DeepSWE v1.1 (修库) | HLE难题平均耗时 | API输出单价 ($/M) |
|---|---|---|---|---|
| Naive-N0.5-Flash | 71.9 | 67.8 | 89.8 秒 | $0.40 (预期) |
| DeepSeek V4.1 Flash 1017 | 68.2 | 77.0 | 79.7 秒 | $0.60 - $1.20 |
| GLM 5.3 Flash | 56.3 | 63.4 | 162.1 秒 | $0.50 |
2,122 tokens/s 的实验室滤镜与 315GB 的本地门槛
先看那个最抓眼球的 2,100 tokens/s 是怎么来的。翻开 NaiveRT 推理引擎的代码仓库与技术博客,实测峰值确实达到了 2,122 tokens/s,但前提条件苛刻得像在无风室内测百米顺风跑。
这个数字需要同时满足六个条件:动用 8 张顶级 Blackwell GPU、运行专门定制的投机解码(Speculative Decoding)引擎 NaiveRT、单并发序列、关闭思考模式(thinking disabled)、只让模型写简单的 HTML/SVG 前端代码,最后从 41 个请求里挑出表现最好的 1 秒钟窗口,并且剔除了预填充(prefill)时间和陷入死循环的请求。哪怕同样在官方服务器上,一旦把统计口径拉平到跨请求整体设备速率,关闭思考时会掉到 1,719 tokens/s,开启思考后直接腰斩至 1,090 tokens/s。
对开源社区和打算私有化部署的团队来说,落差还要大得多。很多人看到 15.5B 激活参数会误以为它能轻松塞进工作站,但 MoE 架构省计算不省显存,309B 的总参数在官方 FP8 权重下依然要吃掉 315GB 显存。社区开发者 piotrkosecki 拿 4 张 96GB 显存的 RTX PRO 6000 Blackwell 专业卡,跑 NVFP4 量化版配合 vLLM 插件,早期 v1 解码速度只有 55 到 57 tokens/s,v2 处理 102 万 tokens 的长提示词检索足足跑了 418.1 秒。
脱离了官方深度绑定的 8 卡 Blackwell 与 NaiveRT 投机解码,普通团队在本地根本复现不出那个极速神话。
- 提醒.Naive-N0.5-Flash 权重与推理代码虽为 MIT 协议,但核心加速引擎 NaiveRT 为 Apache-2.0 协议且极度依赖底层硬件配置,常规 vLLM 部署实测速度与官方宣称值相差近 40 倍。
算力堆出极速解码,为何输给十万字的思考啰嗦症
把实验室水分拧干之后,Naive-N0.5-Flash 在官方 API 上的绝对吐字速度依然极快,在 Latent Space 的 30 道数学与科学测试中,它开启思考后的中位响应时间只有 3.1 秒,比 GLM 5.3 Flash(5.3 秒)和 DeepSeek V4.1 Flash 1017(10.1 秒)利落得多。
真正的毛病出在它处理难题的方式上。
我更在意的是这次实测暴露出来的推理通胀悖论。当测试难度升到最高级的 HLE-Diamond 时,开启思考的 Naive-N0.5-Flash 平均每道题要吐出约 108,500 个完成 tokens,这个啰嗦程度是 GLM 高思考档位的 9 倍、DeepSeek 高思考档位的 11 倍。哪怕它的推理引擎每秒能狂飙上千个 token,架不住它自己要写十万字的草稿纸,最终端到端平均耗时被拖到了 89.8 秒,直接输给了只花 79.7 秒的 DeepSeek。
引擎省下的每一秒钟,都被模型自己的十万字废话加倍讨了回来。
那能不能为了省时间把思考模式关掉?Latent Space 的三个网页应用构建实验给出了否定答案。在要求生成 3D 分叉树木、树叶纹理和风吹阴影的测试里,开启思考的 Naive 表现良好,但关闭思考的版本连一个能用的程序都写不出来;在太阳系 3D 模拟中,开启思考的 Naive 凭借太阳黑子和地球夜光细节拿了第一;而在更考验硬核编码的光线追踪移植任务里,三家开启思考后都能跑通,但 DeepSeek 写出来的 JavaScript 执行效率明显比 Naive 更高。
这事放在算力发展史上看并不新鲜。早年 PC 芯片打主频大战时,英特尔奔腾 4 把流水线拉得极长、主频推上近 4GHz,结果因为每时钟周期指令数(IPC)低下和发热失控,被主频低一截但效率更高的酷睿架构彻底淘汰。《韩非子》里讲过一句大实话,叫作功当其事,事当其功。评价一个工具好不好,从来不看它空转时有多快,只看它干完一票活到底耗了多少功。
今天的推理模型正在重演当年的主频幻觉。当计费单位从按次变成按 token,模型的思考收敛能力直接决定了你的真实账单。Naive 把输出单价定在 $0.40/百万 tokens,看似比 DeepSeek 便宜三分之一到三分之二,但它遇到难题多吐出来的 10 倍 token,不仅吃掉了单价折扣,还让调用方为冗余的自我怀疑买了单。
当然,NaiveAI 这次在工程上有个真正立得住的贡献:它证明了不需要从零烧几万亿 token,只要拿小米 MiMo-V2.5 这种成熟的巨型 MoE 底座,花 3.25T tokens 的小代价嫁接 DeepSeek 稀疏注意力,就能调出一个百万上下文的可用模型。这条低成本改造路线,接下来一定会被大把二线团队照着抄。
对于手握预算的一线研发团队,眼下的选型边界其实已经划得很清楚:
- 建议.把 Naive-N0.5-Flash 用在从零搭建前端原型、中等难度的快速交互(充分利用其 3.1 秒中位响应与 NL2Repo 优势),而在涉及大型存量代码库修补(DeepSWE)与复杂算法重构时,继续留在思考更收敛的 DeepSeek V4.1 Flash 1017 上。
至于 Naive-N0.5-Flash 能不能真正威胁到现有的 OpenRouter 头部座次,不用看它接下来还会晒出多高的瞬时峰值,只看两件事:正式上线 API 后在真实并发下的价格兑现情况,以及 Artificial Analysis 等独立机构把答题准确率算进去之后,它每解对一道题到底要烧掉多少美金。