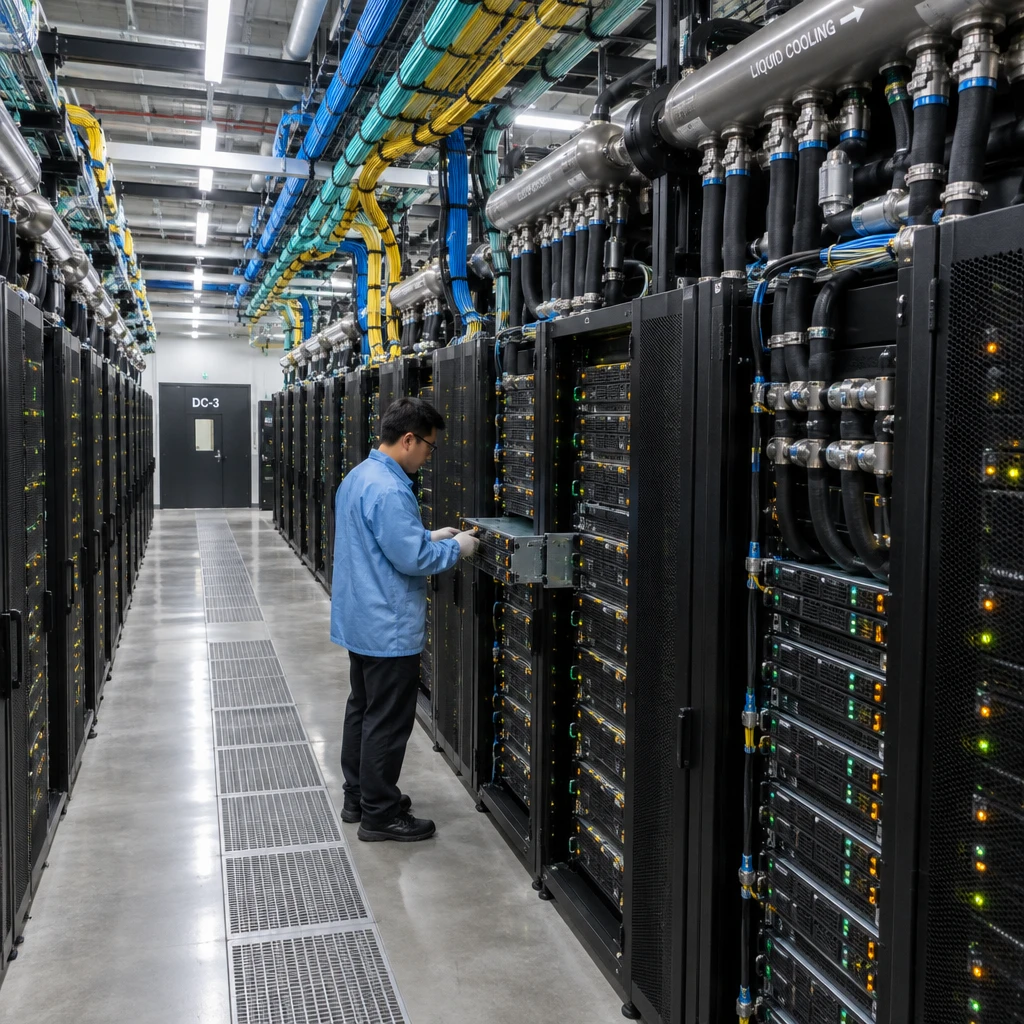
英伟达在 GitHub(dsx-ai-factory/nvke)上以 Apache 2.0 协议开源了 NVIDIA Kubernetes Engine (NVKE) 预览版。截至 2026 年 11 月 6 日,最新版本号为 v0.23.1(Go 1.27.3)。它不是普通的 Kubernetes 发行版,而是一个专为裸金属 GPU 基础设施设计的“集群工厂”管理平面,让平台团队能按需给客户交付拥有独立控制面、独立 etcd 和独立节点池的 K8s 工作负载集群。即使手头没有 GPU 硬件,开发者也能在至少 6 CPU、12 GiB 空闲内存、100 GiB 空闲磁盘的 Linux 主机或 macOS Colima 虚拟机上跑通本地模拟评估。
横向对比看,NVKE 的核心优势是原厂硬件级绑定与零商业授权费:节点入网前强制通过 TPM 芯片与 SPIFFE/SPIRE 完成硬件身份证明,直击智算中心的多租户控制面隔离痛点。但它的短板同样致命——目前处于极早期工程预览阶段,默认明文 HTTP 且无内部权限分级,管理集群甚至没有升级和备份恢复机制,成熟度远不及 Red Hat OpenShift 或英伟达自家的 Base Command Manager (BCM)。
藏在代码库背后的 DSX OS 拼图
只看仓库主页,很容易把 NVKE 当成一个孤立的开源组件。但穿透 GitHub 组织认证与底层文档就会发现,dsx-ai-factory 组织直接控制着 nvidia.com 域名,官方给 NVKE 的真实定位是 DSX OS 的 Kubernetes 层。
英伟达正在用一套全新的云原生解耦栈,把从物理裸机到上层容器的整条链路重新定义一遍:
- NICo(NVIDIA Infra Controller):接管最底层的物理机发现、固件刷写、网络与裸机配置。
- NVKR(NVIDIA Kubernetes Recipes):负责供应链安全,从锁定版本的输入源构建并签名节点 OS 镜像与组件。
- NVKE.通过 CAPNICo 调用 NICo 申请机器,负责工作负载集群的生命周期管理。
- AICR 与 NVSentinel:分别提供容器加速运行时,以及 GPU 硬件故障检测与修复请求下发。
这里有一个工程演进上的细节冲突。仓库主页 README 明确写着预览版中 NICo 是唯一兼容的基础设施提供商;但在支持平台文档(supported-platforms.md)里,除了默认通过 CAPNICo v0.1.0 对接 NICo 外,明确标注一旦启用,LaunchLayer 也受支持。这说明英伟达底层的硬件对接层正在向更多场景扩展,只是外围文档还没来得及对齐。
已经有了 BCM 和 Run:ai,为什么还要造 NVKE
如果用单集群做多租户,大客户往往不接受与别人共用同一个 Kubernetes API 和控制面;如果采购 Red Hat OpenShift 等商业发行版,高昂的订阅费和特定操作系统生态绑定又会直接吞噬算力租赁的毛利。
硬件越昂贵,控制面就越不能假手于人。
NVKE 切中的正是这块空白。它与英伟达现有体系的边界非常清晰:
- BCM 是传统一体化重装系统.把主机配置、OS 镜像与 K8s 或 Slurm 部署打包在一起,适合企业自建单个大型 HPC/AI 集群。
- NVKE 是云原生解耦的 KaaS 引擎:走 Cluster API 模式,由一个临时种子集群拉起管理集群,再由管理平面源源不断地为不同租户孵化出完全隔离的 K8s 集群。
- **Run.ai 管的是池内切分**:解决共享算力池内部的配额、排队与细粒度 GPU 切分,和 NVKE 的“控制面级隔离”处于不同维度。
更关键的事实是,英伟达这两套体系目前还没有合龙。官方文档里,BCM 已经明确支持在 BCM Kubernetes 之上部署 Run:ai,Run:ai 多租户 v3.0 支持矩阵也明确认证了 OpenShift 租户集群,但尚未建立经过明确认证的 NVKE + Run:ai 兼容组合。
为什么现在绝对不能把 NVKE 放进生产环境
尽管架构图画得很丰满,但翻开 NVKE 的代码库和限制文档,结论只有一个:现在谁拿它上生产,谁就是在给机房埋雷。
截至 2026 年 11 月 6 日,该仓库挂着 76 个 Open Issues。就在 11 月 3 日发布 v0.23.1(通过引入允许列表修复了租户 kubeconfig 解析问题)前后,Issue 列表里依然躺着编号 #2104 的 P0 级故障(main is red: Gofail E2E 主干端到端测试挂红),以及编号 #2062 的 P1 级问题(v0.23.0 发布认证失败)。
比代码分支不稳定更严峻的,是架构层面的安全与运维缺口:
- 风险.NVKE 安装后 API 默认使用明文 HTTP 且关闭身份验证;即便运维人员手动开启验证,API 内部也完全没有授权(Authorization)机制——任何通过身份验证的调用者都能访问所有 API 端点,且发给客户的管理员
kubeconfig副本在客户端证书自然过期前无法被吊销。
管理平面自身的生命周期也是断头的。当前的管理集群不支持自升级、自扩缩容或自替换节点,官方没有提供管理平面的升级流程和备份恢复方案;用于评估的全盘加密(FDE)节点镜像更是明确标注不提供静态数据机密性。
| 部署路线 | 适用核心场景 | 隔离与调度机制 | 当前生产可用度 |
|---|---|---|---|
| BCM + Run:ai | 企业自建大集群 / HPC 与 AI 混部 | 一体化裸机部署 + 共享池配额切分 | 官方认证成熟可用 |
| OpenShift + Run:ai | 强合规企业多租户平台 | 商业发行版管控 + Run:ai v3.0 多租户 | 官方认证成熟可用 |
| NICo + NVKE | 智算中心对外售卖独立 K8s 集群 | 租户级独立控制面与独立 etcd | 仅限评估,严禁上生产 |
对智算中心和企业架构师来说,眼下最稳妥的决策是拿 6 核虚拟机跑通 NVKE 的本地模拟,摸清 NICo 与 NVSentinel 的接口逻辑,但在生产环境继续守住 BCM 或 OpenShift 方案。决定 NVKE 何时能真正接管生产机房的变量只有三个:API 内部细粒度鉴权(RBAC)何时合入主干、管理平面何时补齐原地升级与 etcd 灾备流程、以及官方何时拿出 NVKE 与 Run:ai 的联合认证矩阵。