只要在终端敲下一行 docker run,一个彼此隔离、自带文件系统与独立网络的实例就会在几百毫秒内跑起来。这种丝滑的体验让很多开发者产生了一种错觉,以为容器就像更小、更快的虚拟机。但只要试着亲手写一个最简陋的容器运行时,这个精致的幻象就会立刻碎一地。
Linux 内核里压根没有叫作容器的实体对象。所谓的隔离,不过是五大内核机制套上的一件风衣;而支撑整个现代云原生底座的核心运行时 runc,更是在用一套近乎杂耍的系统级妥协,为当年的技术选型买单。
所谓容器,只是一场内核级别的视错觉
把容器拆开,里面除了一堆被打散的 Linux 原生系统调用,什么都没有。它没有独立的内核,也没有任何硬件虚拟化指令。
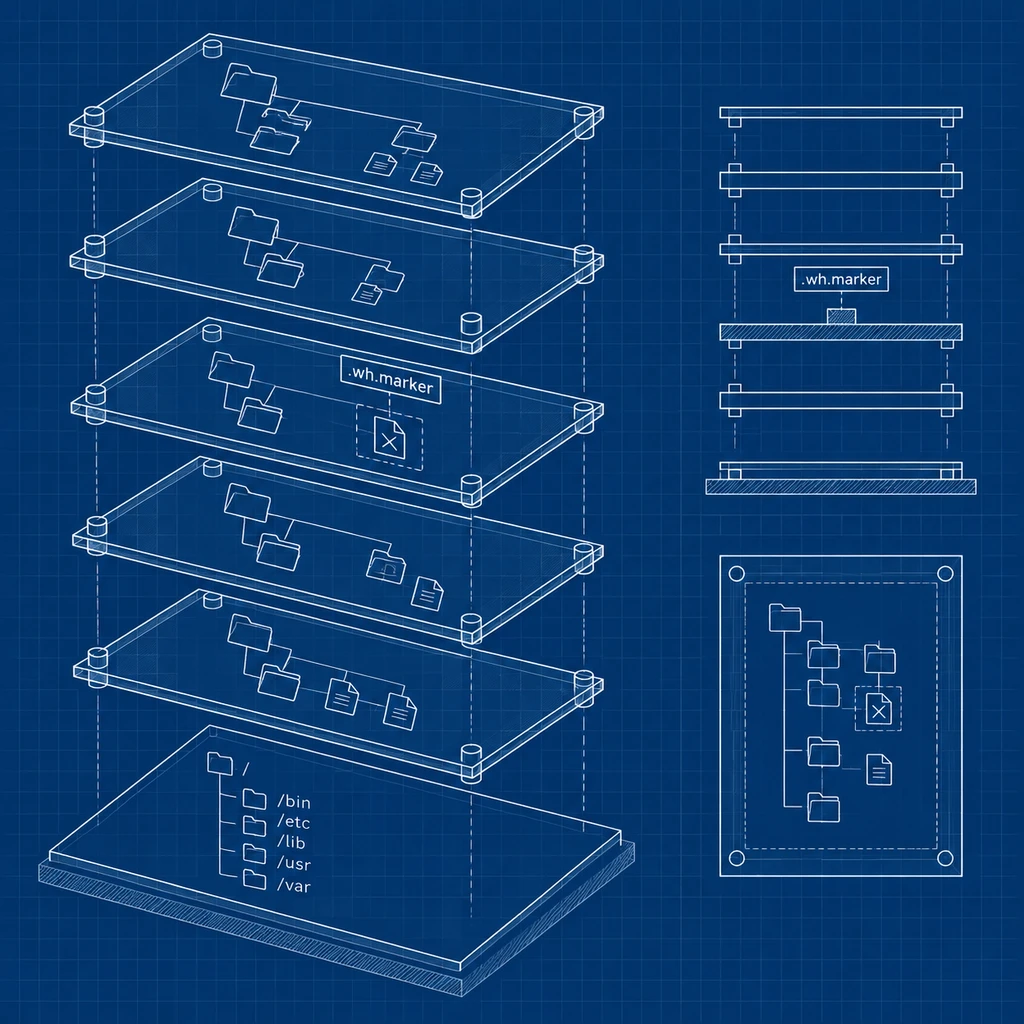
隔离的视野来自 Namespaces(命名空间),配额的边界来自 cgroups。你以为跑在容器里的 /bin/bash 是独立系统,其实在宿主机的 /proc 目录下直接能揪出它的真实进程 ID。至于镜像,并不是一个封包好的神秘虚拟磁盘,而是按照 OCI 镜像规范打包的内容可寻址产物:它由 manifest、config 和一层层被 gzip 压缩的差异层(layers)构成,删除文件则用 .wh.filename 白消标记记录。
当 Docker 把这些分层解包后,它只是得到了一个普通的目录。runc 挂载根文件系统时,会根据命名空间环境在 pivot_root、mount-move 与 chroot 之间动态切换,强行把那个解压出来的文件夹定义成进程的新世界。
在标准调用链里,Docker CLI 将指令发给 dockerd,dockerd 协调 containerd,containerd 派生出常驻的 containerd-shim-runc-v2,再由它调用真正干脏活的 OCI 运行时规范实现者 runc。runc 创生容器进程后就会退出,把生命周期的监控交给 shim。这里没有魔法,只有层层管道的装配。
荒诞的联姻:用 Go 写系统运行时的黑魔法
如果重回容器诞生的早期,用 Go 语言写底层运行时,几乎是个反系统编程常识的决定。
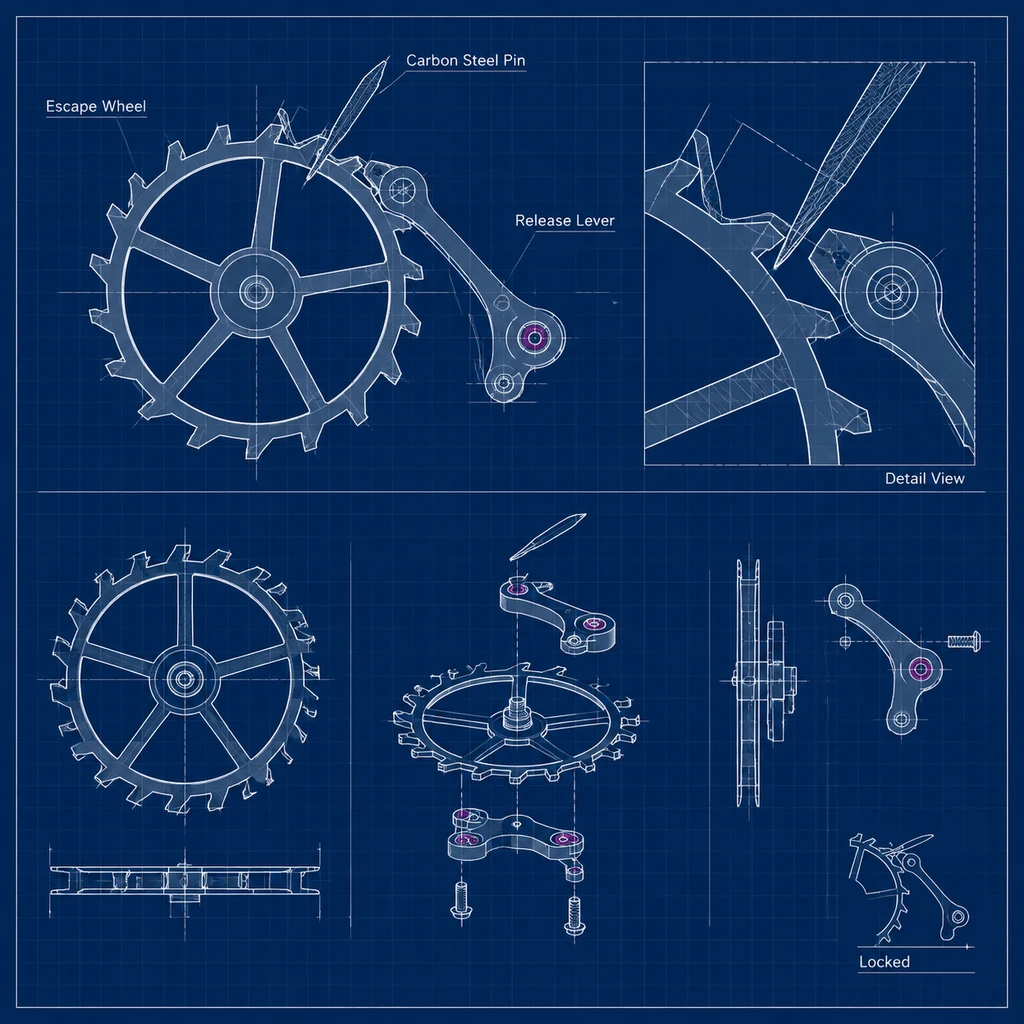
Linux 核心的隔离系统调用(例如 setns、unshare),对执行环境的要求极为苛刻:必须在严格的单线程状态下调用。然而 Go 语言拥有自己强大的运行时调度器,程序刚一启动,它就会在后台直接创建多个 OS 线程去驱动并发。更麻烦的是,Go 为了防止多线程内存混乱,直接阉割了标准的 fork() 接口。
偏偏容器启动的核心逻辑,必须先 fork 一个单线程子进程,把命名空间、cgroups、seccomp 策略全部布设完毕,最后再调用 exec 把控制权交给业务程序。
现实的工程世界里,能跑通的粗糙妥协,往往远胜于停留在纸面上的纯洁设计。
面对这个致命冲突,runc 的开发者们写出了一段名垂开源史的黑魔法:
- C 构造函数抢跑在
libcontainer/nsenter/nsenter.go中,runc 借由 cgo 注册了一个带有 GCC__attribute__((constructor))属性的 C 模块nsexec.c。这个 C 模块会在操作系统把二进制载入内存后、Go runtime 还没来得及初始化并发线程的死角里,强制抢先执行。 - 重执行自身伪装 forkGo 不能正常安全地 fork,runc 就干脆调用
exec.Command(exePath, "init"),重新启动一遍自身进程/proc/self/exe(现代版本更会克隆自执行安全文件描述符/proc/self/fd/...防范提权攻击)。 - 多阶段管线派生重新自启的子进程在那个 C 语言环境里分步派生出处于不同 PID 命名空间层级要求的临时进程,把内核隔离全部拼好,最后才老老实实进入
init.go把环境交还给 Go 处理。
这段代码极其反直觉,甚至堪称恶心。但事实是:Go 卓越的跨平台静态编译能力和高并发工程生态,让 Docker 踩着这个巨大的补丁赢下了整场云原生战争。
告别特权:Rootless 正在咽下性能苦果
早期的 Docker 几乎必须以宿主机 root 权限运行守护进程,这意味着一旦容器被攻破,宿主机很容易被直接拿下。
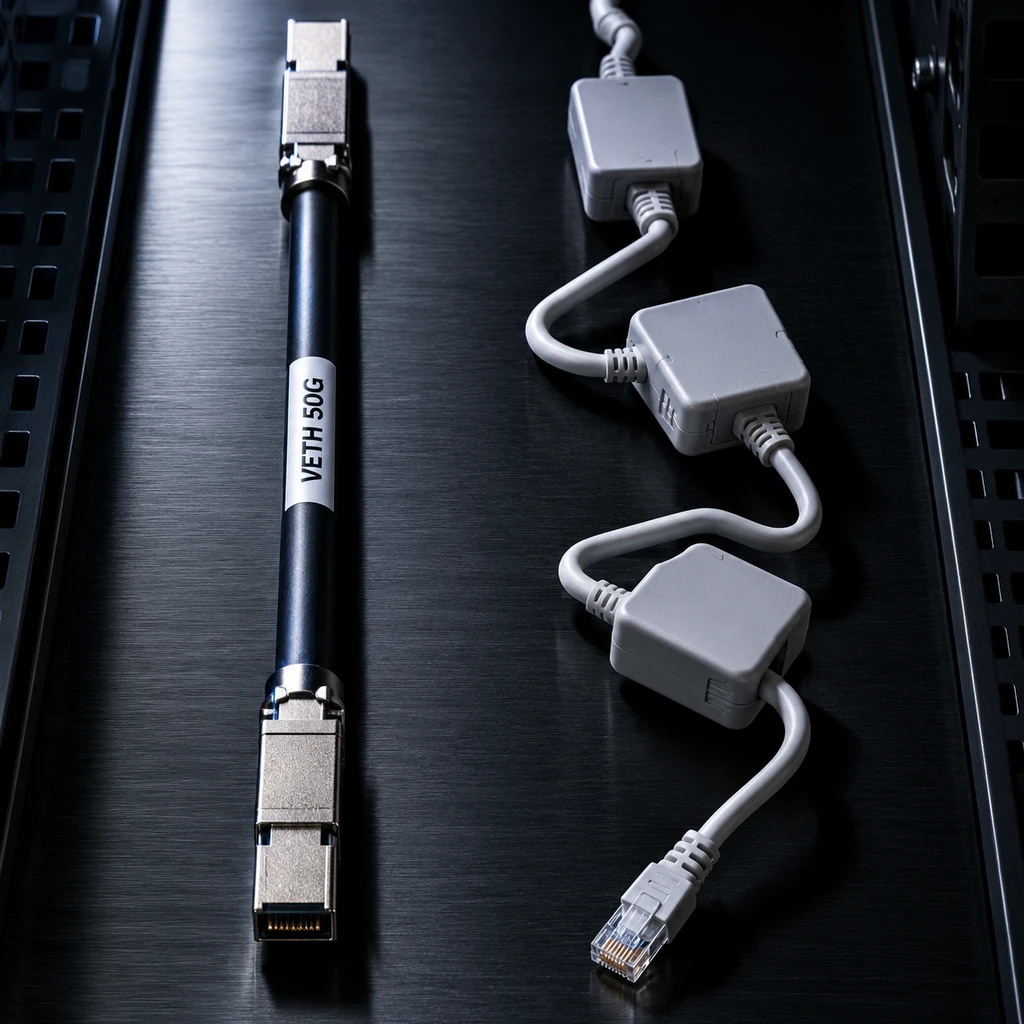
为了打破这种原罪,去特权化的 Rootless 架构应运而生。可把 root 权限拿掉之后,容器又被掐住了喉咙:它没法在内核中创建标准的虚拟以太网卡对(veth pair)。要给容器联网,就必须在用户空间把网络协议栈全部重写一遍。
代价是惊人的。在出网基准测试中,root 容器的 veth 基线带宽可以轻松拉满到 49 至 50 Gbit/s。而在 Rootless 环境下,过去的默认网络方案 slirp4netns 在常规 MTU 1500 下吞吐量只有 1.69 Gbit/s;即使切换到被寄予厚望的 pasta,在 MTU 1500 下竟然跌到仅有 0.24 Gbit/s。
虽然在巨帧 MTU 65520 下,pasta 能通过零拷贝优化把吞吐暴力拉升到 31.9 Gbit/s,且在发布端口测试里其实验性分支能压榨出 45.2 Gbit/s(远超 slirp4netns 的 7.56 Gbit/s),但这直接造成了不同生态的路线分裂:
- 工具链取舍.Podman 从 5.0 起将 pasta 列为默认工具,并在 6.0 中彻底砍掉了 slirp4netns;而 Docker 则主要依赖 RootlessKit 包装。
- 配置的隐蔽陷阱.很多人误以为 Rootless 必然丢失真实客户端 IP,实际上 RootlessKit 自 v3.0 起已在内置驱动支持 TCP 来源透传,前提是必须关掉传统的 userland-proxy。Docker Engine 29.5 也开始重构 host-network 机制来修补割裂。
- 风险.Rootless 容器并不是一开即用的免费午餐,在网络敏感或微服务吞吐密集的生产环境,盲目去 root 可能导致意料之外的吞吐塌陷。
站在使用者的视角,Docker 的容器概念无比简洁:镜像打包一切,进程开箱即用。但只有当你下潜到底层才会发现,它之所以能运转,并不是系统在底层专门为它造了什么平坦大道,而是一群工程师在内核不允许、语言不合适的夹缝里,硬生生用胶水和补丁凿出了一条路。
重拾对这种底层妥协的理解,不是为了猎奇,而是要在云原生吞噬一切基础设施的今天,提醒自己不要迷信黑盒的抽象。工具越把复杂性隐藏得天衣无缝,我们在遇到瓶颈与安全逃逸时,就越需要看穿魔术师口袋里的暗格。