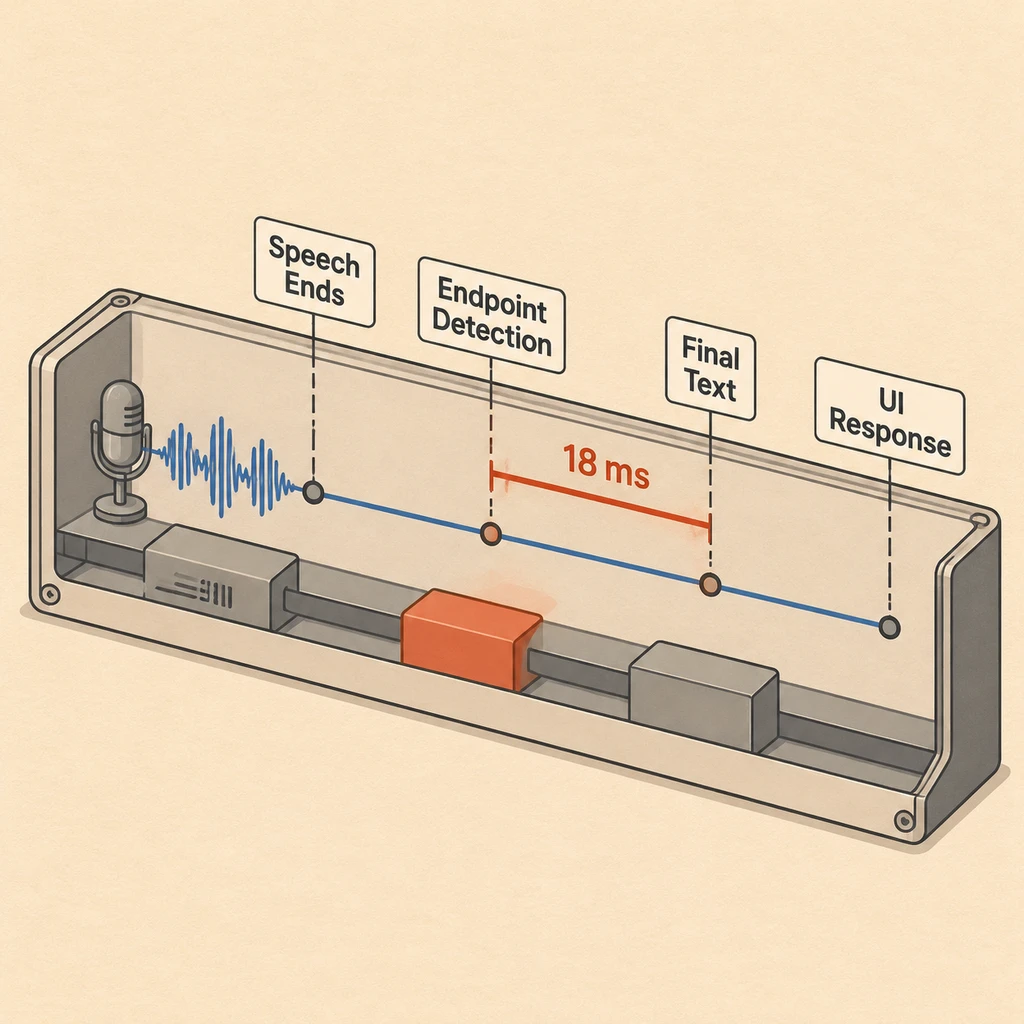
18 毫秒,是 Moonshine Voice 在 MacBook Pro 上返回最终转写的官方成绩。这个数字从系统判定用户说完才开始算。你停下来等它确认的那段静音,以及转写出来后应用还要做的事,都在计时之外。
2026 年 11 月 19 日,The Data Exchange 发布了 Ben Lorica 对 Moonshine Voice 联合创作者 Pete Warden 的访谈,节目最初在 O’Reilly 播出。Warden 认为,把推理搬到设备上能让语音交互更自然。我更在意搬完以后,用户到底少等了哪一段。
边说边转写,先看设备和语言
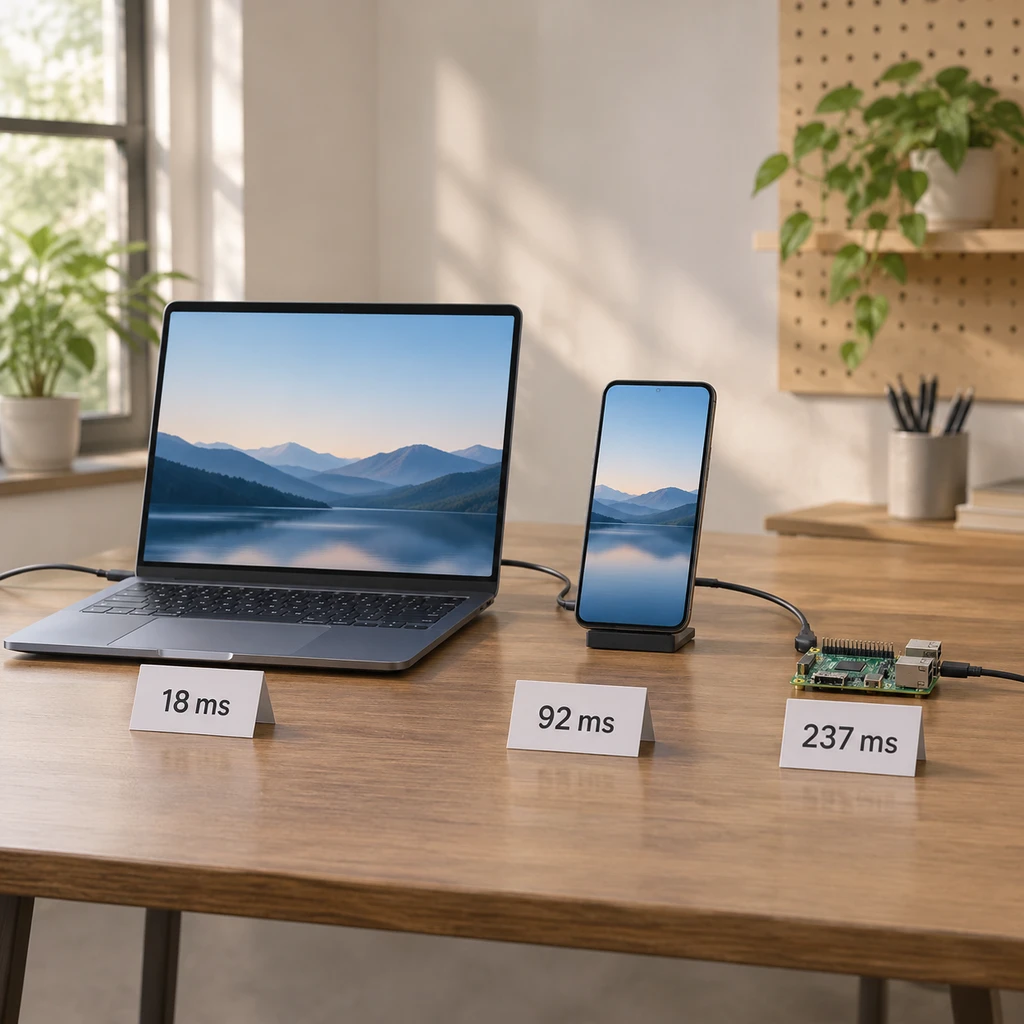
Warden 在 2026 年 2 月 13 日发布 Moonshine Voice。这个库能在 CPU 上边听边转写,用户还在说,应用就能收到部分文本。英语 CPU 测试中,Tiny Streaming 在 MacBook Pro、Pixel 10a 和 Raspberry Pi 5 上的收尾耗时分别为 18、92 和 237 毫秒。
<svg viewBox='0 0 760 204' width='100%' height='204' role='img' aria-label='Tiny Streaming 英语 CPU 测试的判停后耗时'>
<rect x='1' y='1' width='758' height='202' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' fill='#b25a3a' font-size='20' font-weight='700'>判停后的转写耗时</text>
<line x1='28' y1='55' x2='732' y2='55' stroke='#e2dccf' stroke-width='1'/>
<rect x='28' y='80' width='224' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='268' y='80' width='224' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='508' y='80' width='224' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
<g text-anchor='middle'>
<text x='140' y='124' fill='#2c2822' font-size='32' font-weight='700'>18 毫秒</text>
<text x='380' y='124' fill='#2c2822' font-size='32' font-weight='700'>92 毫秒</text>
<text x='620' y='124' fill='#2c2822' font-size='32' font-weight='700'>237 毫秒</text>
<text x='140' y='151' fill='#7a7266' font-size='14'>MacBook Pro</text>
<text x='380' y='151' fill='#7a7266' font-size='14'>Pixel 10a</text>
<text x='620' y='151' fill='#7a7266' font-size='14'>树莓派 5</text>
</g>
</svg>
模型越大,覆盖的语言反而越少。Tiny Streaming 有 3400 万参数,支持 8 种语言。Small Streaming 有 1.23 亿参数,支持 4 种。Medium Streaming 有 2.45 亿参数,只支持英语。
核心代码、全部流式识别模型和英语非流式模型采用 MIT 许可。韩语和乌克兰语目前只有旧版非流式权重,商业使用受 Moonshine Community License 限制。第三方代码和语音合成资产另有条款。采购时要把目标语言、流式权重和商用许可放在一起核对。
人说完了,系统还在等
流式识别能趁用户讲话时先做一部分工作,也能省掉把音频发往云端识别的往返。可人停了一下,系统还得判断他是在换气,还是已经讲完。官方计时只覆盖判停到最终文本这一段。首个稳定片段何时出现,命令何时执行,要另设计时点。
<svg viewBox='0 0 760 208' width='100%' height='208' role='img' aria-label='从用户开口到应用响应,官方只测系统判停到最终文本'>
<rect x='1' y='1' width='758' height='206' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' fill='#b25a3a' font-size='20' font-weight='700'>官方只测转写收尾</text>
<line x1='28' y1='55' x2='732' y2='55' stroke='#e2dccf' stroke-width='1'/>
<rect x='28' y='79' width='124' height='56' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='173' y='79' width='124' height='56' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='318' y='79' width='124' height='56' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='463' y='79' width='124' height='56' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='608' y='79' width='124' height='56' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<polygon points='158,102 167,107 158,112' fill='#7a7266'/>
<polygon points='303,102 312,107 303,112' fill='#7a7266'/>
<polygon points='448,102 457,107 448,112' fill='#b25a3a'/>
<polygon points='593,102 602,107 593,112' fill='#7a7266'/>
<g text-anchor='middle' fill='#2c2822' font-size='16'>
<text x='90' y='113'>用户讲话</text>
<text x='235' y='113'>实际说完</text>
<text x='380' y='113'>系统判停</text>
<text x='525' y='113'>最终文本</text>
<text x='670' y='113'>应用响应</text>
</g>
<line x1='380' y1='150' x2='525' y2='150' stroke='#b25a3a' stroke-width='2'/>
<circle cx='380' cy='150' r='3' fill='#b25a3a'/>
<circle cx='525' cy='150' r='3' fill='#b25a3a'/>
<text x='452.5' y='175' text-anchor='middle' fill='#b25a3a' font-size='13'>官方计时段</text>
</svg>
Bolo Speech 在一套 4 vCPU 环境中,用同一段 3 秒音频,仅改动判停预设,最终响应就从 355 毫秒变成 1,212 毫秒。这组数字说明判停设置有多大影响。Pi 5 上的 Moonshine v2 Streaming 还得按目标配置另测。
独立的 Pi 5 测试喂的是整段录音。Moonshine v1 Base INT8 的综合英语词错误率、实时因子和峰值内存分别为 8.8%、0.097 和 552 MiB,Whisper Base FP32 则为 9.6%、0.365 和 1,516 MiB。两套配置精度不同,数字适合拿来估算部署开销。单看 FLEURS 英语子集,词错误率的排序就倒了过来,Whisper 为 12%,Moonshine 为 15%。换一批口音和词汇,选型可能跟着变。
字幕能改,命令会真的执行
要在 Moonshine v2 Streaming、流式 Zipformer 和 Whisper 之间做选择,我会让它们用同一批录音,按麦克风的节奏送入,固定线程预算和判停条件。分别记下首个稳定片段、实际说完到最终文本、实际说完到界面响应的耗时。延迟长尾、词错误率、峰值内存和误执行一起看,冷启动单列。
字幕可以先出字再修订,适合把专用识别模型留在设备上。短命令也适合拆开做,开发者能查清错在判停、转写还是执行,并给用户留一个撤销入口。开放式对话则值得试端到端语音模型,因为语调可能影响理解。评估它,要听它能不能接对话、被打断后能不能接回来,光比转写准确率答不了这些问题。
部署位置决定谁来付账
端侧能否覆盖用户,得从设备清单算起。访谈举了一个 90 亿参数模型的例子,原始权重用 8 位约占 9 GB,用 4 位约占 4.5 GB,实际还得算量化元数据和运行时内存。浏览器也有门槛。Chrome Prompt API 只在符合条件的设备上支持首次下载后运行 Gemini Nano,设备覆盖得单独验证。
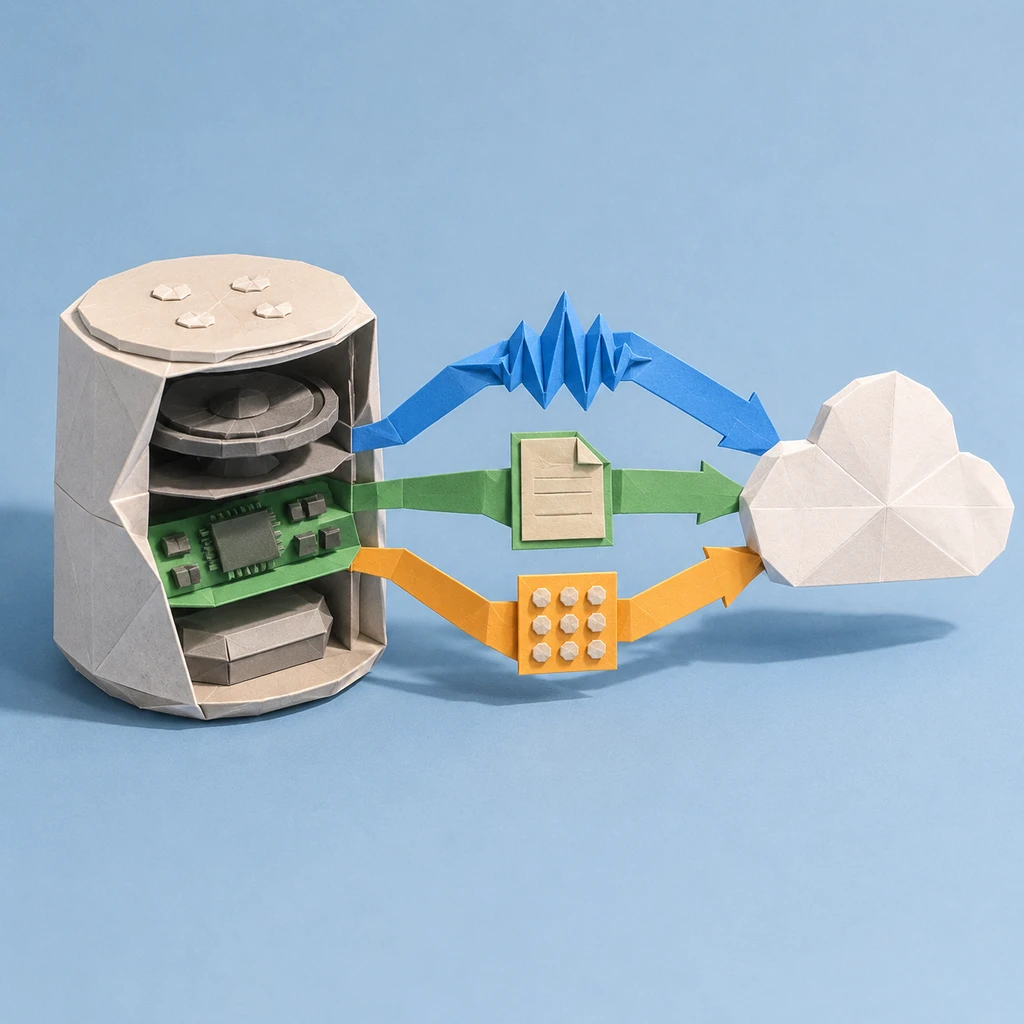
企业也可以在自管机房或自有云部署,把模型版本和升级节奏握在自己手里。端侧省下的 API 账单,要和适配、功耗、模型分发及维护一起算。自托管还要算容量利用率和运维,低频或负载起伏大的任务可以把云 API 留在比价名单里。
采购验收时,我会要求把音频、转写和日志的去向写清楚,尤其是识别失败后切到云端的那条路。用户说完一句话,产品得经得起两项检查。界面到底等了多久才动,数据又在什么时候离开了设备。