OpenAI 官网有一篇文章,标题讲 Performance Factory 怎样让 ChatGPT 保持快速,抓取到的正文却只剩 500 错误。同一链接的检索摘要提到逾 1700 项性能调查。页面报错不能说明 ChatGPT 当时卡不卡,调查量也不能说明用户少等了多久。
Codex 查问题,工程师决定上线
按摘要描述,监控告警触发调查任务,Codex 翻日志、指标、链路追踪和代码,记录发现并提出修复建议。上线决定留给工程师。部署后,代理把生产表现与此前基线比较;如果性能仍未恢复,任务就回到调查。
<svg viewBox='0 0 600 236' width='100%' height='236' role='img' aria-label='性能退化调查与生产复测流程'>
<rect x='1' y='1' width='598' height='234' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' font-size='19' font-weight='700' fill='#b25a3a'>告警如何走到生产复测</text>
<line x1='28' y1='55' x2='572' y2='55' stroke='#e2dccf'/>
<rect x='28' y='83' width='118' height='68' rx='8' fill='#f5f1e9' stroke='#e2dccf'/>
<rect x='170' y='83' width='118' height='68' rx='8' fill='#f5f1e9' stroke='#e2dccf'/>
<rect x='312' y='83' width='118' height='68' rx='8' fill='#f5f1e9' stroke='#e2dccf'/>
<rect x='454' y='83' width='118' height='68' rx='8' fill='#f5f1e9' stroke='#b25a3a'/>
<text x='87' y='122' text-anchor='middle' font-size='15' fill='#2c2822'>告警建单</text>
<text x='229' y='112' text-anchor='middle' font-size='15' fill='#2c2822'>Codex 排查</text>
<text x='229' y='133' text-anchor='middle' font-size='12' fill='#7a7266'>记录并提案</text>
<text x='371' y='112' text-anchor='middle' font-size='15' fill='#2c2822'>工程师审查</text>
<text x='371' y='133' text-anchor='middle' font-size='12' fill='#7a7266'>决定是否上线</text>
<text x='513' y='112' text-anchor='middle' font-size='15' fill='#b25a3a'>代理复测</text>
<text x='513' y='133' text-anchor='middle' font-size='12' fill='#7a7266'>对照生产基线</text>
<line x1='150' y1='117' x2='160' y2='117' stroke='#7a7266'/><polygon points='160,113 166,117 160,121' fill='#7a7266'/>
<line x1='292' y1='117' x2='302' y2='117' stroke='#7a7266'/><polygon points='302,113 308,117 302,121' fill='#7a7266'/>
<line x1='434' y1='117' x2='444' y2='117' stroke='#7a7266'/><polygon points='444,113 450,117 444,121' fill='#7a7266'/>
<polyline points='513,157 513,201 229,201 229,164' fill='none' stroke='#7a7266'/>
<polygon points='225,165 229,158 233,165' fill='#7a7266'/>
<text x='371' y='190' text-anchor='middle' font-size='13' fill='#7a7266'>未恢复则继续调查</text>
</svg>
摘要将文章署名归于 Okay Zed 和 Cyrus Forbes,日期标为 2026 年 11 月 19 日。按摘要口径,略超三个月内,流程跟踪了逾 1700 项调查,在逾 600 个案例中定位了根因。正文目前无法逐项对照;两个数都是下限,直接相除算不出准确的定位率。摘要也没给出修复上线量或用户延迟变化。
<svg viewBox='0 0 600 204' width='100%' height='204' role='img' aria-label='调查量和根因定位量已见于摘要,恢复量未披露'>
<rect x='1' y='1' width='598' height='202' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' font-size='19' font-weight='700' fill='#b25a3a'>调查量与恢复量</text>
<line x1='28' y1='55' x2='572' y2='55' stroke='#e2dccf'/>
<rect x='28' y='79' width='172' height='96' rx='8' fill='#f5f1e9' stroke='#e2dccf'/>
<rect x='214' y='79' width='172' height='96' rx='8' fill='#f5f1e9' stroke='#e2dccf'/>
<rect x='400' y='79' width='172' height='96' rx='8' fill='#f5f1e9' stroke='#b25a3a'/>
<text x='114' y='125' text-anchor='middle' font-size='32' font-weight='700' fill='#2c2822'>逾1700</text>
<text x='300' y='125' text-anchor='middle' font-size='32' font-weight='700' fill='#2c2822'>逾600</text>
<text x='486' y='125' text-anchor='middle' font-size='28' font-weight='700' fill='#b25a3a'>未披露</text>
<text x='114' y='151' text-anchor='middle' font-size='13' fill='#7a7266'>跟踪调查</text>
<text x='300' y='151' text-anchor='middle' font-size='13' fill='#7a7266'>定位根因</text>
<text x='486' y='151' text-anchor='middle' font-size='13' fill='#7a7266'>复测确认恢复</text>
</svg>
一次回答里的快,有不同口径
点下发送,用户要等请求排队、模型读完输入,再等它生成回答。提示词缓存复用完全匹配的共享前缀所对应的 KV 状态,省的是预填充计算。OpenAI 在 2024 年 10 月公布受支持模型的 API 自动缓存,初期面向超过 1024 个 token 的提示词,所列模型的缓存输入打五折。API 文档建议把稳定指令和工具定义放前面、可变内容放后面;请求路由和缓存位置也会影响命中。
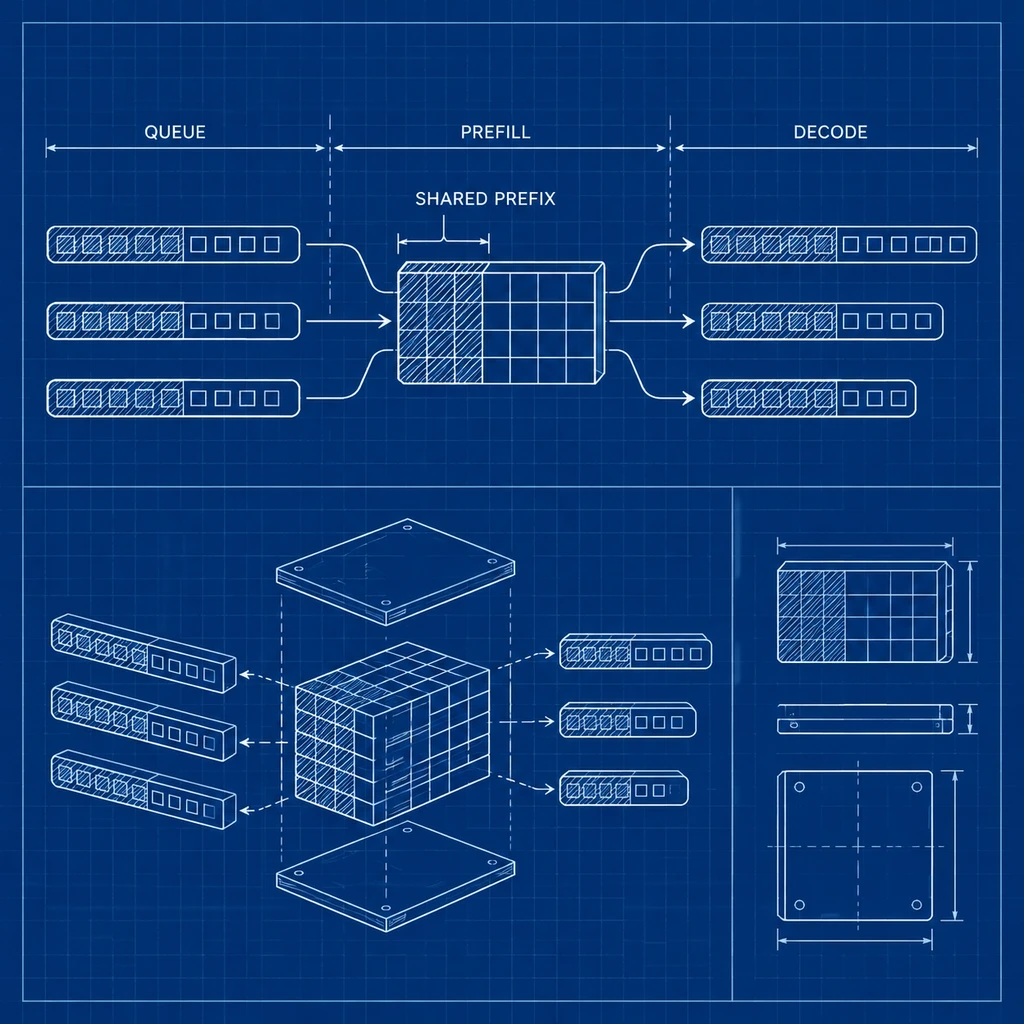
输出解码又是另一段。推测解码让更快的草稿模型先提议 token,再由主模型验证,能省多少取决于接受情况和验证开销。OpenAI 公开谈过推测解码、负载均衡、缓存和计算内核优化,但现有材料没交代 ChatGPT 线上如何实现推测解码,也没给出它的单项贡献。高峰期,批处理和调度还得在吞吐与排队之间取舍,平均值好看,不代表等得最久的请求也变快了。
API 榜单给不了 ChatGPT 的体感
Artificial Analysis 在 2026 年 11 月 19 日的 API 快照里,高推理档的首 token 等待,Claude Fable 5.2 是 23.43 秒,GPT-6.2 Astra 是 28.62 秒,Gemini 4 Neon 是 40.64 秒。换到低档,GPT-6.2 Astra 以 2.83 秒在这组里最快。按输出速度栏,Claude Fable 5.2 高、低档分别为 108 和 109 tokens/s,两档都领跑这组。
摘要称,该栏把推理 token 算进产出,把初始等待算进耗时,具体口径仍要核对方法页。首 token 是否就是首个可见答案 token,也得分开确认。API 开发者若要选模型,得用同类任务对齐质量要求和推理设置再比;消费端用户更不能把这张榜单当成 ChatGPT 的提速成绩单。
用户等的是恢复,不是结案
我更在意的是,Codex 省下的时间有没有传到用户那头。像电网抢修,找到故障和恢复供电各有一个时间点。ChatGPT 的退化也常有轻重之分,所以除了恢复耗时,还得看哪些请求曾变慢,恢复后又快了多少。
最有说服力的证据是一条带时间戳的真实案例,把告警、定位、审查、部署和复测串起来,再看同一批受影响请求在修复前后的延迟分布。比较时要留意流量、请求类型、模型版本和同期上线变更。这样能判断这次修复有没有奏效;要算 Codex 比旧流程省了多久,还得找可比的旧任务。
少翻几轮日志,对值班团队有价值。但如果时间都花在等审查、等部署,用户照样要等。逾 1700 项调查已经有了计数,接下来该计时的是从告警响起,到受影响的请求恢复正常。