2026年11月17日,微软在Ignite大会期间正式推出两款自研企业级代码模型MAI Code 2与MAI Code 2 Flash,并同步上线GitHub Copilot。微软直接把枪口对准了昔日的核心盟友,宣称MAI Code 2仅用40%的成本就达到了GPT-6.1 Sol 98%的性能,更以区区5%的成本实现了Claude Opus 5.5 96%的性能。但这张极具冲击力的价格海报背后,藏着一道单看通稿算不出来的算术题:微软用限时半价和主场评测包装了一场针对OpenAI与Anthropic的毛利保卫战。
40%成本背后的算术悖论与Token暗账
顺着GitHub Copilot的官方计费文档往下查,微软的定价底牌就会浮出水面。新闻稿里惊艳的40%与5%成本对比,全部建立在限时50%促销价的基础之上。目前MAI Code 2的促销期百万Token价格为输入$0.50、缓存输入$0.025、输出$2.50;一旦到了2027年5月17日恢复正价,这组数字将直接翻倍至输入$1.00、缓存输入$0.05、输出$5.00。
| 模型名称 | 百万Token输入价 | 百万Token缓存输入价 | 百万Token输出价 | 相对GPT-6.1 Sol测试总账单 |
|---|---|---|---|---|
| MAI Code 2(促销期) | $0.50 | $0.025 | $2.50 | 40% |
| MAI Code 2(恢复正价) | $1.00 | $0.05 | $5.00 | 约80% |
| GPT-6.1 Sol(标准API) | $2.00 | $0.10 | $10.00 | 100% |
| Claude Opus 5.5(标准API) | $4.00 | $0.20 | $20.00 | 约800%(MAI占其5%) |
把这张价格表摆在桌面上,一个反常的算术剪刀差就暴露出来了。促销期内,MAI Code 2的各项单位Token单价明明只有GPT-6.1 Sol的25%,为什么跑完基准测试后的实际账单却占到了后者的40%?
唯一的算术解释,是MAI Code 2在开启最大推理强度完成同一项编码任务时,实际吞吐和消耗的Token总量远高于GPT-6.1 Sol。同理,MAI Code 2单价是Claude Opus 5.5的12.5%,最终账单却压到了5%,说明Opus 5.5在测试中消耗了更庞大的Token。假如保持同样的Token消耗比例不变,等到明年5月促销期结束,MAI Code 2相对于GPT-6.1 Sol的真实单任务成本将直接飙升至80%左右,相对于Claude Opus 5.5的成本比例也会翻倍至10%。
单价打两折半,结账却付了四成,便宜的单价被更啰嗦的推理吃掉了。
模型卡里的数据打架与主场评测黑盒
除了价格口径的包装,微软同步放出的技术文档与评测方法论也留下了多处难以自圆其说的裂痕。在MAI Code 2官方模型卡(Model Card)第3节的质量与性能表里,MAI Code 2与轻量版MAI Code 2 Flash在DeepSWE 1.1基准上的得分被明确记为73.2%与59.9%;然而翻到同一份文档的第3.2.5.1节高级自主性表格,这两款模型在同一个DeepSWE 1.1上的得分却毫无解释地变成了60.2%与27.4%。
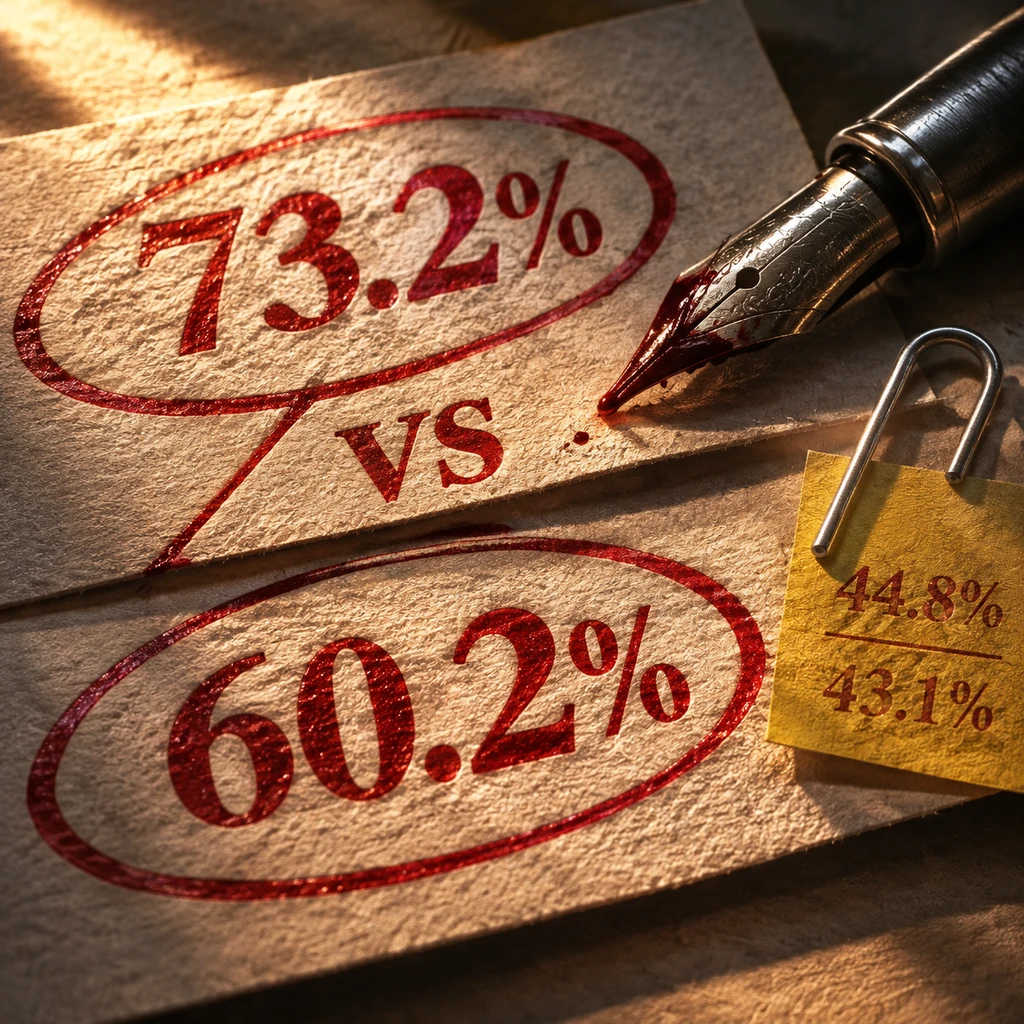
更让人困惑的是家族内部的尺寸倒挂。在Terminal Bench 2.1上,旗舰版MAI Code 2以84.6%正常领先于Flash版的78.3%;但在SWE-Atlas基准测试中,主打轻量高频的Flash版却考出了44.8%,反过来击败了仅得43.1%的旗舰版MAI Code 2。
就连不同官方宣传页面之间的口径也没能对齐。新闻稿正文写着MAI Code 2在前端应用盲测中面对GPT-6 Sol的评审偏好率是67%,到了Ignite 2026综述页就涨到了68%;新闻稿称MAI Code 2 Flash在三项日常编码基准上以65%和20%的成本实现了与GPT-6 Luna和Claude Haiku 5.5相当的性能,但模型主页却改口称其以五分之一的成本比Haiku 5.5高出12%的性能。
更深一层的限制在于评测脚手架(Harness)的绑定效应。微软引用的四项核心基准中,仅FrontierCode v1.1的分数与成本引自第三方机构Artificial Analysis,其余DeepSWE 1.1、Terminal Bench 2.1与SWE-Atlas三项全部运行在微软内部的MSBench平台上。微软在测试中统一强制使用禁用子Agent的GitHub Copilot CLI(v1.0.102)并开启最大推理强度,每项任务独立运行3次取单次尝试通过率均值,且将基础设施报错直接计为失败。
要知道,由Datacurve构建的DeepSWE包含跨越91个代码库和5种编程语言的113项原创工程任务,其官方首发评测使用的是mini-swe-agent框架;而OpenAI当初发布GPT-6.1 Sol并宣称追平Astra且成本仅为后者五分之一时,用的也是OpenAI内部研究环境与API。在AI编程评测高度依赖外围工具链与提示词模板的今天,把外部模型拉进微软深度调优的自家Copilot CLI里同台跑分,天然带有主场哨优势。
- 风险.微软至今未公开MSBench的完整复现包,不同Agent脚手架下的DeepSWE跑分无法直接横向混排对比,企业不能单凭官方跑分就断定其在自有工具链中能复现同等水平。
放弃造神之后,企业技术团队该怎么接招
为什么微软宁可顶着跑分争议,也要在新闻稿里坦白MAI Code 2系列明确不对基础科学研究和超长周期Agent任务做调优?因为微软正在编程与网络安全等领域全面推进垂直专用模型战略,试图把GitHub Copilot从昂贵的通用前沿大模型税中解救出来。
在企业日常研发里,80%以上的Token消耗来自代码投产、深度调试、多文件修改、全仓库推理、UI可视化图表,以及Flash版本主攻的代码解释、定点修改与常规修复。长期为这些高频日常活计调用Claude Opus 5.5或GPT-6.1 Sol,无异于用超算杀鸡。微软通过裁剪长周期极端推理能力,把算力集中投向日常工程,既能压降向OpenAI和Anthropic支付的API分成,又能把Microsoft Foundry推向企业定制前台。
微软在模型主页晒出的两家标杆客户证言,恰恰暴露了这种垂直微调的真正玩法。AT&T称其定制版MAI Code 2 Flash在标准5G网络分析任务中表现优于GPT-6.1 Sol,且成本降低了50倍;丰田旗下的Woven by Toyota则表示,用自身MISRA修复历史数据微调后的版本,在其他前沿模型需要人工返工的案例中有44%直接生成了可合并的修复代码,成本还不到十分之一。
但对于正在规划明年研发预算的企业CTO和工程团队而言,AT&T和丰田的数字是深度微调后的定制果,绝非在Copilot里开箱即用的基座表现。目前MAI Code 2与Flash虽已上线GitHub Copilot,但Flash在Microsoft Foundry仍处于受限预览阶段,而OpenRouter、Vercel、Hermes、OpenCode与Kilo等第三方渠道仅被标记为即将推出,尚未公布具体上线日期。
- 建议.工程团队在未来半年内可充分利用MAI Code 2的半价红利分流前端UI编写与日常调试任务,但在做长期工具链绑定与预算测算时,务必按2027年5月恢复后的正价标准,在自有代码库和真实脚手架中核算单次可合并代码的实际Token总账单。