2026 年 10 月 27 日,Liquid AI 发布了新一代基础模型家族 LFM3,试图把文本、图像、视频、语音和结构化决策全部塞进 2B 参数量级的边缘设备里。这套模型在 4-bit 量化下的静态权重压到了 1GB 左右,在工具调用与流式语音交互上跑赢了不少大尺寸竞品;但翻开 Hugging Face 上的底层模型卡就会发现,官方亲手写下了不建议用于复杂推理、编程和视觉多轮对话的警告——它从一开始就放弃了当一个缩水版全能大模型,而是一套必须靠单卡微调才能上岗的垂直任务毛坯房。
1.7B 主干撑起六款模型,算力省在混合架构与自研编码器
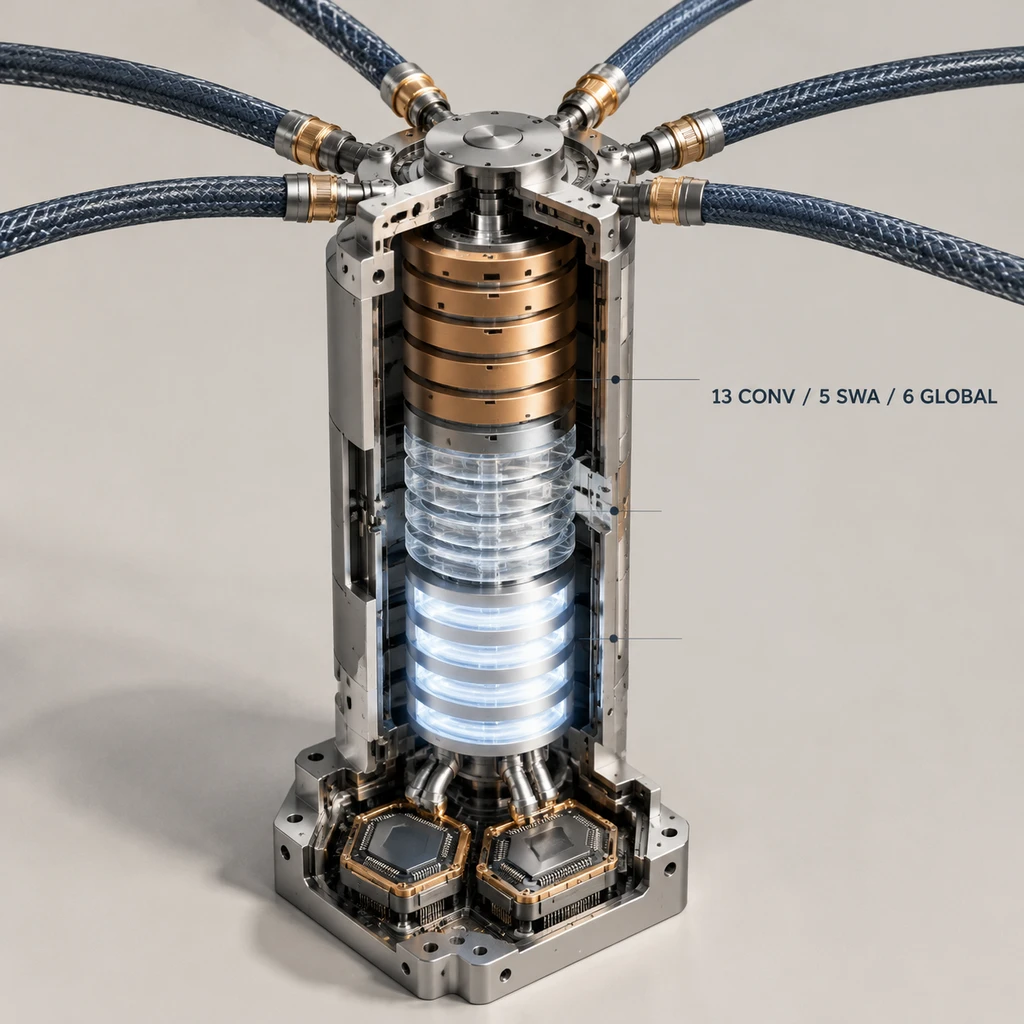
传统纯 Transformer 架构在端侧设备上跑长文本或多模态时,很容易被膨胀的 KV Cache 显存和首字延迟拖垮。Liquid AI 针对手机、树莓派 5、笔记本和高通 Hexagon NPU 等 14 种软硬件组合做了硬件在环架构搜索,把经过 22T tokens 预训练的 LFM3-1.7B-Base 改造成了 24 层的三混合架构:由 13 层门控短卷积(卷积核从上一代的 3 扩大到 7)、5 层 256 窗口的滑动窗口注意力,以及 6 层全局注意力拼接而成。
靠着这套混合底座,LFM3-1.7B 在参数量比上一代 LFM2.5-2.6B 减少 35% 的前提下实现了反超,8K 上下文推理速度提升约 25%。在网页与商业软件长链路操作评测 WebArena-Verified 中,LFM3-1.7B 拿下了 38.42 分(前代仅 3.02 分),甚至越级击败了 Qwen3.5-9B。
在此主干之上,Liquid AI 一次性衍生出 6 款 2B 级别模型:除了纯文本版 LFM3-1.7B、支持视频输入的 LFM3-VL-2B、支持 18 国语言语音交互的 LFM3-Audio-2B,还首次推出了能同时看图、看视频并实时听说的全模态模型 LFM3-Omni-2B,以及两款专攻单次前向传播输出概率校准结果的决策模型 d1-2B 和 d1-omni-2B。
真正帮端侧设备减负的,是配套换血的两颗自研编码器。LFM3 的 164M 视觉编码器同样混用了卷积与注意力,比上一代采用的 SigLIP2 节省了 3 倍算力,在维持与 Qwen3.5-2B 视觉编码器同等精度的同时,浮点运算量(FLOPs)降低了 2.2 倍;因果音频编码器则把首 token 延迟(TTFT)压到了 50 毫秒,配合自研的 LiquidCodec 语音分词器,在 Apple M4 Max 的单核 CPU 上就能跑出 87 倍实时率的流式语音生成。
宣传博文与模型卡的温差,藏在长窗口、显存与能力禁区里
如果只看官方发布博文,开发者很容易以为自己拿到了一个仅占 1GB 内存、拥有 256K 超长上下文、能在本地通吃复杂 Agent 的全能底座。但把官方博文与各模型的 Hugging Face 模型卡放在一起对账,就能看到三处直接影响工程落地的限制。
256K 上下文(262,144 tokens)是纯文本模型 LFM3-1.7B 的专属待遇。到了视觉模型 LFM3-VL-2B,最大上下文折半至 128K;而在全模态模型 LFM3-Omni-2B 上,窗口更是直接缩水到了 32K。即便只看纯文本版,官方目前只给出了到 128K 的长文本测试成绩,其 RULER 128K 得分为 65.56,明显低于 Qwen3.5-4B 的 84.63 和 Qwen3.5-9B 的 87.11。
所谓的 1GB 体积,指的也只是 GGUF 格式下的静态权重文件大小(Q4_0 为 1.05 GB,Q4_K_M 为 1.10 GB),而非运行时的总内存。LFM3 依然保留了 6 层全局注意力,一旦在端侧真正把上下文拉长到 128K 甚至 256K,KV Cache 依然会推高内存与显存开销;更何况官方公布的长文本跑分全部是在 3.47 GB 的 BF16 精度下测出的,4-bit 量化之后的长窗口精度衰减仍有待社区独立实测验证。
砍掉通用慢思考,换来端侧毫秒级流式响应与低成本微调。
最诚实的还是模型卡里的能力劝退声明。Liquid AI 明确提醒开发者,不要把 LFM3-1.7B 用于 Agentic 编程或复杂多步推理;不要把每秒采样 2 帧视频的 LFM3-VL-2B 用于编程、多轮对话和复杂推理;而 LFM3-Omni-2B 干脆就是一个不支持开启思考模式(enable_thinking=True)的非推理模型,在 OmniBench 上的总分为 46.32。
端侧 2B 至 4B 混战,开发者该怎么避坑选型
在手机、AIPC 与物联网设备争夺的 1GB 到 3GB 内存区间里,同台竞技的还有阿里的 Qwen3.5(2B/4B)与 Google 的 Gemma 4 E2B。要把账算清楚,硬件与端侧团队得先穿透各家标称参数的迷雾。
| 模型版本 | 标称与实际总参数 | 体积与内存口径真相 | 核心强项与短板对照 |
|---|---|---|---|
| LFM3 家族 | 1.7B / 2B | Q4_0 静态权重 1.05GB,BF16 为 3.47GB | 强于工具调用、UI 定位与低延迟语音;弱于复杂推理与长文 |
| Qwen3.5-2B / 4B | 实际为 2.3B / 4.7B | 真实体积高于字面标称级别 | 强于 128K 长文本(84.63)、复杂视觉推理与 OCR |
| Gemma 4 E2B | 实际总参数达 5.1B | 部署包 2.58GB;宣称 676MB 仅计入 CPU 内存 | 视觉基准与 LFM3-VL-2B 相当,但实际 GPU 显存占用更高 |
从前代基线延续至今的技术路线看,端侧根本不存在通吃全场景的冠军。LFM 系列把技能点全加在了格式遵循与界面交互上,比如 LFM2.5-2.6B 在工具调用 BFCLv4(56.88 对 50.56)和指令遵循 IFBench(59.17 对 48.40)上压过 Qwen3.5-4B,LFM2.5-VL-3B 在屏幕元素定位 ScreenSpot-v2 上拿到 80.7 的高分;但一旦进入需要深度思考的复杂视觉推理 MMMU-Pro(30.5 对 60.9)和 OCRBench v2(47.5 对 58.8),参数底子更厚的 Qwen3.5-4B 依然具备统治力。
对于正在做选型的工程团队,LFM3 最具不可替代性的价值集中在两处。一是需要在一个极小包体里同时塞进流式语音听说、实时画面感知与本地工具调用的硬件团队(如智能眼镜、车载语音助手或树莓派机器人),LFM3-Omni-2B 能直接省去分别维护 ASR、VLM、LLM 和 TTS 四套模型的工程灾难;二是处理工单分类、发票提取或界面状态判断的业务团队,d1-2B 系列可以用单次前向传播直接吐出带校准概率的结构化答案,完全绕开自回归文本生成的延迟。
- 风险.Liquid AI 虽然承诺全系支持单 GPU 微调,但目前尚未公布 LFM3 专属的微调显存门槛,官方文档链接的 TRL 微调教程仍停留在 LFM2/2.5 的 LoRA 阶段;同时该系列采用修改版 LFM Open License v1.0 协议,仅对年营收低于 1000 万美元 的企业免费开放商用,超标的大中型企业在将它写进产品底座前,必须先算清商业授权的合规账。