2026年10月27日,Google DeepMind 放出了世界模型 Genie 4 的研究预览版,把连续场景一致性拉长到了两分钟,比前代翻了一倍,还第一次加上了实时音频和中途打字改场景的能力。看着很热闹,但翻完官方材料,最耐人寻味的反而是它没说的数字——2025年8月5日发布 Genie 3 时,Google 大方标出了 720p 分辨率和 24 fps 的实时导航参数;到了号称更逼真的 Genie 4,官方通稿里却把分辨率与帧率这两个硬指标藏了起来。
先把这次更新的底牌亮清:
- 发生了什么.Genie 4 支持在模拟运行中随时输入文本改变天气、视角或增减人物,同步生成音乐、环境音与对话,将在未来几周内向 Project Genie 中的 Google AI Ultra 订阅者及 Gemini API、Google AI Studio 早期合作伙伴开放。
- 为什么重要.世界模型赛道正在经历剧烈的资本收编,AMD 刚以 82 亿美元收购李飞飞的 World Labs,亚马逊正洽谈以约 70 亿美元收购 Decart,Rivian 也买下了 Third Dimension 用于自动驾驶仿真,大厂都在抢实时虚拟环境的底层入口。
- 谁受影响.影视分镜师多了一个保持创意心流的草图工具;但指望用它训练真实机器人的具身智能团队,现在进场还太早。
被藏起来的帧率,与两种“导演”路线
不提分辨率和帧率,往往是因为亮出来不够好看。就在2026年9月3日,竞争对手 Runway 发布了 GWM Worlds 2,把硬参数直接拍在桌面上,明确支持 720p 分辨率、24 fps 持续生成以及 48 kHz 的音视频联合生成,而且没有预设的会话时长上限。连同两分钟的上限口径,Google 内部都没完全对齐,科技媒体的简报写着最高两分钟,DeepMind 官方模型页却只敢含糊地写支持几分钟的连续交互。
| 对比维度 | Google Genie 4 | Runway GWM Worlds 2 | Google Genie 3 |
|---|---|---|---|
| 发布时间 | 2026年10月27日 | 2026年9月3日 | 2025年8月5日 |
| 视频硬参数 | 官方未公布 | 720p / 24 fps | 720p / 24 fps |
| 实时音频 | 支持音乐/环境音/对话 | 支持 48 kHz 音视频联合生成 | 不支持 |
| 连续时长上限 | 最高 2 分钟(官方页称数分钟) | 无预设会话时长限制 | 最高 1 分钟 |
我更在意的是行业里对实时(Real-time)这个词的文字游戏。24 fps 只是画面输出的帧率,代表两帧之间间隔 41.7 毫秒;但玩家按下一个键、或者输入一句修改天气的提示词,到底要等多少毫秒画面才会响应?无论是 Google 还是 Runway,在发布材料里都对输入响应延迟保持了沉默。
在怎么让虚拟世界听懂人话这件事上,两家公司走出了完全不同的控制架构。
Runway 走的是上下文拼接路线,靠持久场景上下文、带时间戳的文本动作、连续相机输入和近期帧滑动窗口来维持画面。而 Google 研究总监 Tejas Kulkarni 押注的是混合世界模型:让 Gemini 充当总导演,负责写代码和文本、拆解任务步骤,并实时盯着 Genie 4 生成的每一帧画面检查进度。这种左脑规划、右脑画画的架构听着很美,但当Google把它包装成机器人训练场时,问题就来了。
机器人下跳棋?那只是昂贵的文生视频分镜
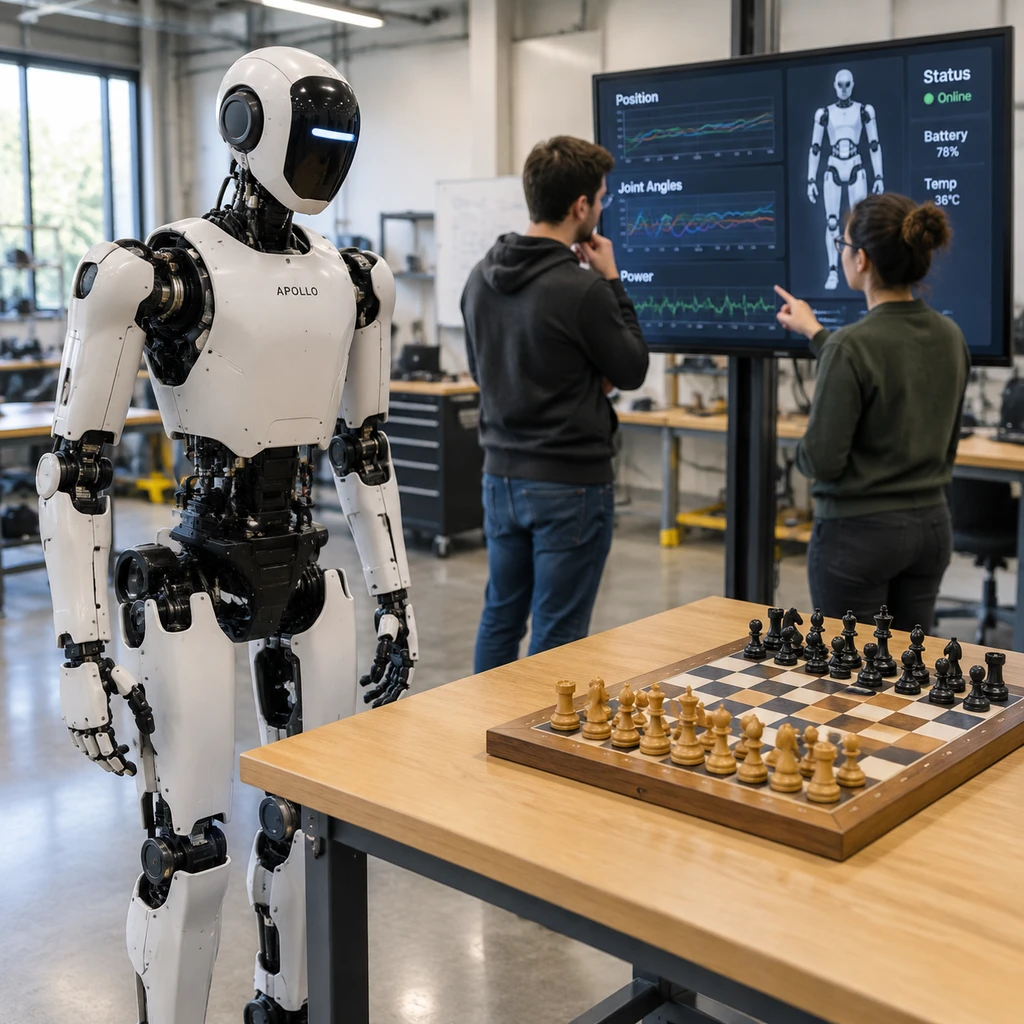
这次发布会最抓人眼球的演示,是 Gemini 4 Argon 与 Genie 4 联动,在虚拟环境里测试机器人场景。普通读者看完很容易以为 Google 攻克了具身智能的物理仿真,但扒开实验底裤就会发现,它模拟的是 Apptronik 的 Apollo 人形机器人下跳棋——由 Argon 把下棋任务拆解成一段段文本说明,再喂给 Genie 4 画出画面,全程没有涉及真实物理硬件控制,也没有任何从仿真到现实(Sim-to-Real)的迁移验证。
把分镜脚本画成动画,不等于教会了钢铁手指怎么捏起棋子。
《韩非子》里讲画鬼最易,画犬马最难。鬼神无形,怎么酷炫怎么画;犬马天天在眼前跑,物理关节差一毫米都会穿帮。生成式世界模型画出来的跳棋局,本质上是像素层面的概率拼贴,而不是计算摩擦力、刚体碰撞和力矩的精确物理引擎。
更扎心的是充当大脑的 Gemini 4 Argon 自己还自身难保。德克萨斯大学达拉斯分校(UT Dallas)研究人员在2026年10月21日刚发了一份独立评测报告,把 Argon 拉到 LIBERO-10 机器人操作基准测试里溜了一圈,结果相当骨感。
在 100 个测试回合里,Argon 开启高推理努力也只拿下了 43 次成功(对比 GPT-6 Astra 为 44 次),16 次失败,更有 41 次直接因为评估或服务商限制半途夭折。报告还点出了它的软肋:遇到精细空间排列就犯迷糊,请求的动作和实际执行的动作经常对不上,而且跑一回合的 API 预估成本高达 7.84 美元。
- 风险.连 Google 团队自己都承认,Genie 4 运行时间一长或经过多次复杂编辑,画面里的物体和细节就会发生恒常性漂移,连画面里的文字都还看不清;拿一个物体会漂移、单回合规划要烧掉近 8 美元的模型去替代传统物理仿真器,具身智能创业公司的账本根本算不过来。
别盯着机器人,电影分镜才是真买家
把那些宏大的物理仿真叙事撇掉,Genie 4 真正能立刻换来钱的地方,其实是早期测试者自己摸索出来的电影原型制作。
好莱坞在 1990 年代末普及数字化动态预演(Pre-vis)时,导演们为了在实拍前看清复杂的镜头调度,不得不雇佣一整个 3D 动画团队花几个月搭简模。今天的情况和当年有几分相似,只是算力把几个月的建模压缩到了几秒钟,但不完全一样的是,当年简模的几何空间是锁死的,而今天的世界模型随时可能在你转头时把桌上的咖啡杯变没。
可对分镜师和独立导演来说,咖啡杯变不变没根本不重要。Google DeepMind 工程师 Diego Rivas 点破了关键:在构思和画分镜的阶段,最值钱的是保持创意心流。导演脑子里闪过一个雨夜追车的念头,当场打字把晴天改成暴雨、把机位拉到车顶,伴随实时生成的雨声和背景乐,两分钟的连续交互足够把一场戏的调度试出三四个版本。
顺着这个切口看,Google 手里的影视工具链其实已经在暗中合拢:
先用 Project Genie 里的 Genie 4 实时捏出分镜草图,未来再交给多模态大模型 Gemini Omni 转化成标准创作资产,最后用已经受电影人欢迎的 Veo 渲染出带同步音频的高清成片。虽然 Rivas 坦承这套端到端体验离跑通还有一段距离,但这条路比硬啃机器人仿真要务实得多。
- 建议.如果你做的是影视预演、游戏关卡原型或互动教育概念设计,未来几周开放的 Project Genie 值得立刻上手当草稿纸用;但如果你在做机器人控制算法,不妨等 Google 敢把分辨率、输入延迟和空间误差率写进发布会文档的那天,再掏腰包买它的 API。