当软件工程团队开始全员接入 Devin 或 Cursor 时,管理层预想的通常是开发速率成倍提高。但很多人没料到,代码产出加速的代价,最先兑现在 CI(持续集成)机器的账单和无休止的排队上。
项目管理工具团队 Linear 内部就遇到了这个急迫的工程瓶颈。随着 AI Agent 在日常开发中密集提交代码,其代码库的测试用例规模在几个月内增长了近4倍。代码写得快了,但每次提交依然要完整跑一遍自动化检查;机器资源被高频并发的提交迅速挤爆,开发者与 Agent 只能干等。为此,Linear 对整套 CI 体系动了一场外科手术:在测试量膨胀数倍的前提下,将 PR 验证等待时间从超过 6 分钟压回刚过 5分钟,单次测试所消耗的机器时间削减了约 50%。
摆脱托管机依赖与重写语言工具链
多数团队在遇到 CI 拥堵时,第一反应是开更大并发,试图用并行机器填平耗时。但 Linear 的第一刀切向了最底层的计算硬件与语言工具。
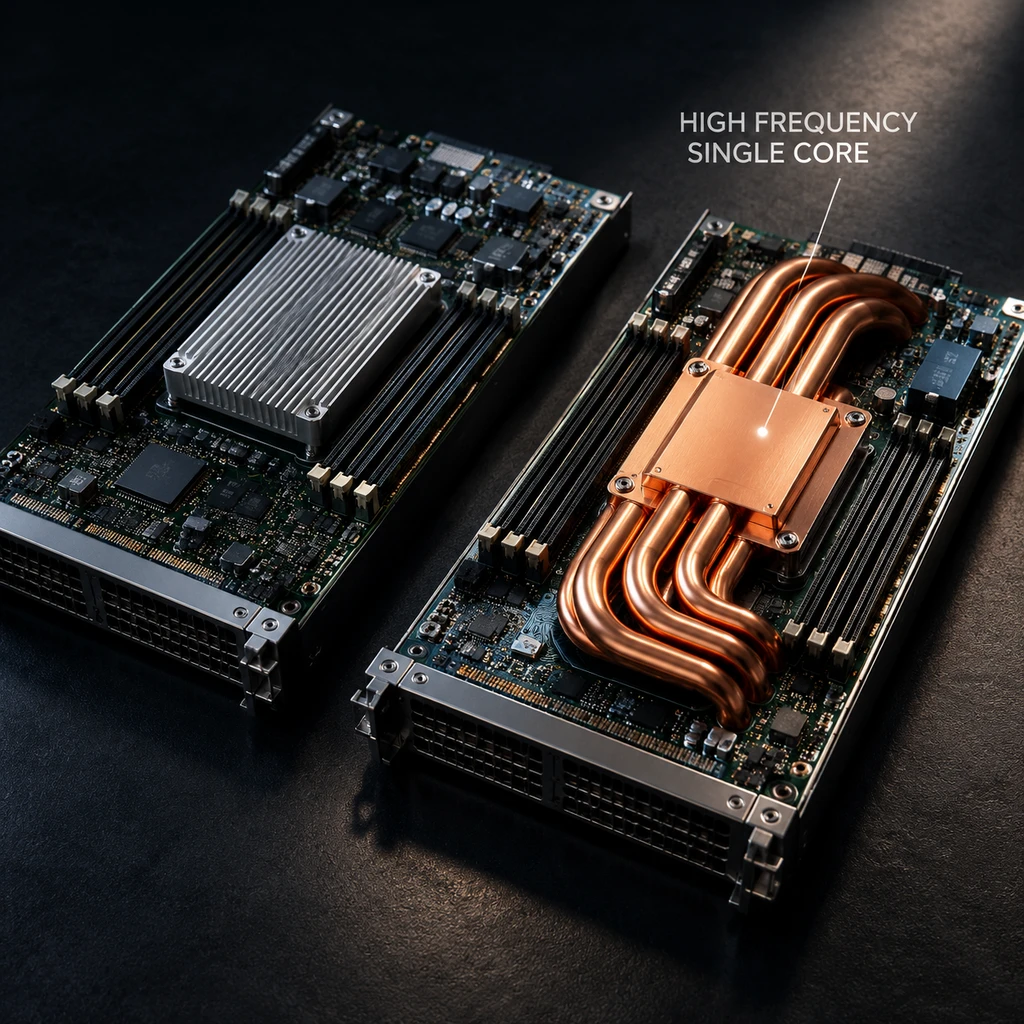
他们首先将工作负载从 GitHub Actions 的默认托管机彻底迁出,换成具备更高单核主频、高性能本地存储与定制缓存网络的第三方 Runner。在配置完全对齐的同等任务测试中,仅仅换掉机器,任务平均耗时就直接缩短了34%;尤其对于依赖单核性能的 TypeScript 编译任务,耗时降幅达到了 52%。单核计算能力的上限,直接决定了流水线关键路径的硬天花板。
随后的重点是工具链原生化与规则解耦:
- 引入原生编译器.他们放弃了基于 Node.js 运行的官方 tsc 检查器,改用 Go 语言编写的原生编译器 tsgo,将每周类型检查的中位数耗时压缩了73%,彻底将类型检查移出了阻塞队列。
- 解耦代码规范检查.过去他们的 ESLint 自定义规则严重依赖类型元数据,每次执行必须先构建完整的类型依赖图,内存开销极高。Linear 将这些规则重写为基于抽象语法树(AST)的纯语法静态分析,使 API 模块检查耗时降低 68%,仓库整体检查耗时下降 55%,随后顺利迁往 Rust 驱动的 Oxlint。
门控剪枝与动态分片的细节算计
消除了单点大山后,剩下的瓶颈全是微小的工程摩擦。在复杂的流水线里,前置任务哪怕只慢几十秒,后续所有并行测试集群都会被迫停滞。
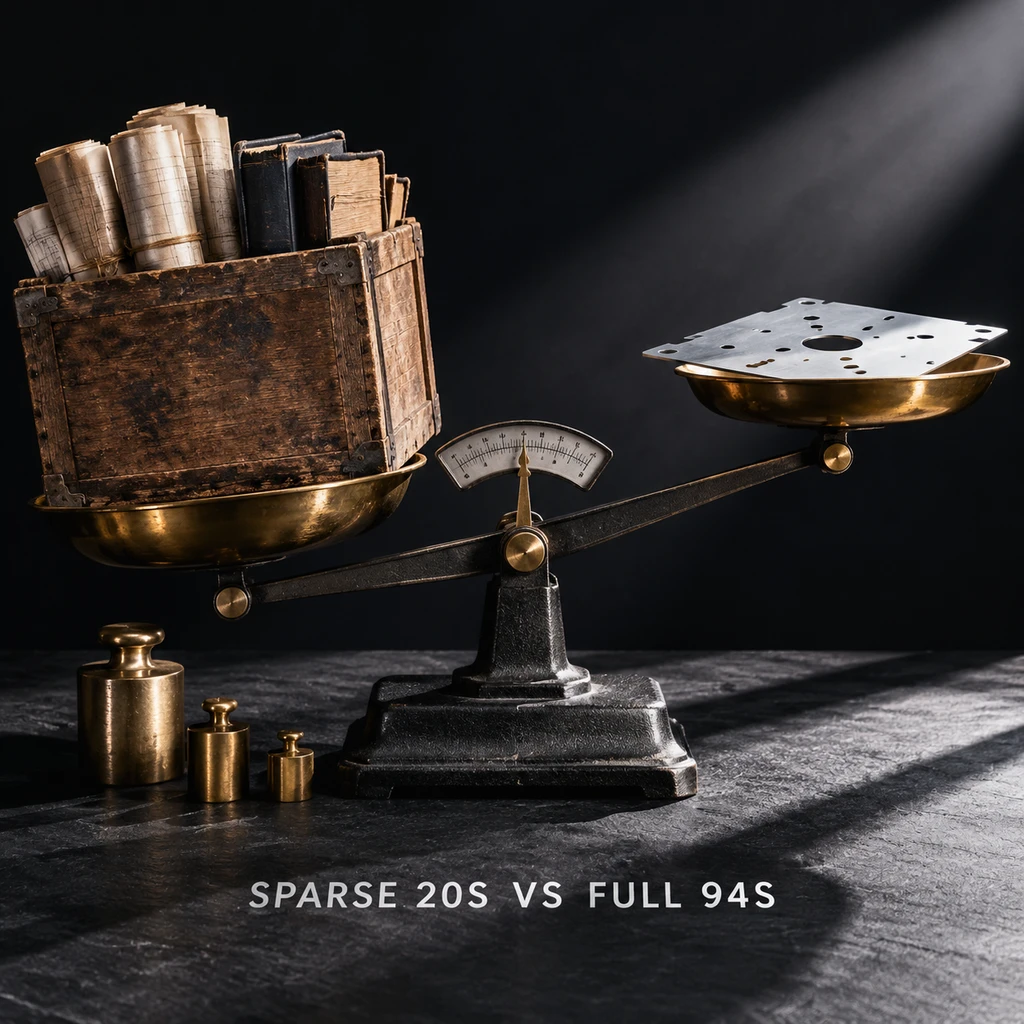
古人治水讲究深淘滩、低作堰,疏导流水线的核心在于减少不必要的空转。在检测变更范围的前置门控任务中,原先的脚本无论只需读几行改动,都会执行完整的 Git 仓库拉取。Linear 重新梳理了门控逻辑:仅针对必要分支做无 blob 稀疏克隆,不需工作树的任务彻底移除拉取步骤。最慢的前置门控任务耗时从 94秒骤降至20秒,不需要代码树的任务从 27 秒缩短至 7 秒,加载中位数由 26秒降至8秒。
随后的测试分片优化则针对了长尾效应。测试框架 Vitest 默认按文件数量均分任务,导致某些包含复杂场景的大型测试文件独占某个执行容器,其他容器早已跑完,流水线却被卡在最后一个分片上。Linear 改用按历史执行时长动态切分测试集合,打碎集中耗时文件,配合有条件关闭测试沙箱进程隔离来复用模块缓存,单点最慢的分片时长直接压下去了近两分钟。
软件开发从不缺生产速度,真正的瓶颈永远卡在吞吐与验证的交界处。
- 结论.盲目堆叠云端并发是低效的财务黑洞,解耦 AST 语法分析与优化 Git 稀疏拉取等底层细节,投资回报率远高于扩容机器。
生产力转移背后的自证陷阱
Linear 的实践给行业上了生动的一课,但它同时也揭开了当前 AI 研发浪潮中被粉饰的一面。
人类工程师写代码是离线且低频的,提交一次可以转身去泡咖啡,等待 15 分钟并不致命。然而自主 Agent 的工作方式是试错驱动的微步迭代:改动几行、推入仓库、等待结果、报错后再改。中心化 CI 的延迟被 Agent 的高频动作施加了乘数级放大。在没有本地隔离沙箱的情况下,把昂贵、庞大的中心化 CI 当作 Agent 的交互式反馈终端,本质上是用昂贵的集群算力替低质量的代码探索买单。
更关键的问题并不在 CI 流水线本身。测试集膨胀 4 倍并不必然意味着软件架构更可靠。当编写测试用例和实现业务代码的任务都交由 Agent 完成时,工程极易滑入自证陷阱:模型在用自己编织的假设来验证自己写的代码,测试看似全部亮绿灯,却可能完全偏离了真实的业务约束。CI 跑得再快,最后的风险兜底依然被原封不动地推给了人类评审者。当代码像潮水一样涌出,怎样在不被淹没的前提下判定代码是否可用,才是这轮效率变革真正尚未结清的账单。
- 提醒.警惕用膨胀的测试集掩盖架构缺陷,测试与实现皆出自 AI 之手时,绿灯通过只代表逻辑自洽,不代表业务正确。