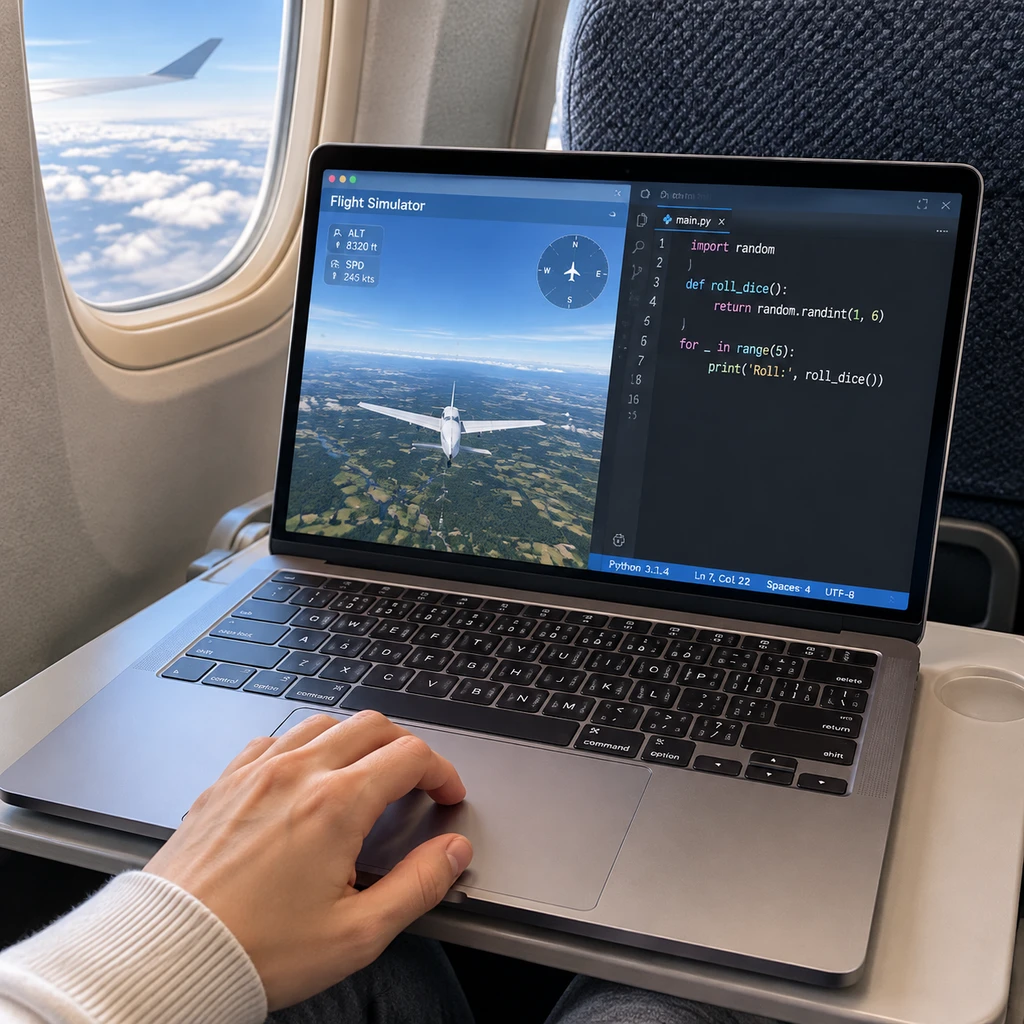
Thinking Machines Lab 宣布开放 Inkling 2 Mini 的权重,并通过 Tinker 提供推理和定制。这款混合专家模型有 264 亿参数,发布方称总内存占用约 20GB,还展示了它在一台配有 M5 Pro 和 48GB 内存的 MacBook Pro 上,断网做出可玩的飞行模拟器。演示给了离线开发团队一个试用理由,还不足以成为换机依据。
与同级的 Qwen3.8-27B 相比,Inkling 2 Mini 在发布方列出的多项编程测试中得分更高,却在 AA-Omniscience 的事实性测试中落后。第三方数据也给出了托管端的速度优势,但测的并非编程代理交付。选型真正要比的是,在相同预算下,哪款模型更快交出能通过测试的补丁。
Inkling 2 Mini 的编程分差混有配置差异
在 DeepSWE v1.1 上,Thinking Machines Lab 报告 Inkling 2 Mini 得分 48.2%,对照的 Qwen3.8-27B 是 42.2%。但前者使用 mini-swe-agent v2.4.6,后者对应的公开配置使用 Claude Code 和 256K 上下文。代理框架会影响模型怎样调用工具、运行测试和处理报错,这 6 个百分点不能全算作模型本身的优势。
更值得作为复测起点的是 SWE-bench Pro v2 Hard。发布方在 mini-swe-agent v2.4.6 条目下列出两款模型在 51 道题上的成绩,分别为 77.9% 和 73.8%。这个对照至少把代理框架列在了同一口径下,但仍是发布方报告,尚无独立同条件复测。它回答了有多少题做对,没回答做对一题要等多久。
托管端用时约四分之一,输出反而更多
Artificial Analysis 在两款模型取得相同 Intelligence Index 分数的情况下,按输出 token 用量和托管端点速度估算,Inkling 2 Mini 平均每题用时 9.0 分钟,Qwen3.8-27B 在 xhigh 推理档位下为 38.2 分钟。Inkling 2 Mini 用时约为对手的四分之一,输出 token 却多约 38%。至少在这组跨模型对照里,速度优势不能归功于少写 token。
<svg viewBox='0 0 760 248' width='100%' height='248' role='img' aria-label='同分指数题的托管端估算耗时,Inkling 2 Mini 为 9.0 分钟,Qwen3.8-27B xhigh 为 38.2 分钟'><rect x='1' y='1' width='758' height='246' rx='8' fill='#fbf9f4' stroke='#e2dccf'/><text x='28' y='38' font-size='19' font-weight='700' fill='#b25a3a'>同分指数题耗时</text><line x1='28' y1='54' x2='732' y2='54' stroke='#e2dccf' stroke-width='1'/><rect x='28' y='82' width='340' height='106' rx='8' fill='#fbf9f4' stroke='#e2dccf'/><rect x='392' y='82' width='340' height='106' rx='8' fill='#fbf9f4' stroke='#e2dccf'/><text x='198' y='111' text-anchor='middle' font-size='14' fill='#7a7266'>Inkling</text><text x='562' y='111' text-anchor='middle' font-size='14' fill='#7a7266'>Qwen xhigh</text><text x='198' y='159' text-anchor='middle' font-size='36' font-weight='700' fill='#b25a3a'>9.0 分钟</text><text x='562' y='159' text-anchor='middle' font-size='36' font-weight='700' fill='#2c2822'>38.2 分钟</text><text x='380' y='216' text-anchor='middle' font-size='13' fill='#7a7266'>托管端估算值</text></svg>这组估算反映的是指定端点和推理档位的表现,既不是同硬件对跑,也没有计入编程代理反复调用工具、等待测试和返工的时间。编程代理平台若要决定是否换默认模型,可以用同一批任务、同一套工具和上下文上限,给两边相同的推理预算,再同时看通过率和首个通过测试的补丁耗时。只给成功的任务计时,会漏掉那些耗尽预算也没交付的尝试。
约 20GB 的内存口径还不能用来选电脑
Inkling 2 Mini 每生成一个 token,就把中间层运行三遍。循环复用同一套权重,无需为每遍计算另存一份参数,但仍得重复读取和计算。单次激活参数为 34 亿,计入循环后,每个 token 的权重激活量相当于 54 亿。发布方的解码曲线是在 614 GB/s 带宽、BF16 权重和批大小为一的条件下算出的理论上限,并非演示那台 MacBook Pro 的实测速度;模型发布版的大部分权重用的是 NVFP4。
打算把代码留在本机的团队,部署前要核对权重能否下载、许可是否允许自己的用途,不能把开放权重等同于开放源码。硬件预算则要看约 20GB 的口径是否覆盖运行时和上下文缓存,再用自己的代码库测峰值内存和补丁交付时间。飞行模拟器可以在 48GB 的机器上跑起来,真正影响采购的是把仓库文件、工具输出和失败日志都放进上下文之后,现有机器还能不能稳定完成任务。