英伟达发布了连续扩散语言模型 Nemotron-Labs-Sigma,覆盖 3B 和 8B 两种参数规模。Hugging Face 模型卡所列发布日期是 2026 年 11 月 12 日;MarkTechPost 在 11 月 20 日报道了这次发布,并给出 14 个检查点的总数。
Sigma 把文本生成的一部分从逐个处理变成了成块处理。同一块里,多个位置可以一起更新;到了块与块之间,后面的块仍要等前面的块完成。这给推理提速提供了一条可测试的路线,但各版本标注的去噪调用次数,还不能回答用户多久看到文字、服务能同时接住多少请求。
Sigma 的检查点覆盖两种规模和多种推理策略
Hugging Face 模型卡显示,两种规模各有基础版和指令版,基础版权重均提供 Safetensors 文件。官方集合还列有少步蒸馏和自推测变体。报道中的总数不能读成 14 种架构,现有报道也未逐项列出清单。选型时,比总数更有用的是分清哪些权重适合继续训练,哪些用于测试指令任务,哪些用于比较推理策略。
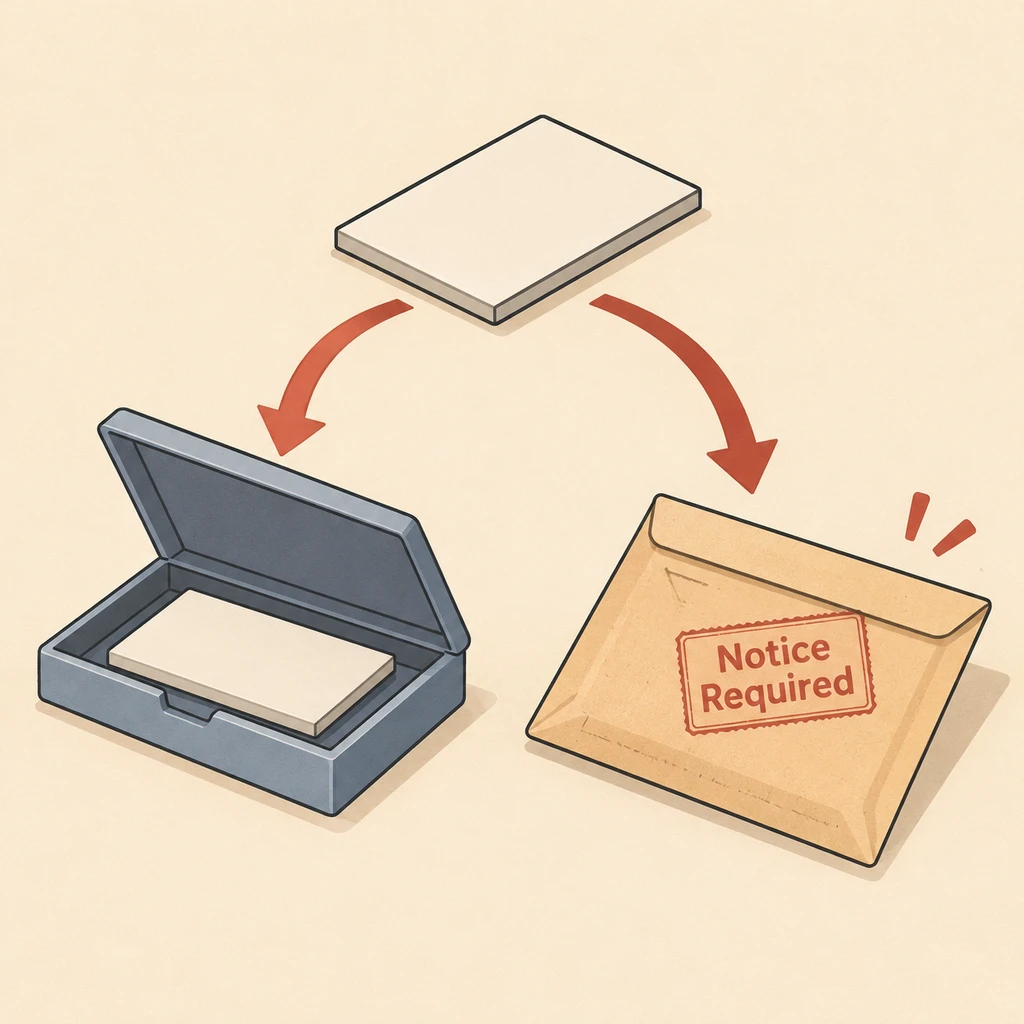
基础版和指令版采用 NVIDIA Nemotron Open Model License,允许商业使用,也允许分发原始或修改后的权重,但须遵守再分发和通知条款。英伟达不主张生成内容的所有权。对部署团队而言,下载权重做对照测试,与把权重打包交付客户,是两件需要分别核对的事。
Sigma 在块内并行,提交顺序没有变
与 LLaDA、Dream 在离散 token 上做扩散不同,Sigma 在连续嵌入空间里去噪。论文《Large Language Continuous Diffusion Models》描述了一个仅解码器 Transformer:模型从噪声出发,在同一轮调用里更新当前块的多个位置,每个位置由 16 维向量表示。去噪结束后,模型才把向量映射回离散 token。因果注意力让它读取提示和已完成的块,后续块仍依赖前一个块交出的结果。
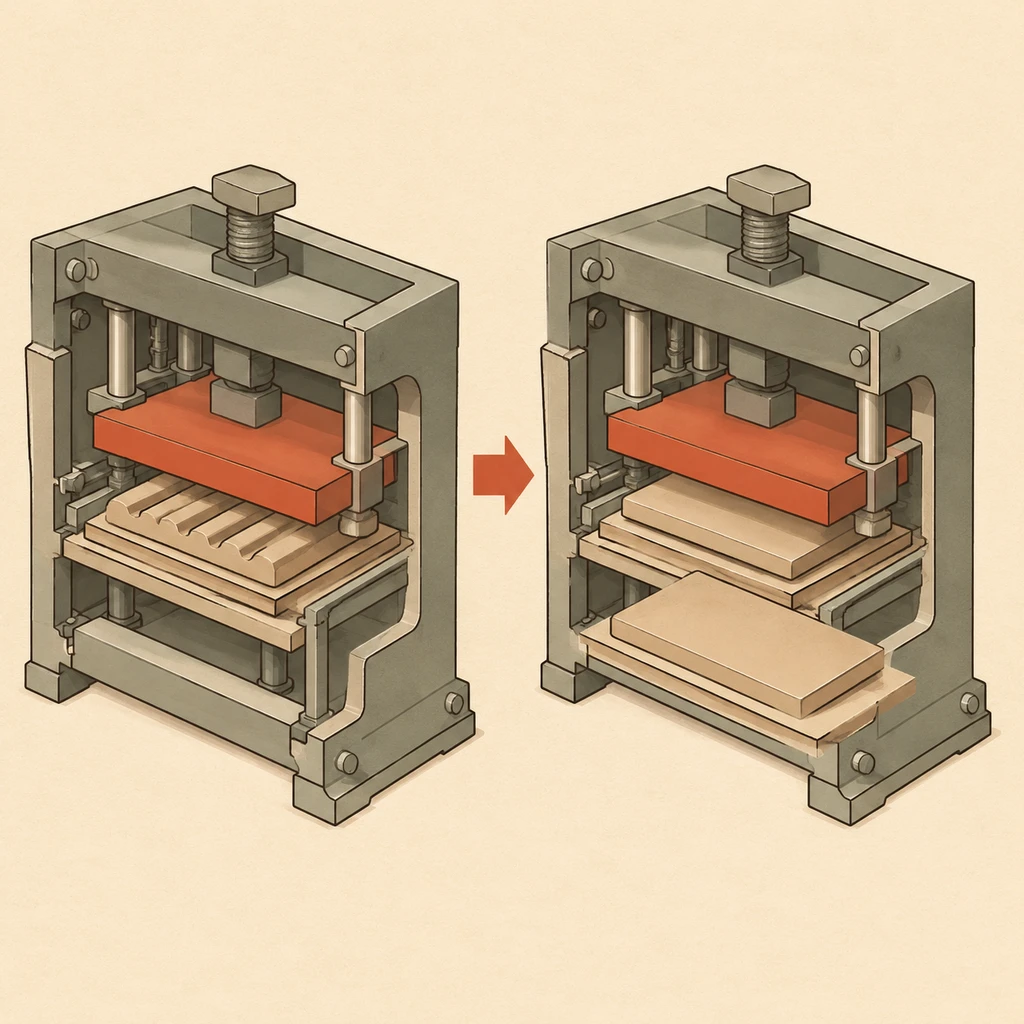
新增扩散组件占总参数不到 1%,但训练并非从零开始。论文称,研究者先用一个经过约 1 万亿 token 预训练的自回归模型初始化,再用约 3000 亿 token 进行块扩散训练,并保留辅助自回归损失。公开检查点可以用来复测生成表现;训练数据未随权重发布,研究者难以完整复现训练,也不能把最终表现全归功于连续扩散。
去噪器少跑几轮,服务未必更快
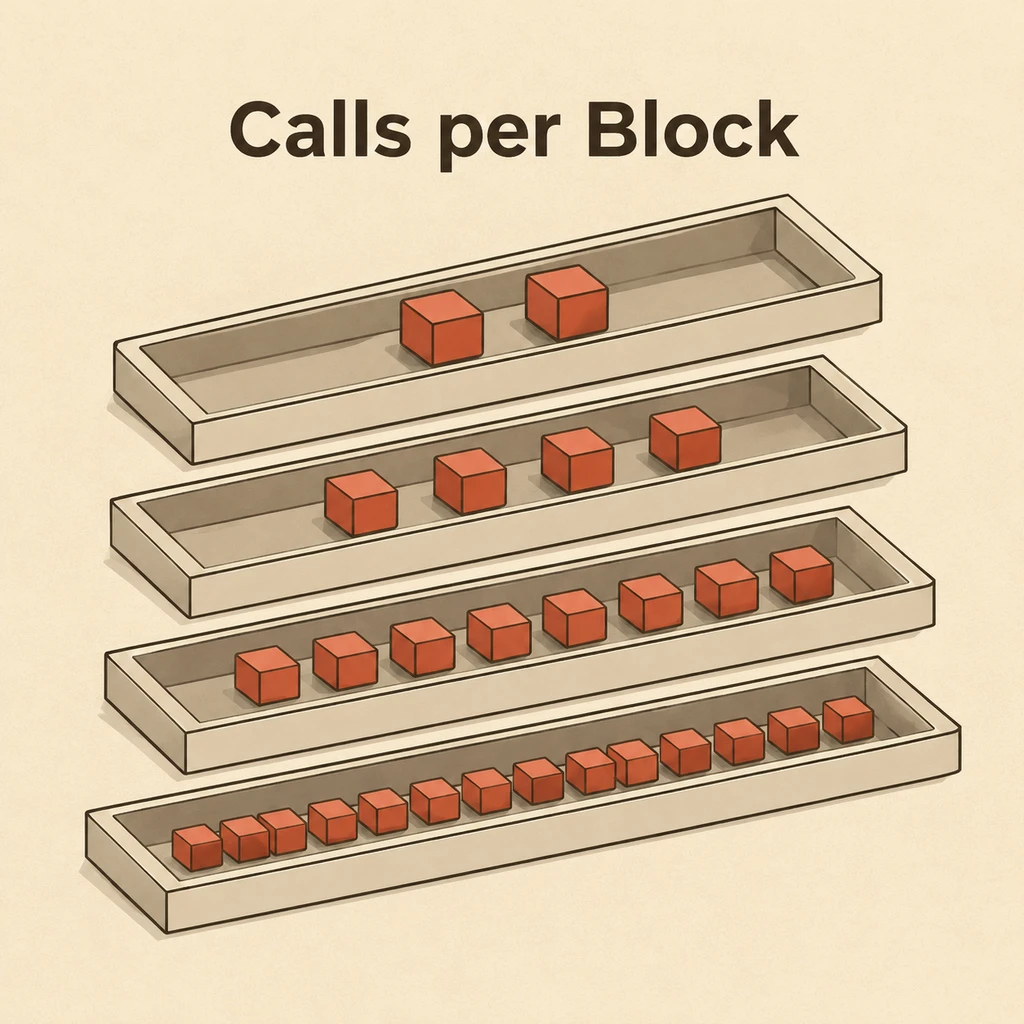
少步变体通过教师模型蒸馏,目标是用更少的去噪调用保住生成质量。官方列出的档位为 NFE 2、4、8、16,NFE 在这里量的是每块去噪调用次数。论文也比较了 DDPM 和 DDIM 两种采样器,在论文的低步数实验里,DDIM 表现更好。这项结果限于论文的实验设置,不能直接换算成线上延迟或吞吐。
逐 token 生成也早已不是每一步都从头计算。自回归服务可以用 KV 缓存复用已经算过的信息,也能用推测解码一次验证多个候选 token。Sigma 要证明块内并行划算,得在输出质量对齐后,拿省下的时间抵消逐块反复去噪的成本。公开材料还没有给出 Sigma 与这些自回归基线或扩散同行的同条件独立对照。
流式聊天和批量任务要分开算账
聊天服务先看首个可见输出。即使整段答复更早生成完,用户也可能因为要等首块去噪结束才看到文字,感觉响应变慢。批量任务更关心并发吞吐,但调用轮数下降能否多处理请求,还取决于批处理方式和显存占用。
推理服务商可以先拿公开权重做小规模复测,不必凭档位就排迁移预算。测试应在相同硬件、任务和批大小下,对齐输出质量与长度口径,让自回归基线开启成熟的推测解码,再分别报告首个可见输出延迟、端到端延迟和并发吞吐。只有拆开这几项,团队才知道该把 Sigma 放进聊天服务试用,还是先留给批量任务。