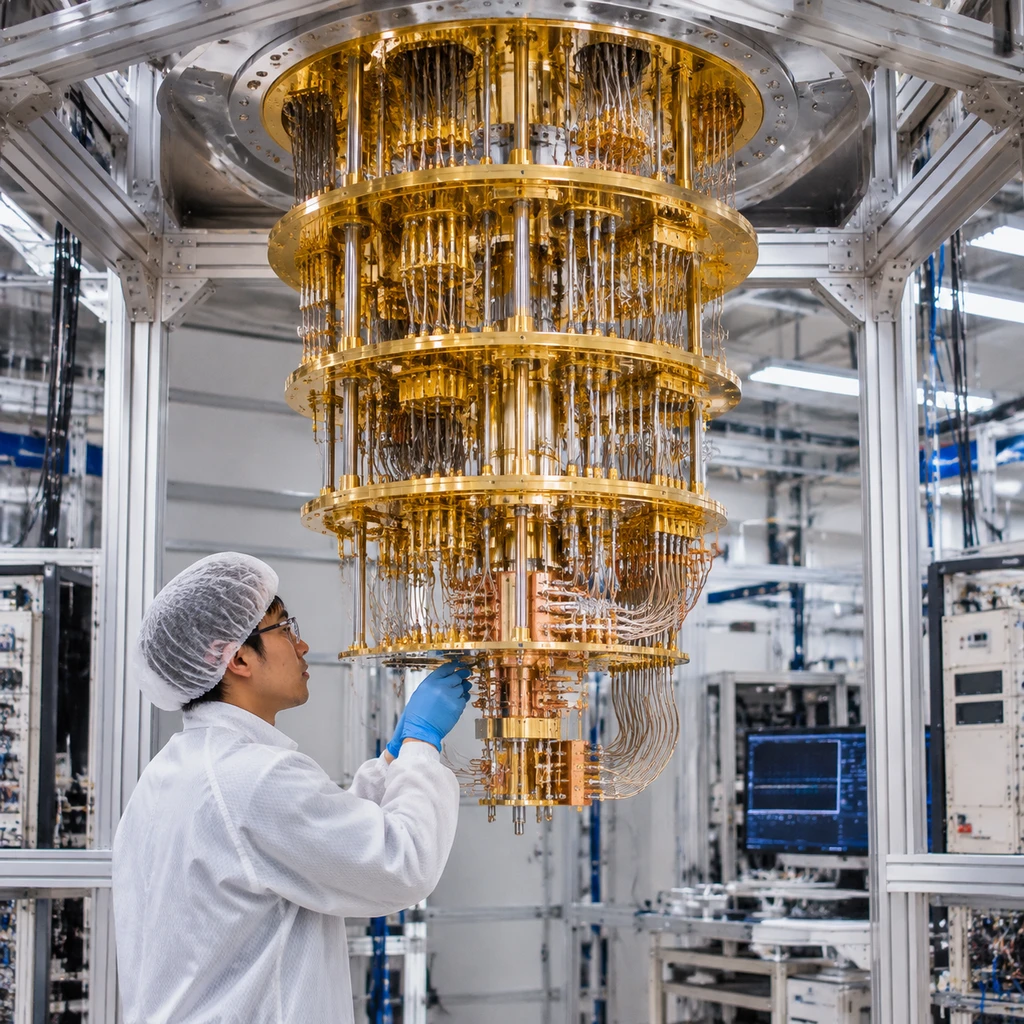
IBM 在 2026 年 11 月 11 日的量子开发者大会(QDC)上改写了 2027 年的硬件交付方案,宣布将通过连接两颗下一代通用量子处理器 Nighthawk r3,向外界提供一套包含 1040个可编程量子比特、可执行 10000 次门操作的双芯片系统。这让 IBM 在账面上保住了 2027 年突破千比特大关的承诺,但实现路径发生了剧变——原计划是将 9 颗各含 120 个量子比特的小芯片串联成 1080 比特系统,如今却把互联芯片数量从 9颗砍到2颗。与竞争对手相比,这套定于 2027 年底前落地的系统提供的全是未经纠错的物理可编程比特,在单芯片门精度上不及 Google 的 Willow,在逻辑比特交付进度上也与直接瞄准 100 个高保真逻辑量子比特的 Quantinuum 存在明显代差。
这种“把单颗芯片做大四倍、把拼接数量砍掉七颗”的做法,绝不只是简单的工程路径优化,而是模块化互联遭遇通信损耗瓶颈后的防御性退守。今年 9 月发布的 Nighthawk r2 仅以单颗 120 可编程量子比特芯片的形态交付(支持超 7500 次门操作),旧路线图里原定在 2026 年落地的 3 芯片互联(360 比特)系统已悄然隐身。为了在少连芯片的前提下凑够千比特规模,IBM 不得不把单颗 Nighthawk r3 的物理规模推向极限,在单芯片上塞入 2034个总物理量子比特,用单晶圆良率和布线密度的代价,换取跨芯片边界从 8 个锐减到 1 个。
99%传态保真度背后的跨芯片门折损
IBM 量子系统副总裁 Oliver Dial 在会上展示了模块化互联的进展,强调团队利用 4 条被称为 l-couplers 的耦合器连接同一制冷机内的两颗 Nighthawk r1 处理器,实现了高达 99.4% 的量子态传输(state transfer)保真度,逼近 99.9% 的长期目标。单看这个数字,跨芯片通信似乎已经水到渠成,但这恰恰是外行最容易被公关口径误导的地方。
翻开 IBM 在 2026 年 10 月 27 日披露的底层实验数据(使用 4 条 80 厘米线缆连接两颗 r1 芯片),跨芯片量子态传输的平均保真度确实达到了 99%(最高 99.3%);然而,真正用于执行量子计算的跨处理器双量子比特纠缠门(CZ 门),其平均保真度直接跌到了 94.75%(最高也仅为 96.42%),而且这项实验仅对连接器周边的局部区域进行了布线和测量。
传态保真度是空车跑高速,跨芯片逻辑门才是满载过险滩。
为什么两个数字差了将近 5 个百分点?因为执行一次跨芯片逻辑门操作,并不是简单地把量子态传过去就完事,它需要累积多次片上本地门操作与跨芯片态传输的误差。每跨越一次芯片边界做一次纠缠计算,就要吞下超过 5% 的错误率。如果按原计划在 2027 年硬把 9 颗芯片串在一起,算法在跨越多个模块边界时,信号很快就会淹没在噪声里。
看懂了这组数据,就能明白 Nighthawk r2 和 r3 为何要在单芯片内部大做文章。在 9 月发布的 Nighthawk r2 中,芯片总共包含 458 个物理量子比特,但只有 120 个是可编程的,其余绝大部分是被称为耗散重置装置(dissipative reset gadgets)的辅助物理比特。每一个可编程比特旁都配了一个物理结构相同但不参与计算的辅助比特,专门用来快速抽走能量、将工作比特重置回基态,从而让特定操作的运行速度最高提升了 19倍。
到了 2027 年的 Nighthawk r3,IBM 延续了这种用硬件冗余换速度的设计:单颗芯片塞进 2034 个物理量子比特,提炼出 520 个可编程比特,并在两颗芯片之间只布置 10 个 l-couplers 耦合器。对于正在租用 IBM 云端算力的企业算法团队和科研人员来说,这反而是一个务实的好消息——明年拿到手的 1040 比特系统只存在一道芯片缝隙,跑起实验算法来,实际噪声表现会比原定的 9 芯片拼盘稳定得多。
2027量子三国杀与2029容错大考的硬骨头
把视野拉回整个行业,IBM 在 2027 年端出的“1040 比特”,与竞争对手口中的量子比特完全不在同一个维度上。由于超导量子芯片纠错开销极大,IBM 走的是双轨路线:一边用 Nighthawk 系列提供高连接度的物理可编程比特供开发者测试算法,另一边在 Loon、Cockatoo 等实验芯片上测试低开销的双变量自行车码(bivariate bicycle code),目标是到 2029 年推出具备实用容错能力的 Starling 系统。
这意味着 2027 年的 Nighthawk r3 双芯系统里,容错逻辑量子比特的数量依然是 0。同一时间窗口下,三家头部厂商的技术验证维度已经彻底分化:
| 厂商与系统 (2027目标) | 核心技术路线 | 关键比特规模指标 | 核心门操作精度 / 错误率 |
|---|---|---|---|
| IBM Nighthawk r3 | 超导模块化双芯互联 | 1040 可编程物理比特 (0 逻辑比特) | 跨芯片 CZ 门平均保真度 94.75% (基于 r1 互联实验) |
| Quantinuum Sol | 离子阱架构 | 最高 100 逻辑量子比特 | 物理双比特门保真度 >99.98%,逻辑错误率 10⁻⁵ |
| Google Willow | 超导片上表面码纠错 | 专注于突破纠错阈值验证 | 片上双比特门保真度 99.67% (CZ) / 99.86% (类iSWAP) |
对比之下,离子阱路线的 Quantinuum 现有 H1 系统物理双比特门精度已达 99.9%,其定于 2027 年下半年推出的 Sol 系统直接跳过物理比特堆砌,瞄准 100 个逻辑量子比特;同为超导路线的 Google 则死磕单芯片质量,其 Willow 芯片已演示了低于阈值的表面码纠错,片上同时双量子比特门平均错误率压到了 0.33%(CZ 门)和 0.14%(类 iSWAP 门)。
IBM 之所以不敢放弃模块化互联,是因为它的 2029 年容错路线图被单芯片物理尺寸死死卡住。按照 IBM 的长期规划,大约需要 300 个硬件量子比特才能编码出一个包含 12 个容错逻辑量子比特的模块;一颗芯片最多只能容纳一到两个这样的模块。要凑齐能够跑出实用价值的 100 个以上逻辑量子比特,无论单芯片怎么扩建,最终都必须把 5 颗甚至更多颗大芯片连起来。
把 2027 年的互联数量从 9 颗缩减到 2 颗,只是帮工程团队把难题往后推了一步。对标 2029 年的 Starling 容错系统,IBM 研发线面前还横着三道必须跨过去的硬指标:
- 风险.Starling 每个模块需要超过 100个长程耦合器且错误率必须压到 0.1%,而目前仅演示了 4 个耦合器、态传输错误率还在 1% 左右徘徊;负责验证纠错架构的 Loon 芯片目前中位门错误率接近 0.3%,距离 Starling 要求的 0.01%低段还有近 30 倍的差距;同时,虽然 Relay-BP 解码算法已经达标,但配套的专用实时解码芯片仍在开发中。
IBM 用两颗 2034 物理比特的巨型芯片守住了 2027 年的路线图体面,但接下来一年半里,外界真正需要盯紧的不再是它发布了多少个可编程物理比特,而是那 10 条 l-couplers 在 Nighthawk r3 上能不能把跨芯片 CZ 门的保真度拉上 99%,以及百通道耦合器的工程验证何时能走出实验室。