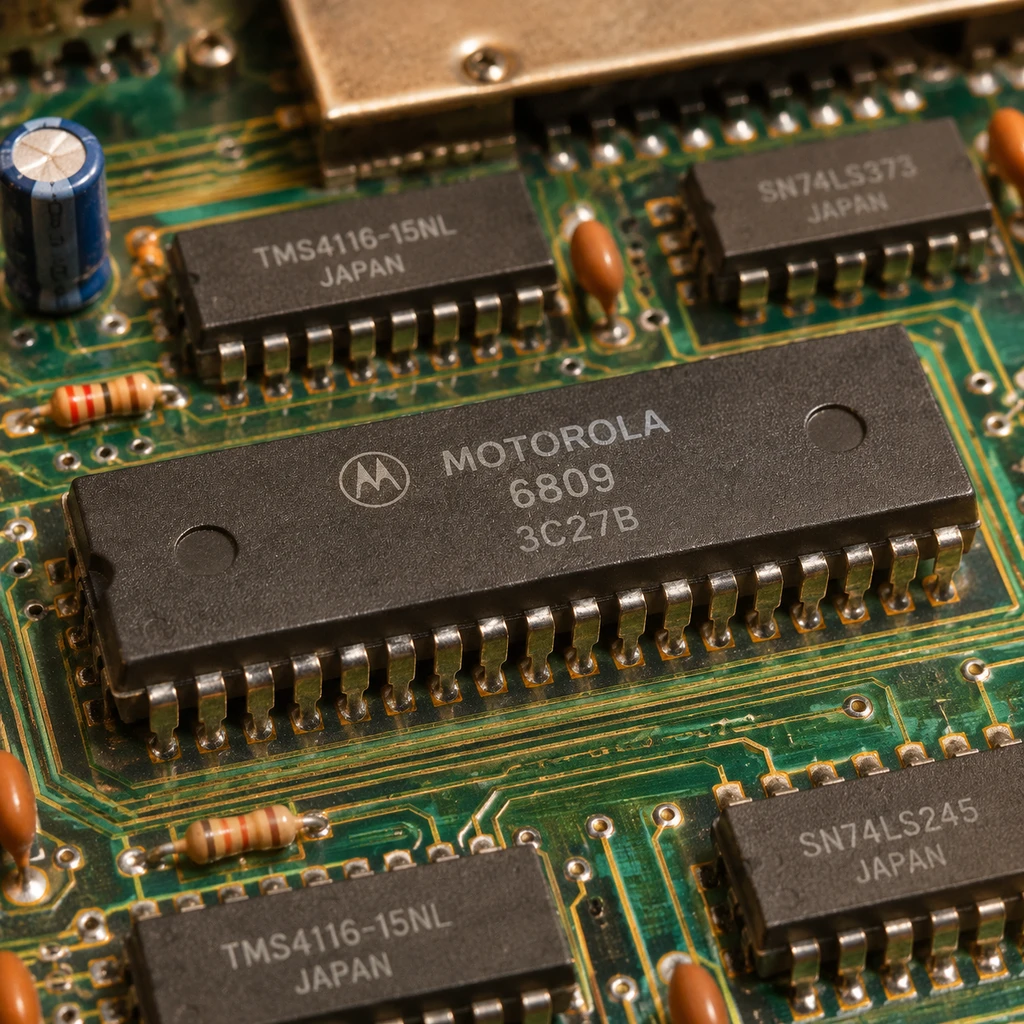
把一个 28×28 像素的背景瓦片画到屏幕上,常规汇编优化到极限要 2893 个 CPU 周期;但如果把处理器里原本用来管理函数调用的两个栈指针直接绑架去搬运像素,这个数字会掉到 1689 个周期。这是程序员 Tom Moertel 回忆 1980 年代在一台搭载 Motorola 6809 处理器的 8 位个人电脑(经 Hacker News 社区考证为 Tandy Color Computer 3,简称 CoCo 3)上拯救一款街机移植横版卷轴游戏的真实账单。单瓦片吞吐量 提升 70%,执行时间砍掉 42%,直接把一款卡成幻灯片的半成品救活,整机帧率拉高了三分之一到二分之一。
今天回看这段陈年旧码,最刺眼的不是他们怎么把循环展开抠到单个时钟周期,而是当这种越界操作引发硬件中断写坏内存时,他们没有按教科书规范去修补漏洞,反而顺着硬件的脾气,把内存破坏直接引流到了屏幕上。
常规指令撞上算力死墙,劫持双栈指针榨出 70% 性能增量
在 8 位机时代制作横版卷轴游戏,每一帧都要根据玩家位移重绘几乎整屏的背景瓦片。按 Moertel 的记忆,当时屏幕缓冲区为 320×240 像素、16 色(每像素占半字节,每行 160 字节;不过复古计算社区考证指出,CoCo 3 的 GIME 图形芯片常规垂直分辨率实为 192、200 或 225 行,且具备硬件滚屏寄存器,240 行与纯软渲染的说法带有多年后的记忆偏差)。每个瓦片为 28×28 像素,即 28 行、每行 14 字节。
如果老老实实用 6809 的 16 位索引寄存器自增寻址(LDU ,X++ 配合 STU ,Y++),每次搬 2 字节(4 像素),7 次循环画完一行,需要 157 个周期。Moertel 的同学在求助前,已经把代码抠到了常规手段的极限:彻底展开内部循环,省掉计数与跳转开销;甚至嫌弃 ++ 自增操作每次多耗 3 个周期,全部改写成了成本仅 1 周期的固定偏移量寻址(如 LDU 2,X)。
即便如此,画完一行 14 字节依然要 98 个周期,画满 28 行一个瓦片总计 2893 个周期。满屏瓦片算下来,CPU 连气都喘不过来。
破局点藏在大学工程图书馆那本破旧的《MC6809-MC6809E 微处理器编程手册》里。Moertel 翻到了 PSHS 和 PULS(压栈与出栈指令)。在苹果 Apple II 的 6502 处理器上,寄存器压栈必须借道累加器一个个来,慢得像蜗牛;但在 Motorola 6809 上,单条指令就能把所有寄存器一次性压入或弹出栈,固定开销仅 5 个周期,之后每多传 1 个字节只加 1 个周期。
更妙的是,6809 恰好有两个栈指针:系统栈 S 和用户栈 U。
Moertel 决定干一票大的,也就是复古游戏界俗称的栈爆破(Stack Blasting)。他把 S 指向瓦片源数据,把 U 指向屏幕缓冲区,再把芯片上剩下的三个 16 位通用寄存器 D、X、Y,外加一个专门用来指定零页地址的 8 位直接页寄存器 DP,全部征用为临时搬运工。
三个 16 位寄存器加一个 8 位寄存器,刚好凑齐 7 个字节。一行 14 字节的瓦片,只需要两轮出栈与压栈就能搬完:
PULS D,X,Y,DP.从源地址一次性拉出 7 字节,耗时 5 + 7 = 12 周期。PSHU D,X,Y,DP.向显存一次性砸入 7 字节,同样耗时 12 周期。- 连续执行两轮,48 个周期搬完 14 字节,折合 3.43 周期/字节。
- 加上行末用
LEAU -WOFF,U调整目标指针跨行的 8 个周期,单行耗时被死死按在了 56 个周期。
整台机器上所有能喘气的寄存器全被绑上了流水线。但代价立刻浮出水面:栈的压入(Push)和弹出(Pull)在内存里是反向移动的。PULS 让源指针向高地址走,而 PSHU 让目标指针向低地址退。如果按正常顺序存美术资源,画出来的瓦片会左右颠倒、上下倒置。
为了迁就这两条指令的怪癖,他们必须在游戏运行前,离线把所有瓦片的内存拓扑全部拧成麻花:每行右半边的 7 字节放在左半边 7 字节前面,且按从下往上的顺序重排。用离线的空间扭曲,换取运行时的极限吞吐。
教科书教你关中断保平安,真玩家选择把脏数据留给下一帧
如果故事只停留在重排美术资产、榨干寄存器,那还只算是一道漂亮的数字体操。真正让人拍案叫绝的,是他们处理硬件中断(IRQ)污染的野路子。
按照 Motorola 官方手册的铁律,系统栈指针 S 是硬件中断的命根子。一旦定时触发的声音中断到来,6809 会自动把当前程序计数器、寄存器状态一股脑压入 S 指向的内存。而此时,S 正指着游戏背景瓦片的源数据(或者显存)。
只要背景音乐一响,中断就会毫不留情地往 S 指向的地方写入一串状态字节。如果 S 指着瓦片图库,美术资产就会被永久篡改;如果为了保数据安全而在画图时屏蔽中断(关 IRQ),游戏里的声音就会变得支离破碎、卡顿刺耳。
在“画面不花”和“声音不卡”之间,常规工程思维看到的是一道二选一的死命题。
真正的工程狠人,不消灭代价,只重写代价落地的次序。
Moertel 和同学干了一件完全违背祖训的事:既不关中断,也不去保护栈指针,而是故意把战火引向屏幕。
他们把两个栈指针的角色做了对调——用用户栈 U 去读取不可再生的瓦片源数据,而把随时会引爆中断炸弹的系统栈 S 指向屏幕显存缓冲区。这样一来,当声音中断在画图途中突然杀出时,CPU 压栈保存现场的那几个字节,只会像涂鸦一样喷溅在当前正在绘制的瓦片显存上方(即内存低地址方向,对应屏幕上的偏左或偏上区域)。
接下来自愈的魔法只靠一步:重新编排整屏瓦片的绘制先后顺序。
既然中断留下的脏数据总是沿着栈增长方向、落在当前瓦片紧挨着的尚未绘制区域,那只要让渲染引擎严格顺着同一个方向依次铺设瓦片,前脚中断刚在隔壁地盘吐了一口脏数据,后脚紧跟上来的下一块瓦片就会用正确的像素把它彻底盖住。
《孙子兵法》讲“水因地而制流”,放在这台内存按字节抠、算力按周期算的 8 位机里,就是不跟硬件中断硬顶,顺着栈指针倒退的方向排布渲染流水线。那几个字节的垃圾数据确实在显存里存在过几微秒,但在电子束扫过屏幕、被人眼捕捉到之前,就已经灰飞烟灭。
- 结论.最顶级的底层优化从来不是在抽象层里修修补补,而是看穿数据流向与时间窗口,用空间拓扑重排换取时间,用后续流水线的确定性覆盖去消解瞬态的硬件冲突。
我更在意的是这种思维方式在今天的回响。现代程序员习惯了在动辄几十 GB 内存、无数层安全抽象的温床里写代码,遇到并发冲突就加锁,遇到硬件限制就等下一代芯片,代码越写越厚,跑起来却越来越慢。当算力从云端走向边缘侧微控制器、走向受限的端侧推理与高频交易系统时,硬件边界依然冷酷。
当年那群在 6809 上为了省出 1204 个时钟周期,敢把系统栈当搬运工、敢让显存自己咽下中断垃圾的大学生,其实早就把底层工程的底牌亮出来了:所有看似不可逾越的硬件死局,往往只是因为你还没舍得撕掉说明书上的安全免责条款。