2026年7月25日,安全团队Hacktron在OpenAI内部单体仓库openai/openai中提交了一条编号为PR #1186742的合并请求。发起提交的账号并非黑客自己的马甲,而是一位如假包换的OpenAI内部员工。
从攻击者向OpenAI社区论坛上传一张特制的HEIC格式图片,到长驱直入控制员工账户并向核心代码仓写入代码,全程耗时不到72小时。这场渗透在安全圈引发震动,但外界最先产生的恐慌多半落错了地方:它不是什么大语言模型算法被逆向,也不是权重失窃,而是一起典型的老旧开源依赖塌陷,撞上了过度放权的AI生产力连接器。
致命跳板:一张图片撕开的社区缺口
所有突破的起点,只是一处常年被视作边缘资产的社区论坛(community.openai.com)。该论坛基于开源项目Discourse搭建,在处理用户上传的HEIC格式图片时,由于常用组件FastImage无法直接解析,程序将图片抛给了ImageMagick处理,进而调用了底层的libheif解码库。
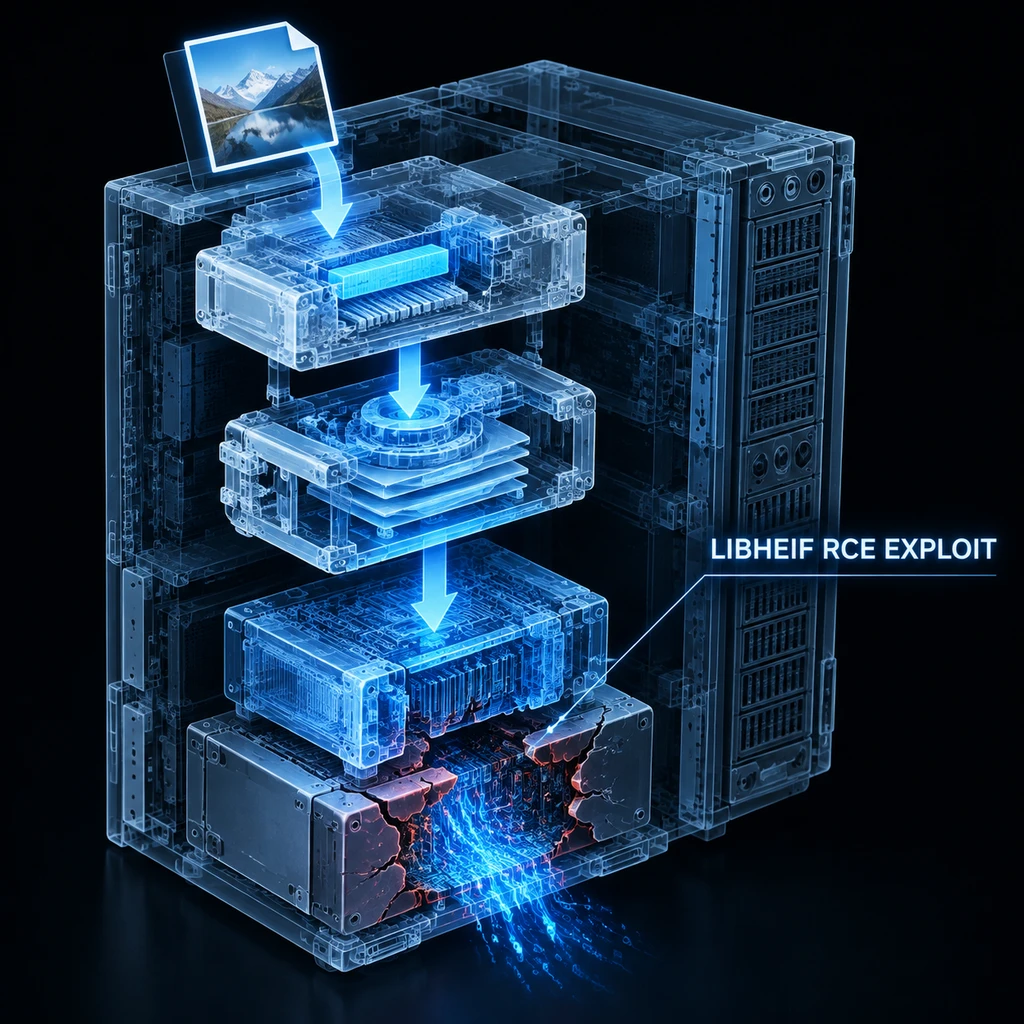
这正是开源供应链最脆弱的环节:上游此前修复过一处堆缓冲区溢出缺陷,却未打上CVE安全标签,导致Debian 12与Debian 13系统长期没有回移植该补丁。Discourse基于Debian 12构建的容器镜像直接继承了版本为1.19.7的有毒库。攻击者利用未回移植的漏洞,在目标服务器上实现了无交互的远程代码执行。
Discourse官方随后在2026年7月28日发布了高危安全通告CVE-2026-32882(GHSA-vhm9-85gw-x335),CVSS评分高达8.8,并在补丁中火速引入了基于Landlock的图像处理沙盒机制。Debian也在8月8日补发了Debian 13的安全更新。
在开发针对启用了内存地址随机化(ASLR)环境的攻击载荷时,安全团队调用了Anthropic的Claude Opus 4.8辅助分析,随后在Claude Opus 5发布的当晚,借由新模型的代码编写能力,在数小时内完成了跨架构适配与本地验证。这一插曲很快被包装成了AI攻防换代的绝佳公关素材。
穿透生产网:当SSO遇上放权的Codex
拿下论坛服务器只是拿到了外围立足点。真正让整个技术界倒吸一口凉气的,是攻击链的后半截。
OpenAI允许用户通过统一身份认证(auth.openai.com)登录社区论坛。正是在这套SSO流程的配置缺陷下,拿下论坛控制权的攻击者得以置换身份凭据,接管了登录过该论坛的OpenAI员工的ChatGPT与Codex生产账户。
零信任的安全防线,往往被贪图省事的跨域单点登录击穿。
一旦进入员工的Codex账户,企业重金构筑的内网隔离屏障便化为泡影。这名员工的Codex绑定了GitHub连接器,且具备向OpenAI内部代码仓的写入权限。攻击者甚至不需要窃取该员工的本地SSH私钥,只需向Codex发送一条提示词指令,AI助手便顺从地在内部单体仓库openai/openai中创建了PR #1186742。
- 风险.生产力工具连接器若默认开启代码直写权限,就相当于在隔离网内外架设了一条不受二次校验约束的双向特权通道。
OpenAI在接到漏洞报告后动作迅速,约14小时内便堵住了身份端的认证漏洞,并在2026年9月1日向挖掘团队发放了6,500美元赏金。但OpenAI同时强调,这笔款项仅针对SSO漏洞,因为Discourse搭建的社区论坛根本不在其公开赏金范围之内。
剥开惊悚叙事:单方陈述与越界悬崖
面对铺天盖地的黑客入侵头条,有必要把事实与公关叙事拆开来看。
首先是证据链的严重失衡。Discourse的CVE公告与补丁记录是铁证,足以证实边缘RCE的存在。但最致命的一环——究竟是怎样的SSO设计缺陷能让攻击者直接换取核心生产凭据、被控制的员工处于什么权限层级、内部PR #1186742的实际影响范围——至今全部来自安全团队Hacktron的单方博客陈述。截至9月中旬,OpenAI从未发布过独立的调查报告或证实该PR的存在。
更耐人寻味的是测试行为的边界。在明知社区论坛不受赏金计划保护的情况下,测试团队在未获预先授权的前提下接管真实员工账号,并向生产环境的内部代码仓库执行写操作。这已经踩在了负责任披露伦理的危险边缘。
宣传中宣称的攻破代码库,与现实中的工程破坏力存在巨大落差。创建一条PR并不等于拥有合并权,更不代表接管了基础设施或盗取了未发布的模型权重。这更像是一次精准利用特权连接器盲区的越界验证,顺便为后续覆盖Slack、Meta等系统的HEIF Heist商业安全项目赚足了眼球。
至于Claude Opus 5在其中的角色,与其说是AI自主发动了网络战,不如说是资深安全专家把繁琐的漏洞适配劳动外包给了更高效的算力。方向依然由人把控,模型只是缩短了从理论到武器化的工时。
- 结论.真正的系统性隐患不在于大模型本身是否安全,而在于企业在给各类智能体挂载生产力连接器时,盲目让渡了本该严格受控的写操作权限。