租用同一块英伟达 H100 SXM 80GB 芯片,在 RunPod Community 上按需付费只需 2.69 美元/小时,而在微软 Azure 上却高达 12.29 美元/小时。GitHub 开源项目 datareceipts/data-receipts(编号 109-gpu-pricing)于 2026 年 11 月 9 日抓取了北美主力数据中心(AWS us-east-1 与 Azure eastus)的公开账单,算出最贵与最便宜渠道之间存在 4.57 倍价差。按连续运行一个月(730 小时)计算,单卡账单会在 1,964 美元到 8,972 美元之间剧烈摇摆。
这份账单揭开了云算力市场的定价温差,但把所有机器除以显卡数量算出的每小时单价,在真实的采购谈判桌上其实是个统计幻觉。4.57 倍价差反映的并非哪家云厂商更暴利,而是算力租赁已经彻底裂变为零售单卡与批发集群两个物种。一旦算上 8 卡整机起租门槛、跨节点高速互联网络溢价以及物理库存锁定成本,廉价的 H100 从来不对大规模分布式训练敞开大门。
除以 8 制造的单卡比价幻觉与规格陷阱
开源项目的作者为了避免跨规格比价,特意指出市面上的 H100 实际上是三种不同硬件:显存带宽高达 3.35TB/s 的 SXM 80GB、标称带宽 2TB/s 的初代 PCIe 80GB,以及显存扩容到 94GB 的 NVL。但核查该项目底层的 compute.py 脚本与云厂商文档可以发现,这种严谨依然漏掉了算力采购中最关键的最小计费单元。
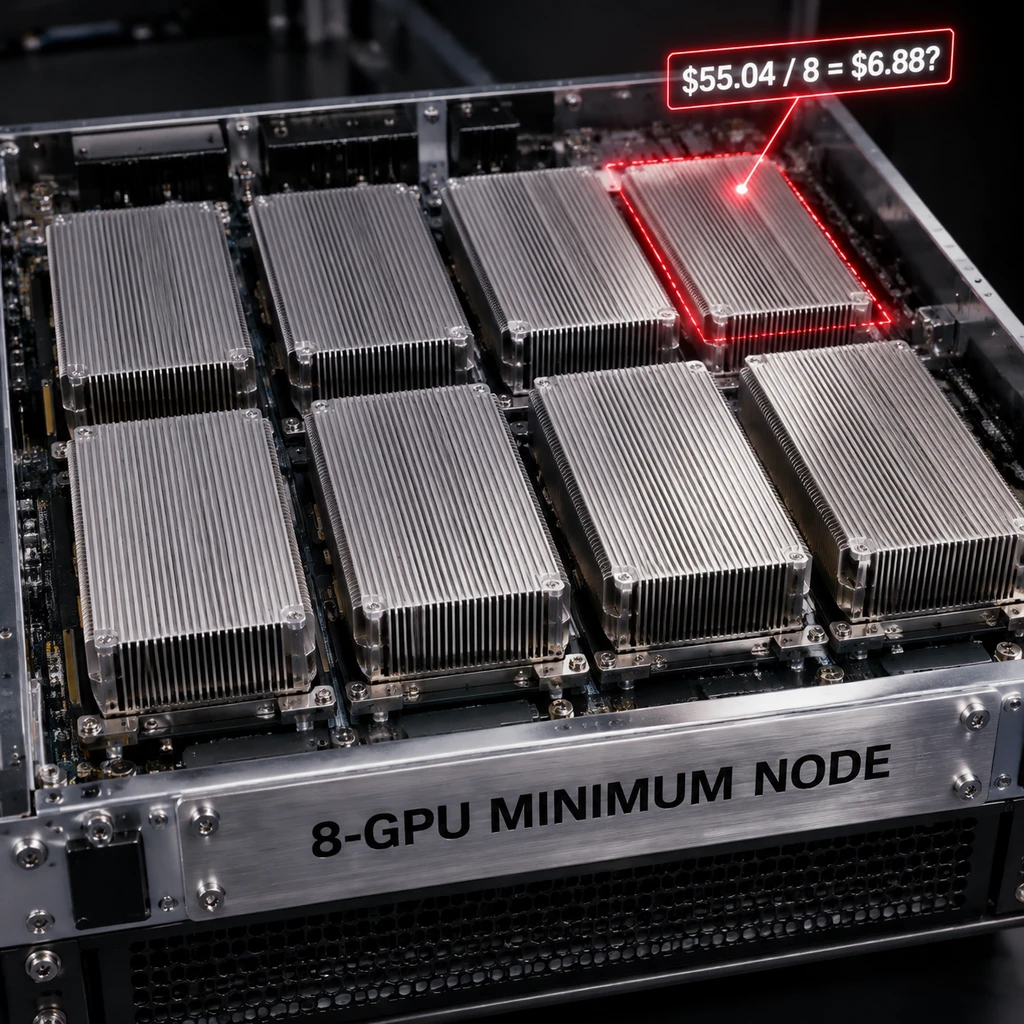
AWS p5.48xlarge 的 6.88 美元单价,是用整机按需价 55.04 美元/小时除以 8 得出的;Azure Standard_ND96isr_H100_v5 的 12.29 美元,同样来自 98.32 美元/小时的 8 卡整机账单。就连新兴算力云阵营里的 CoreWeave,其北美区 HGX H100 节点按需价 49.24 美元/小时(折合 6.16 美元/卡时)也要求按 8 卡节点起算。更隐蔽的偏差出在代码里:compute.py 在做归一化时将所有新兴算力云记录的实例卡数强制赋值为 1,导致 vendors.json 中原本标注为 8 卡整机起租的 Lambda 实例(4.59 美元/卡时),在统计表里丢失了必须整机打包租用的门槛限制。
独立开发者或小团队做单卡微调时,在 RunPod 上确实能掏出 2.69 美元只租 1 张 H100 SXM(若是 PCIe 80GB 版本,RunPod Community 和 Secure 甚至低至 1.99 美元和 2.89 美元/小时)。但你不可能拿着 6.88 美元去向 AWS 只买八分之一个 P5 节点。
即便在同一家大厂内部,单卡与整机也是完全割裂的两套硬件。原作者在解释 Azure 为什么贵时,拿 12.29 美元的 ND 系列与 Azure 自家 6.98 美元的单卡实例 NC40ads_H100_v5 做对比,认为差价主要来自 ND 系列每张卡配备的 400 Gbps Quantum-2 InfiniBand 网络。但核对硬件参数就会发现,Azure 那台 6.98 美元的单卡机器搭载的根本不是 SXM 80GB,而是 1 张 94GB 显存的 H100 NVL,且仅配备 40 Gbps 基础网络——原作者在不经意间违反了自己立下的同组对比原则。无独有偶,AWS 的 8 卡 p5.48xlarge 提供了最高 3,200 Gbps 的 EFA 网络并支持 GPUDirect RDMA,而单卡版 p5.4xlarge 则直接砍掉了 GPUDirect RDMA 支持。
为什么越批发的集群反而比单机更贵
普通商品采购遵循量大从优的批发逻辑,但大模型多节点训练的算力定价正好相反:卡数越多、租期越明确,单卡小时价反而越贵。
零售卖的是闲置硅片,批发卖的是毫秒不差的跨机柜通信网。
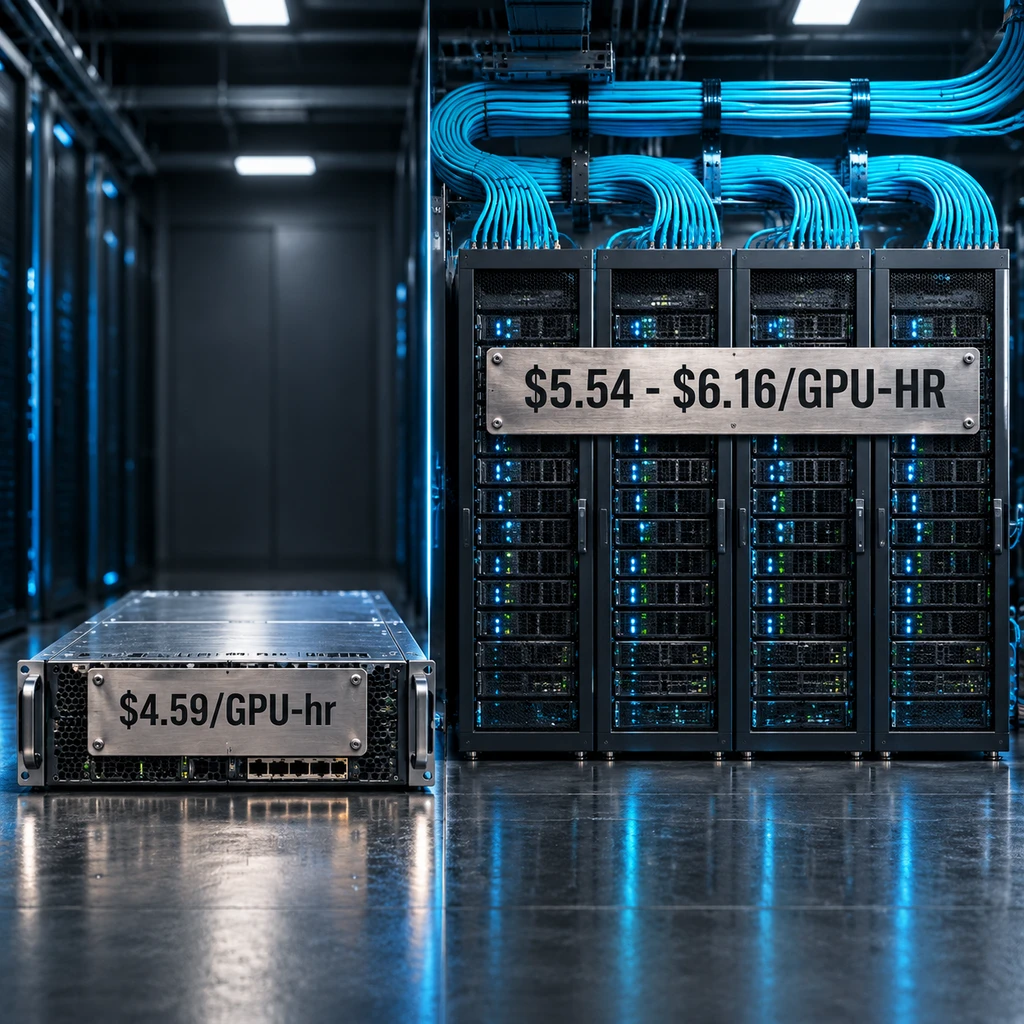
最直观的证据来自被该项目排除在主表之外的 Lambda(因其公开页面标注价格于 2026 年 11 月 16 日生效,实时价格需登录)。在 Lambda 的价目表上,单买一台 8 卡 H100 SXM 实例的按需价是 4.59 美元/卡时(单卡实例为 4.89 美元,PCIe 版为 3.79 美元)。但如果你要预订周期为 2 周至 1 年的 1-Click Cluster 高速互联集群,价格不降反升:16 卡集群涨到 6.16 美元/卡时,64 卡为 5.85 美元/卡时,256 卡也要 5.54 美元/卡时。
| 采购模式与厂商档位 | 折算单卡小时价 | 最小起租规模与核心网络/交付条件 |
|---|---|---|
| Lambda 单机实例(按需) | $4.59 / GPU-hr | 8 卡整机起租,无跨节点高速 RDMA 承诺 |
| Lambda 1-Click 集群(预订) | $5.54 - $6.16 / GPU-hr | 16 至 256 卡集群,包跨节点高速互联与成建制交付 |
| AWS P5 Capacity Blocks | $5.97 / GPU-hr | 8 卡节点起($47.757/节点时),锁物理库存,供需浮动 |
| CoreWeave HGX 节点 | $6.16 / GPU-hr | 8 卡节点起($49.24/节点时),Spot 竞价可降至 $2.46 |
这种价格倒挂直接推翻了原作者在局限性说明里的一个假设。原作者认为如果算上预留实例(Reserved)和承诺使用折扣,大厂与新兴算力云的价差会大幅缩小;事实上,收敛价差的不是大厂打折,而是新兴算力云一旦进入多节点集群领域,就必须把高昂的 InfiniBand 交换机、光模块和机柜成建制交付成本加进账单。在标出 2.69 美元低价的 RunPod 上,如果你要租用 H100 集群(Clusters),公开标价直接失效,必须转入线下的销售询价(contact-sales)模式。
当训练规模跨过单机 8 卡的边界、进入 16 卡乃至 64 节点的分布式训练时,Lambda 与 CoreWeave 的集群单价(5.54 至 6.16 美元)已经与 AWS P5 的容量块(Capacity Blocks,实时价格 47.757 美元/节点小时,折合 5.97 美元/卡时)处在同一水位线上。那条看似诱人的 2.69 美元低价线,在跨节点训练场景下根本不存在。
账单折扣不保库存,暗账藏在关机之后
对于手握算力预算的技术负责人来说,看懂目录价只是第一步,真正的财务损耗往往发生在合同细则与外围账单里。
在 AWS 和 Azure 的采购体系里,拿到账单折扣和开机拿到显卡是两套完全独立的机制。企业常规购买的 AWS Savings Plans 或 Azure Reserved VM Instances(预留实例),本质上只是财务层面的计费折扣券,并不提供物理机房的库存保障;遇到算力紧缺周期,拿着预留折扣券依然会面临开不出 H100 实例的窘境。真正在物理层面锁死库存的机制(如 AWS Capacity Blocks),不仅需要单独预订,而且 AWS 官方文档明确警告其价格随供需动态浮动,紧俏时甚至可能高于按需目录价。
同样被营销口径模糊的还有服务可用性承诺(SLA)。云厂商宣传页上常见的 99.99% 可用性,在 AWS EC2 条款中要求用户必须跨可用区(Multi-AZ)部署;而大语言模型训练为了压低通信延迟,往往把所有节点集中锁死在同一个可用区的同一组交换机下,此时 AWS 单实例 SLA 实际只有 99.5%,Azure 单虚拟机配合高级存储的合格配置 SLA 也仅为 99.9%。而在新兴算力云一侧,RunPod 官网虽然宣传 99.9% 可用性,但兑现 99.99% SLA 必须签署定制企业协议;同时 RunPod 已经弃用了 Savings Plans,并停止接纳新的 Community 第三方主机接入,将重心转向可控性更高的 Secure 机房与企业询价集群。
如果团队为了省钱转向单卡平台或竞价实例(Spot),还必须算清两笔暗账:
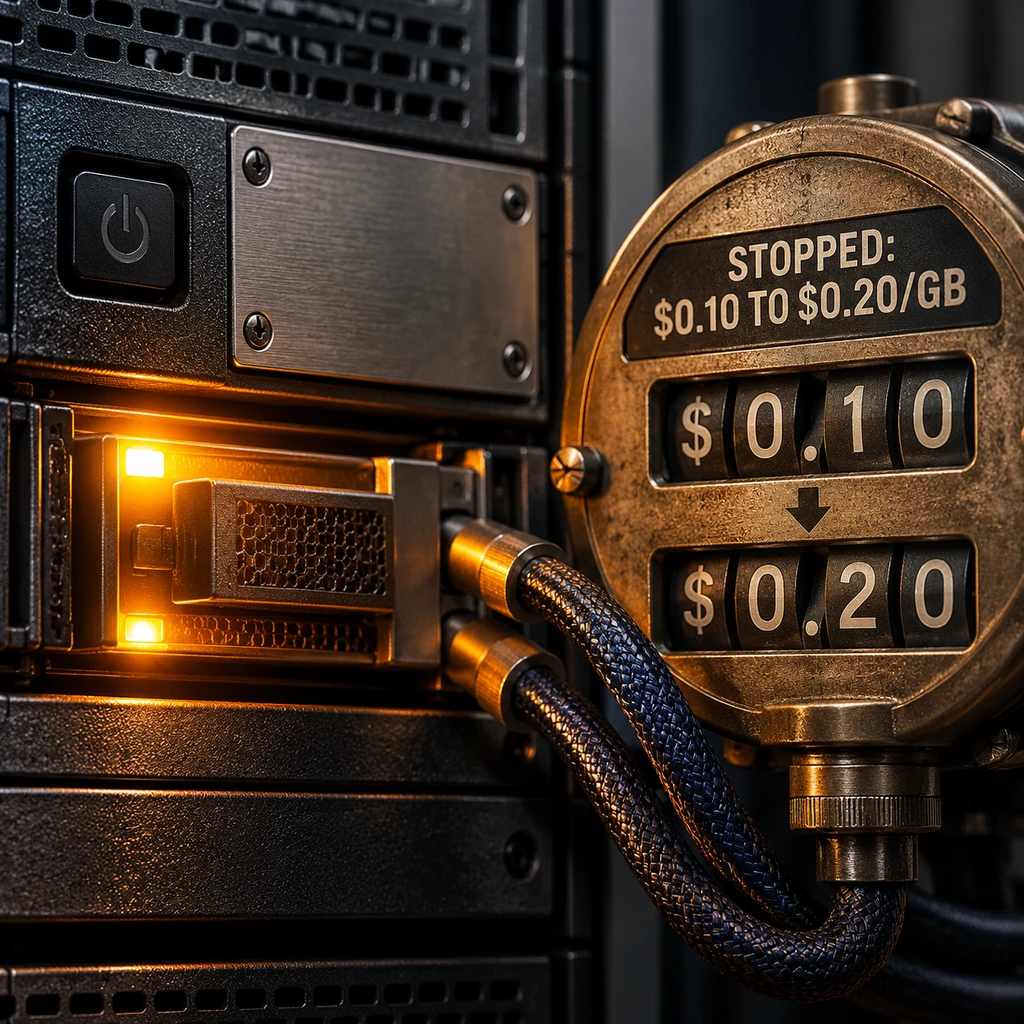
- 风险.RunPod 的 Volume 持久化磁盘在实例运行时收费 0.10 美元/GB-月,但当工程师为了省显卡费而将实例停止(stopped)时,存储费会直接翻倍至 0.20 美元/GB-月——这意味着在关机状态下保留一个存满模型权重与数据集的 500GB 磁盘,每个月光占坑费就要花掉约 100 美元。
- 建议.评估 CoreWeave 等平台低至 2.46 美元/卡时(19.71 美元/节点小时)的 H100 Spot 实例时,必须按有效算力小时重算成本——如果因为竞价实例被随时回收中断,导致只有 75% 的运行时间成功写入了训练检查点(Checkpoint),那么这笔廉价算力的真实有效成本会立刻跳升至 3.28 美元/卡时以上。
随着 2026 年 11 月 16 日 Lambda 新价格体系正式越过生效节点,以及 RunPod 冻结社区个人主机扩充,靠拆卖零散显卡打价格战的草莽阶段正在收尾。算力采购的决策标尺早已不再是表格里那个除以 8 的单卡小时价,而是谁能在锁死百卡物理库存的同时,让昂贵的 RDMA 网络跑满每一个时钟周期。