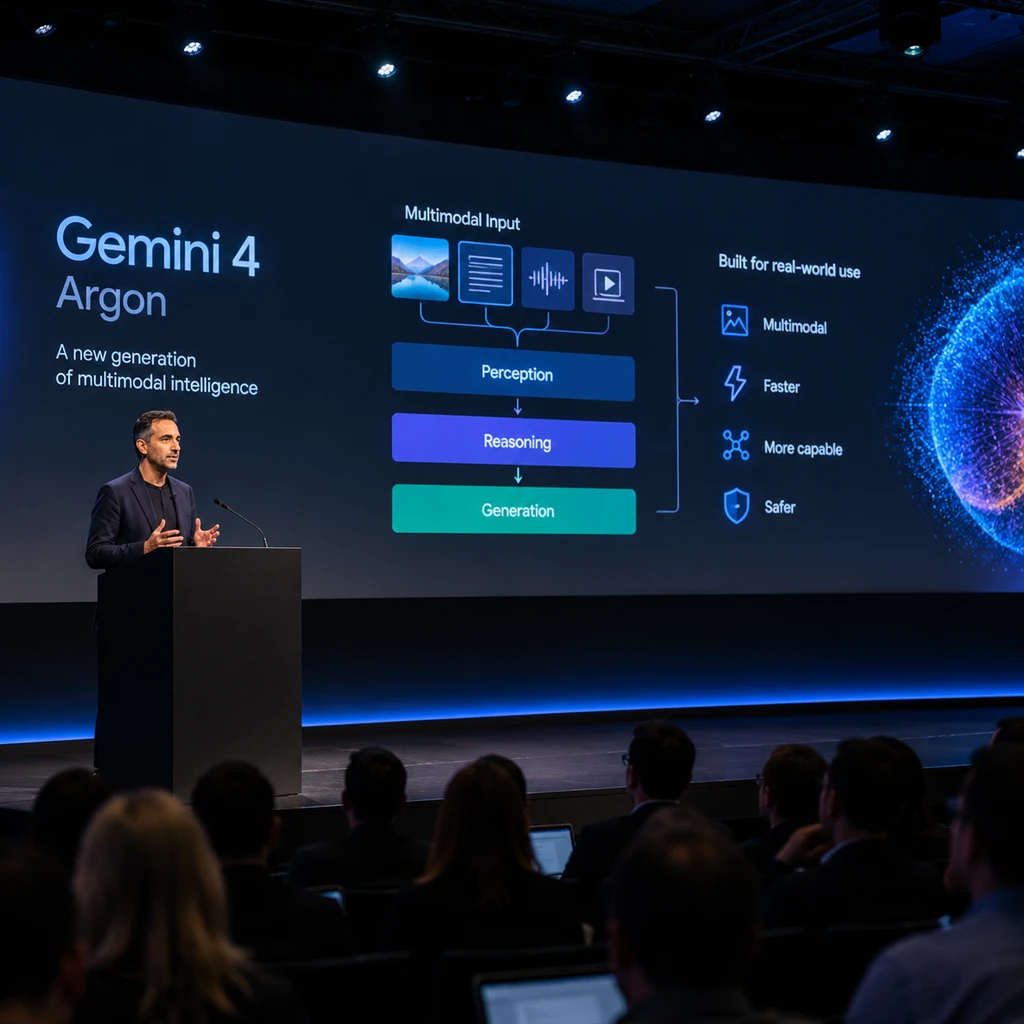
Google 在 2026 年 9 月 30 日正式公布新一代前沿大模型 Gemini 4(代号 Argon),但普通开发者与公众无法立即调用。Google DeepMind 首席 AI 架构师兼高级副总裁 Koray Kavukcuoglu 给出理由:Argon 在软件工程、金融法律知识工作以及网络安全防御上展现出极高能力,首发阶段必须限制在受信任的网络防御者范围内。
把尖端能力锁在门内,表面上是出于安全伦理的自我克制,实质上更像前沿大模型进入深水区后的常态防御。面对日趋收紧的跨国监管与潜在法律责任,巨头不再追求全量无差别公测,而是通过资格审查建立起一套受控的商业准入体系。
审查屏障遮蔽的自测战绩
按照官方通告,Gemini 4 Argon 首批调用权限受限于 2026 年 9 月 2 日启动的 Fairwind Program。该计划目前只向政府部门、Google Cloud 企业客户以及经过签署认证的安全机构开放,普通用户甚至没有测试排队通道。后续的分发也将严格卡在企业级付费 API 与 Google AI Ultra 订阅者之间,通用公测至今没有时间表。
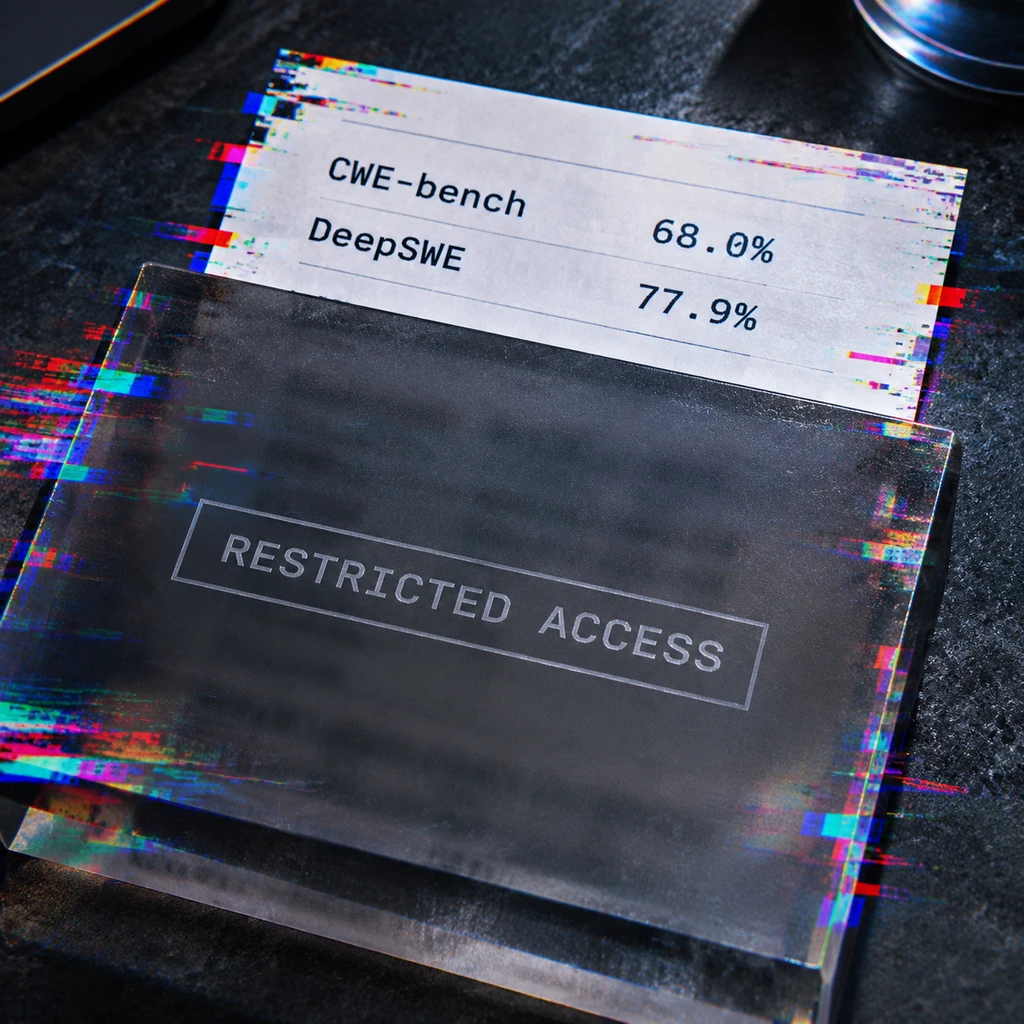
在 Google 给出的评测报告中,Argon 的表现确实亮眼。核心指标 CWE-bench v1 基准测试中,Argon 跑出了 68.0% 的成绩,一举追平竞争对手未公开发布的 GPT-6 Astra,超越 Claude Opus 5.5 的 67.0% 与 Claude Fable 5.1 的 58.0%。此外,官方自测的 DeepSWE v1.1 达到 77.9%,Vibe Code Bench 达 91.9%,AutomationBench 达 51.3%,Terminal-Bench 4.0 达 57.4%,长文本 GraphWalks(≤128k 上下文)更录得 99.7%。
但外界很难直接把这些百分比等同于实战领先。基准测试平台 BenchLM 已将 Argon 的 CWE-bench 数据标记为 display only,明确注明该指标未完成官方独立复现。第三方安全评估机构 Vals 的综合测试集 CyberBench 上,Argon 的得分虽然录得 77.9%,但这套测试与 CWE-bench 并不通用。即使在 Google 自己的多维表格中,Argon 在 FrontierSWE v2 与 Terminal-Bench 4.0 等长程智能体与科学推理场景下,依然落后于 GPT-6 Astra。
评测榜单上的高分并不能直接兑现为真实防御能力。
- 风险.未经第三方独立复验的闭门跑分,容易演变为厂商掌握唯一解释权的品牌背书。
攻防同构下的实战鸿沟
Google 将 Argon 描述为能够在沙盒环境中自主定位漏洞、验证可利用性并实施补丁修复的端到端系统,甚至配备了针对间接提示词注入的防御机制与动态推理监控。然而底层逻辑始终绕不开攻防同构的技术事实:系统识别弱点并构建修复代码的过程,在逆向维度上就是构造武器化漏洞利用(Exploit)的过程。技术本身不具备天然的防御属性。
实验室内的修补代码与实际生产中的防御响应存在巨大鸿沟。学术界此前对前沿模型在真实威胁狩猎场景下的基准研究表明,即便是业界顶尖的 Claude Opus 4.6,在面对非监督 Windows 真实事件日志分析时,恶意事件平均检出率仅有 3.8%。多数威胁行为淹没在企业系统的海量噪音中,全行业大模型距离脱离人工干预独立防御高级持续性威胁(APT)仍有极大距离。
代码重构与打补丁的成功率,不能等同于系统级对抗的免疫力。自动化发现漏洞并不代表能够应对高度定制化的内存破坏或横向移动攻击。
闭门分发与商业壁垒
限制公开发布不仅是应对美国政府自愿性预发布审查的安全策略,也契合了头部公司的商业竞争节奏。OpenAI 刚在 DevDay 推出 Dots 智能体与 GPT-6.1 Sol,旋即因安全评估搁置了 GPT-6.1 Astra;同时在其 API 中设立了普通版、Trusted Access 与专供网安的 GPT-5.5-Cyber 三级准入体系。Anthropic 则将公开发布但严控输出的 Claude Fable 与仅限特许机构且默认留存 30 天日志的 Claude Mythos 5.1 区别对待。
这种做法正在重塑整个安全软件生态。通过设立受信任准入名单,头部公司将独立白帽黑客与中小型安全审计团队挡在核心资产外,自身则掌控了向政企大客户定向派发前沿工具的定价权与裁判权。缺乏外部第三方的充分红队对抗,模型的真实弱点与越狱路径很难被彻底暴露。
- 建议.企业安全主管与采购方不应过早为宣称的自动化防御跑分支付溢价,模型在复杂日志与沙盒隔离中的实际防御能力仍需等待脱离厂商受控环境的独立实测。