一颗商业化芯片都没发,估值先冲到了 70 亿美元。2026 年 11 月 11 日,英国 AI 芯片初创公司 Fractile 宣布拿下一笔 7.2 亿美元的 C 轮融资。领投名单里站着 Thrive Capital、Founders Fund、Lightspeed Venture Partners 和 Redpoint 四家硅谷顶级风投,Alphabet 旗下的 CapitalG、BlackRock 以及英国主权 AI 基金、英国商业银行悉数跟投。
这笔巨款买的是一张 2027 年才兑现的期货。CEO Walter Goodwin 给出的时间表是明年交付首批芯片与系统,目前市面上没有任何公开的独立第三方基准测试能验证其实力。资本愿意在零交付阶段给出 50 亿英镑(约 70 亿美元)的身价,赌的是它能用“逻辑层直接堆叠 DRAM”的硬件架构,外加自研机器学习编译器,解开大模型长链条推理的算力死结。
被长上下文逼出来的架构大转向
很多报道把 Fractile 描绘成天生的破局者,但翻开技术底牌,它能讲出今天的故事,源于一次痛苦的半路折返。
Fractile 成立于 2022 年夏天,最初押注的是片上 SRAM 路线。这条路子的逻辑很直接:SRAM 带宽极高,只要把模型塞进芯片内部,推理速度就能起飞。但 2023 年底到 2024 年间,大模型迅速从单次问答转向智能体(Agentic AI)的多步长链条任务,推理阶段的上下文长度和键值缓存(KV Cache)急剧膨胀。单颗芯片的 SRAM 容量根本装不下膨胀的缓存,跨芯片切分又会让硬件成本失控。
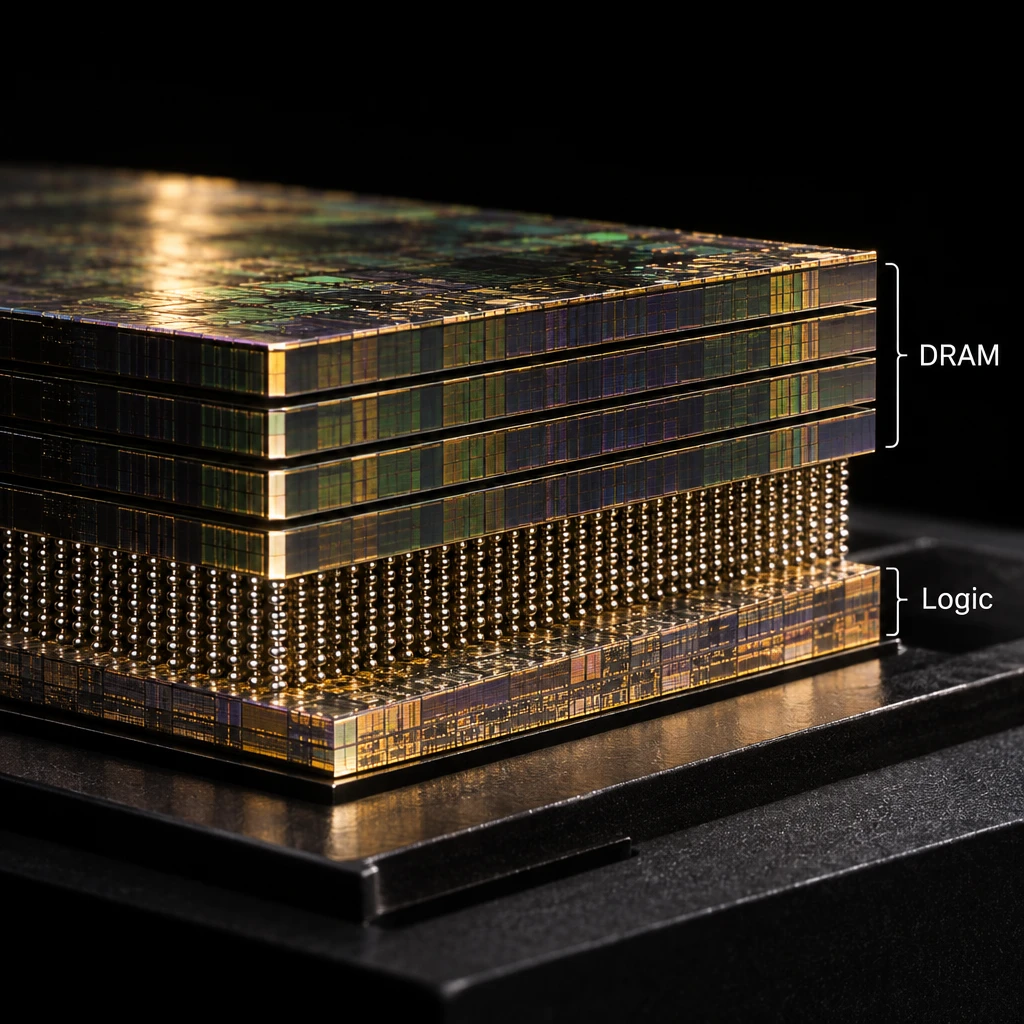
发觉此路不通的 Fractile 被迫推倒重来,转向与内存厂商及晶圆厂合作,把最常见的 DRAM 直接垂直堆叠在计算芯片上方。
按照官方说法,这种堆叠 DRAM 架构的单芯片内存带宽能达到传统 HBM 芯片的 25 倍,目标是每秒输出数千个 token。但细看就会发现,它早年宣传的“速度提升 100 倍、成本降低 10 倍、能效提升 20 倍”既没指明对比哪款 GPU,也缺乏实测支撑。
更隐蔽的赌注藏在软件里。Fractile 把自己定位为前沿 AI 公司,不仅想靠编译器适配现有模型,还试图推动大模型向更稀疏的混合专家(MoE)架构演进,以此吃满高带宽红利。
- 风险.既要证明新硬件能流片量产,又要说服模型厂商配合修改底层模型结构,这等于把商业化难度翻了一倍。
刺破推理芯片的跑分迷雾
媒体喜欢把 Fractile、Etched、OLIX 和 Axelera 放在一起,统称为挑战推理成本的芯片新星。把这四家放上同一张桌子,本身就是外行看热闹。
Axelera 主打的是功耗 30 到 45W 的 Europa 边缘推理卡,根本不在数据中心大模型集群的牌桌上;况且其官网连同一款 Qwen3-30B-A3B 模型在 batch 1 下的速度都写出了 83.4 tokens/s 和 53.5 tokens/s 两个自相矛盾的数字。真正和 Fractile 抢数据中心预算的,是同样盯上专用推理的 Etched 和 OLIX,而这几家最擅长的就是用不同口径的跑分制造性能幻觉。
脱离单用户延迟谈总吞吐量,是推理芯片最常见的数字障眼法。
比如 Etched 曾宣称 8 芯片服务器在 Llama 70B 下总吞吐量超过 50 万 tokens/s,目前已有可用硅片进入客户验证;OLIX 则宣称其采用 SRAM 与光互连的芯片在 100B 模型下每用户速度超 1 万 tokens/s,计划 2027 年下半年交付。一个报的是整机极限吞吐,一个报的是单用户极限速度,直接拿去除以英伟达的单卡数据,算出来的“几十倍提升”在工程采购上毫无意义。
哪怕在英伟达自己的产品线里,脱离交互延迟谈性能也是耍流氓。根据 SemiAnalysis 的 InferenceX 独立基准测试(基于 GLM 5/5.1 模型,FP8 精度,8000 输入 / 1000 输出),当单用户生成速度要求变化时,芯片的胜负关系会彻底反转:
| 芯片型号 | 47 tok/s/user 吞吐量 | 47 tok/s/user 百万 token 成本 | 88 tok/s/user 吞吐量 | 88 tok/s/user 百万 token 成本 |
|---|---|---|---|---|
| NVIDIA GB300 NVL72 | 6056 tok/s/chip | 0.106 美元 | 526 tok/s/chip | 1.219 美元 |
| NVIDIA B200 | 1360 tok/s/chip | 0.353 美元 | 780 tok/s/chip | 0.616 美元 |
看懂这张表,就能看懂云厂商采购时的真实算盘。在 47 tok/s/user 的常规速度下,GB300 的吞吐量是 B200 的 4.4 倍,成本只有后者的三分之一;可一旦把交互速度要求拉高到 88 tok/s/user,GB300 的单卡吞吐暴跌超九成,反倒是 B200 的吞吐量反超,且把成本压到了 GB300 的一半(0.616 美元 vs 1.219 美元)。
《韩非子》有言,“夫言行者,以功用为之的彀者也”。射箭要看靶心,买芯片要看固定延迟下的真实产出。19 世纪末铁路狂潮时,无数新机车公司宣称在空载平直轨道上跑出了创纪录的时速,最后活下来的,却只有那些能在满载爬坡时算清每吨英里燃煤账本的厂商。今天的主权基金和硅谷风投为英国算力主权买单,情绪价值可以给到 70 亿,但云厂商的机房不认PPT。
这事对两条线上的人敲响了警钟。还在死磕纯 SRAM 架构的同行(如 OLIX),必须回答 Fractile 当年因容量放弃的难题该如何绕过;而手握预算的云厂商与大模型 API 提供商,在 2027 年看到 Fractile 的真机时,只需要拿出一把尺子:锁死首字延迟(TTFT)与单用户 80 tok/s 以上的生成速度,把机柜散热、网络互连和编译器折损全部算进总拥有成本(TCO),看它还能不能比 B200 便宜。