计算工具的狂飙突进,没有直接改写物理世界的运转节律。Endura Therapeutics 联合创始人 Adrian Sanborn 近日公开指出,代码生成与信息综合的提速让科学研究的思考成本大幅下跌,但耗时数日乃至数周的湿实验物理验证并没有因此变快。面对思考变便宜而执行依然昂贵的现实,生物医药行业迅速分化为两条路径:少数依靠巨额资本搭建专有测量平台的代工厂,以及将大模型融入决策与研发全流程的敏捷领航者。
这场分化的本质,是数字世界的敏捷度与分子层面的迟滞感发生了剧烈碰撞。当算力巨头相继涉足生物实验,真正的分水岭不在于谁能更快调用大模型写出假说,而在于企业如何处置假说爆炸与实验通量之间的残酷落差。
工业化测量:异构数据定义资本壁垒
在代工厂这一侧,竞争的核心筹码是自建专用装置产生第一手生物学数据。通用大语言模型无法凭空推演未经测量的细胞微观活动,谁能工业化地采集物理信号,谁就掌握了训练预测模型的独家燃料。
这种测量能力的建立极其消耗资本,不同平台切入的物理测量维度也截然不同。Xaira 采用 Perturb-seq 绘制单细胞表达谱,其 X-Atlas/Pisces 数据集包含了跨多种细胞环境的 2560 万个单细胞转录组;Tahoe Therapeutics 则通过细胞村多路复用技术,打造出跨细胞系与药物剂量条件的 Tahoe-100M 数据集,单细胞转录组规模达到约 1 亿个。
测序通量之外,动态成像与生化特异性同样在被硬件重塑。Octant 针对其名为 Hypatia 的自动化筛选系统,设定了每周通量超过 200,000 种化合物的目标;NewLimit 开发的 RESTORE-seq 技术利用汇集条形码转录因子载荷,支持数千个细胞重编程假说的并行测试。在蛋白质与 RNA 层面,insitro 将汇集 CRISPR 筛选、高内涵细胞成像与机器学习融合在 POSH 平台上,成果已发表在《Nature Communications》;Eikon Therapeutics 则借助超分辨率活细胞单分子追踪技术,用定制系统捕捉活体蛋白质运动;Endura Therapeutics 自身依托 TRANSCEND 平台,利用可测序的突变信号直接测定细胞内小分子与 RNA 靶点的结合事件。
这些平台虽然都被统称为代工厂,但各家的底层通量无法简单横向对比。单细胞数量、活细胞动态轨迹、化合物周处理量与 RNA 突变读数属于完全不同的物理口径。这类基础设施的试错成本极其高昂,建立在漫长的工程调试与昂贵的硬件采购之上。
胶水代码清零:抹平生信与湿实验的组织接缝
如果说代工厂是极少数重度资本玩家的专利,那么领航者模式则是所有研发团队都能即刻采纳的生存方式。AI 带来的直接红利,并不在于模型瞬间设计出完美分子,而在于消除了软件工程中的胶水成本。
长期以来,科研探索的本质要求实验协议频繁变化,而每一次方案调整都需要对应的生物信息分析管道同步改写。过去这需要实验人员提出需求,排队等待专职生信工程师排期,耗时常以周为单位,不少科研人员甚至因此放弃尝试微调协议。如今大语言模型接管了数据清洗与分析脚本的编写,代码修改压缩到了几小时之内。
决定科研试错节奏的从来不是算力上限,而是推翻并重建分析管道的边际成本。
软件供应链的采购逻辑也随之逆转。过去动辄花费六位数授权费的现成实验室管理系统,往往只能迁就所有机构的最低通用需求;现在研发团队能在一天之内搭建出贴合自身生化特性的交互式数据看板,让实验员越过中间环节直接与原生数据交互。
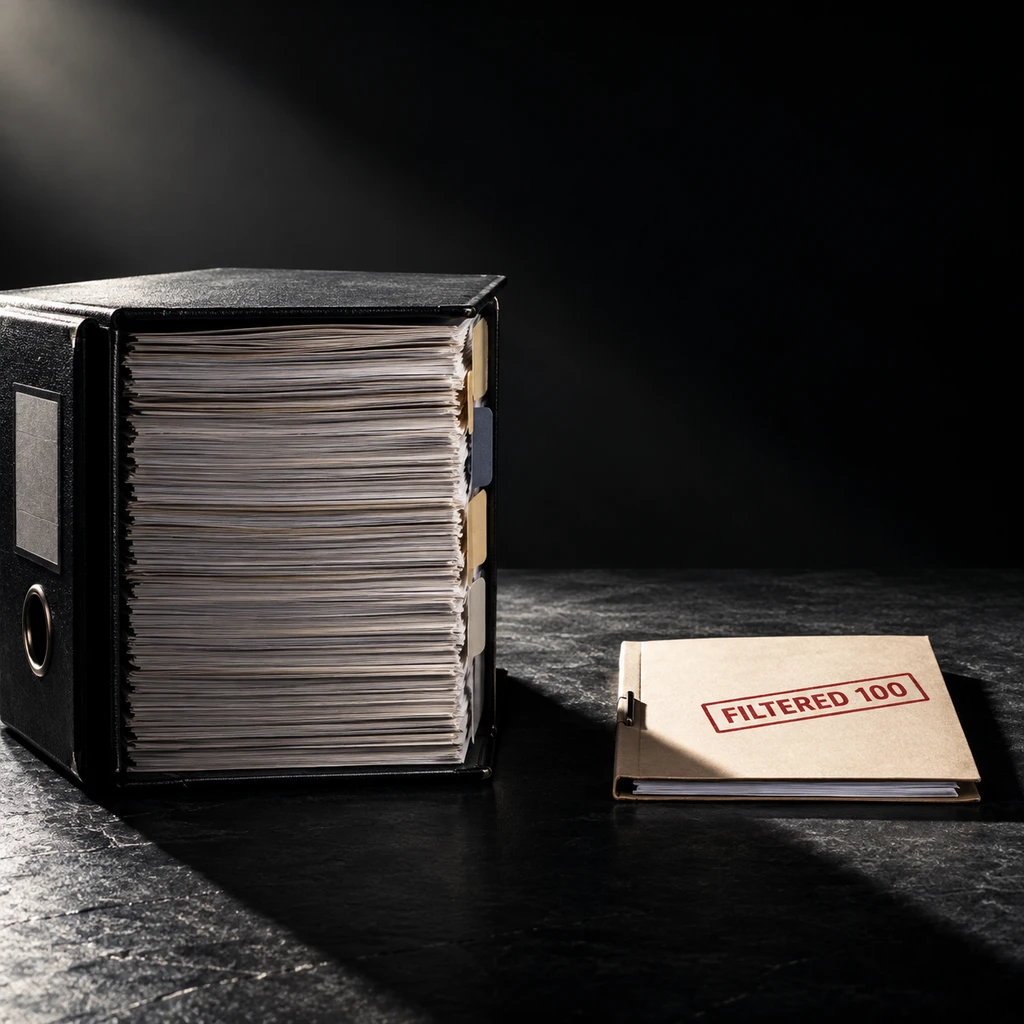
这种推演能力还能直接用于疾病适应症的早期筛选。通常制药团队只能组织专家对 5 个左右的预选疾病开展尽调,而 Endura 通过部署大语言模型智能体,在初筛阶段直接横扫了 500 个疾病靶点,每个靶点生成数页评估;随后将过滤后的约 100 个靶点交由更严厉的质询智能体,生成数十页包含既往失败案例和竞品反思的深度报告。原本需要一个世纪专家工时的案头排查,在几天内变成了可供人类科学家核对的决策底稿。
- 结论.将大模型直接部署在科研人员手边编写胶水工具,比采购通用 SaaS 软件更能保留生物学实验的灵活性。
假说泡沫与交付现实
决策加速不等于发现加速。领航者模式用极低成本制造了成百上千个看似严谨的假说,却容易在下游产生新的结构性拥堵。
科学试错的本质并没有改变。如果前期初筛仅仅是泛化文献的重组,没有伴随真实的生物命中率提升,那么急剧膨胀的候选管线只会将有限的湿实验操作淹没在虚假线索中。过早说不固然有价值,但大模型筛选出的靶点依然必须经历体外生化反应、细胞毒性、体内代谢与临床转化的重重考核,没有任何一段代码能替代分子在动物体内的真实分布。
- 风险.若缺乏严苛的真实文献回溯与物理验证门槛,假说通量的指数级释放会直接瘫痪下游湿实验资源的承载能力。
自动化代工厂与智能领航者并非绝缘的孤岛,前者同样依赖模型决定下周该测量何种突变,后者也必须借助前者的设备交付实体结果。需要辨清的是,像 Periodic Labs 这类主攻物理与材料科学自动化闭环的机构,与生物医药筛选平台存在明显的专业鸿沟,行业不能将所有自动化实验混为一谈。
当思考不再昂贵,科学竞争的胜负手反而回到了最朴素的物理现实。谁能以最高的准确度将代码假说收敛至真实的物理管道,谁才能在浩瀚的数据沙盘中,真正筛出那颗能够治病救人的药丸。