智能体在执行任务时,最昂贵的动作往往不是推理,而是反复自回归生成一堆结构化废话。为了选择一个已知按钮,大模型要从头预测十几个 token,耗去数百毫秒。
2026年9月,由 Jacky Kwok、Marco Pavone、Christopher Ré 与 Azalia Mirhoseini 等学者组成的研究团队 Contrastive-LM 拿出了针对性方案:正式开源对比语言模型 CLM-8B。官方公布的代码库里,核心可训练资产只有一个约 75 MB 的投影头文件,却宣称在零样本游戏决策中跑出了比 TypeSafe AI 商业闭源模型 Jev 快 9 倍 的惊人延迟(16.5 ms 对比 149.8 ms)。
抛弃逐字生成的幻觉,让大模型退回检索排序,是智能体运行时最精明的一次算计。
宣传口号看似用开源轻量击溃了商业巨头,但只要撕开 75 MB 的包装纸,就会发现这并非通用智能的跃升,而是一场极其精巧的工程取舍。
大模型退回向量点积,快思考不做生成
学术界很早就提出将智能体系统拆分为慢思考与快思考(System One)。TypeSafe AI 在 2026 年 9 月 15 日开启早期访问的 Jev 走的就是免文本生成的强类型路线,直接输出带概率的结构化决策。CLM-8B 锚定完全相同的 API 接口,提供三种决策原语:布尔真值概率(Noul)、枚举选项选取(Choice)与规则打分(Score)。
不同之处在于底层的实现路径。CLM 没有沿用自回归生成,而是引入双编码器架构,采用双向 InfoNCE 损失进行对比学习。
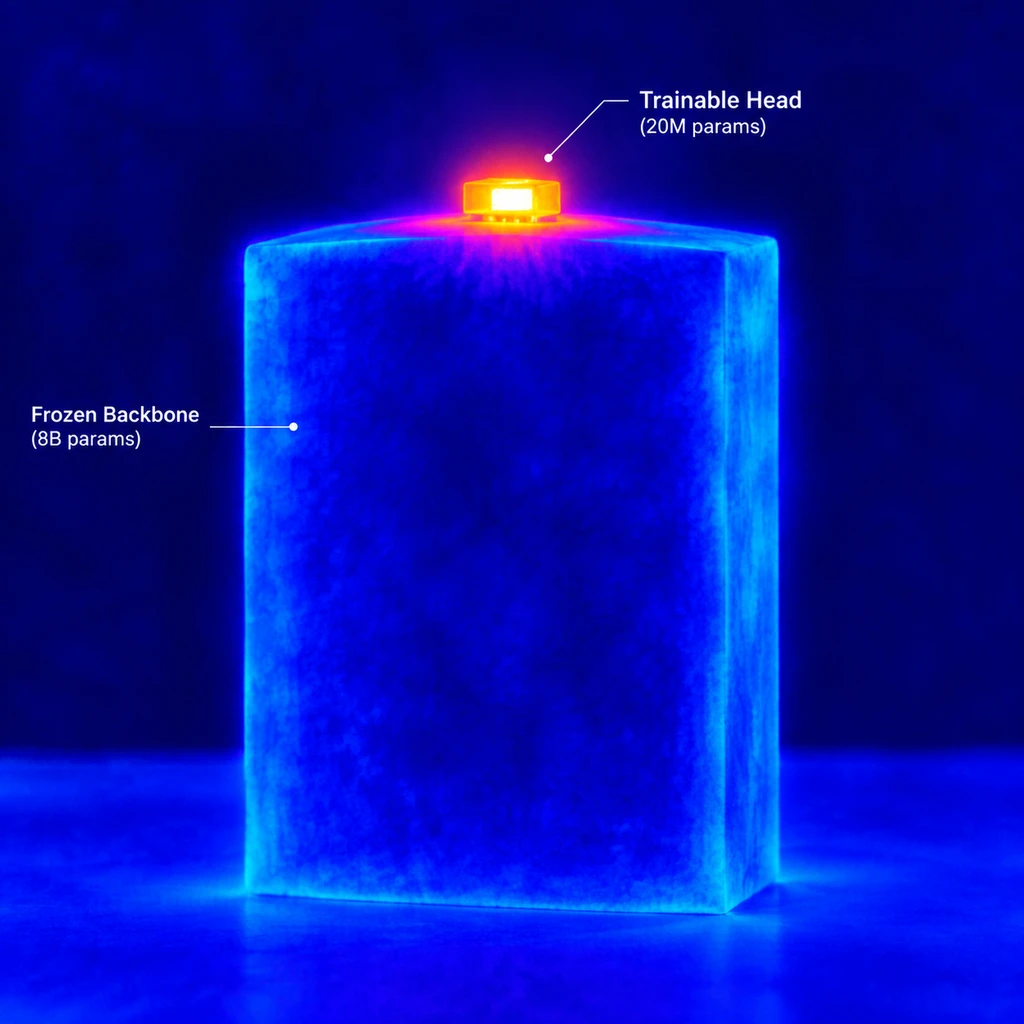
这套架构将底层骨干网络完全冻结,选用了 Qwen3-8B,配合特定的尾标记池化(last-token pooling)抽取特征。团队只在顶层挂载了约 2000 万参数的可训练投影头,用于状态与动作向量的对齐。
训练过程遵循三阶段课程体系:首先在约 6000 万 Nemotron DQA 问答对上进行预训练,准确率从基线爬升至 52.1%;随后引入 Gemini 2.5 Flash-Lite 合成的约 3000 万困难负例做中期训练,将留出题目准确率拉升至 69.2%;最后执行后训练,采用 40% 的 Nemotron 数据重放配合来自 Agent Data Protocol、Endless-Terminals 与 LiteCoder-Terminal-SFT 的约 100 万条真实轨迹。
训练数据显示,如果跳过预训练直接在中期负例上强行起步,准确率最高只能摸到 62.4%,随后便陷入过拟合。
9倍提速背后的缓存红利与硬件真相
在 Contrastive-LM 公布的基准数据里,CLM-8B 几乎处处压制商业对手。但如果仔细探究这 9 倍加速的测试场景,就会发现关键的变量约束。
| 评测任务 | CLM-8B 延迟 | Jev 延迟 | CLM-8B 成绩 | Jev 成绩 |
|---|---|---|---|---|
| T-Rex 游戏 | 16.5 ms | 149.8 ms | 5/5 | 5/5 |
| 超级马力欧 (Super Mario) | 33.5 ms | 132.6 ms | 5/5 | 5/5 |
| 工具调用 (BFCL v4) | 76.8 ms | 125.5 ms | 95.2% | 99.2% |
| 网页竞速 (WikiRacing) | 79.8 ms | 225.0 ms | 26/30 | 30/30 |
最亮眼的 9 倍提速来自 T-Rex 恐龙跳跃游戏。这一任务的典型特征是候选动作极度固定,无非跳跃、下蹲或等待。
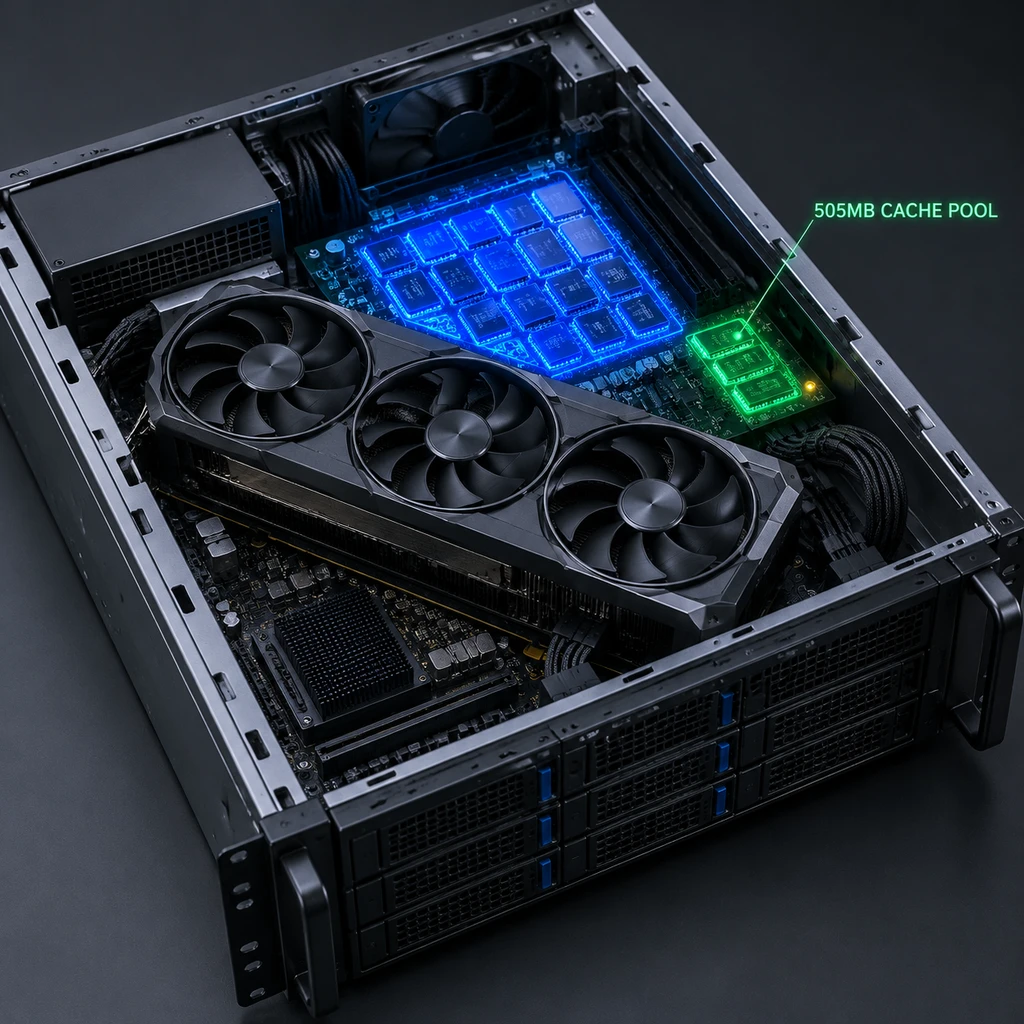
智能体在多步循环中,状态每步都在变,但动作集合长期恒定。CLM 服务端采用 CPU 与 GPU 分离架构:CPU 服务处理投影头与 API 逻辑,GPU 端借助 vLLM 调度 Qwen3-8B。系统在 GPU 显存中开辟了一块约 505 MB 的专属缓存池,直接把预先计算好的候选动作向量锁死在显存内。
在单张 RTX 4090 显卡上,面对 3 个固定候选动作,重复状态的响应延迟直接从 1.7 ms 断崖式下降到 0.6 ms。
宣传中反复强调的 75 MB 极小体积,在工程实操里存在认知落差。这个投影头不能单独运行,它必须附着在完整的 Qwen3-8B 骨干模型之上。而 Qwen3-8B 的原生分片权重就高达 16.4 GB。以 BF16 精度在短上下文下运行,仅底座就要吞掉约 15.9 GB 显存。
想要在本地把这套系统完整跑起来,企业至少需要准备一块配备 24GB 显存的显卡(如 RTX 3090 或 RTX 4090)。所谓的极简轻量,换算到机房里依然是一笔不可忽视的硬件与运维开销。
微调特化与工具调用的现实分野
在代码智能体的验证环节(Verifier),CLM 拿出了颇具冲击力的数据。在 Anthropic Opus 5 生成候选解的 DeepSWE 评测中,CLM 跑出 81.6% 的准确率,远超单次采样 73.7% 的基准表现;在 Terminal-Bench 2.1 上也达到了 87.6%。相比之下,商业模型 Jev 在这两个基准上的表现分别跌落至 71.1% 与 83.1%,选优后的结果甚至劣于直接单次采样。
但这组逆袭数据的成色需要理性核验。
首先,评测范围极其有限,DeepSWE 仅测试了 38 道留出题目,命中 31 题(理论上限为 34 题);Terminal-Bench 2.1 仅涉及 30 道题目,并非权威全量榜单的提交成绩。
更关键的差异在于,团队在代码验证任务中使用了针对性微调头,而并非通用的零样本基础头。
此外,在 BFCL v4 复杂工具调用基准中,CLM 的成功率落后于 Jev(95.2% 对比 99.2%)。工具调用不仅要求选对函数,还涉及参数构造、格式契合与抽象语法树匹配。纯粹依赖向量内积的判别模型,在处理多层嵌套与动态参数生成时,不可避免地遭遇表达能力的上限。
- 风险.面对动作空间动态多变、无法提前预热缓存的场景,CLM 的延迟优势会被编码重算迅速抹平;且团队自测数据未经过第三方复现,选优能力高度绑定特定微调头。
智能体快思考的路线分化
古人云:多算胜,少算不胜。智能体架构的演进,正在把多算与少算分置在不同的层级。
以 Jev 为代表的商业服务,追求的是开箱即用的结构化强类型生成。虽然它限制 Choice 候选上限为 255 个选项,但提供了免基础设施维护的云端 API 与经过精细校准的概率值。
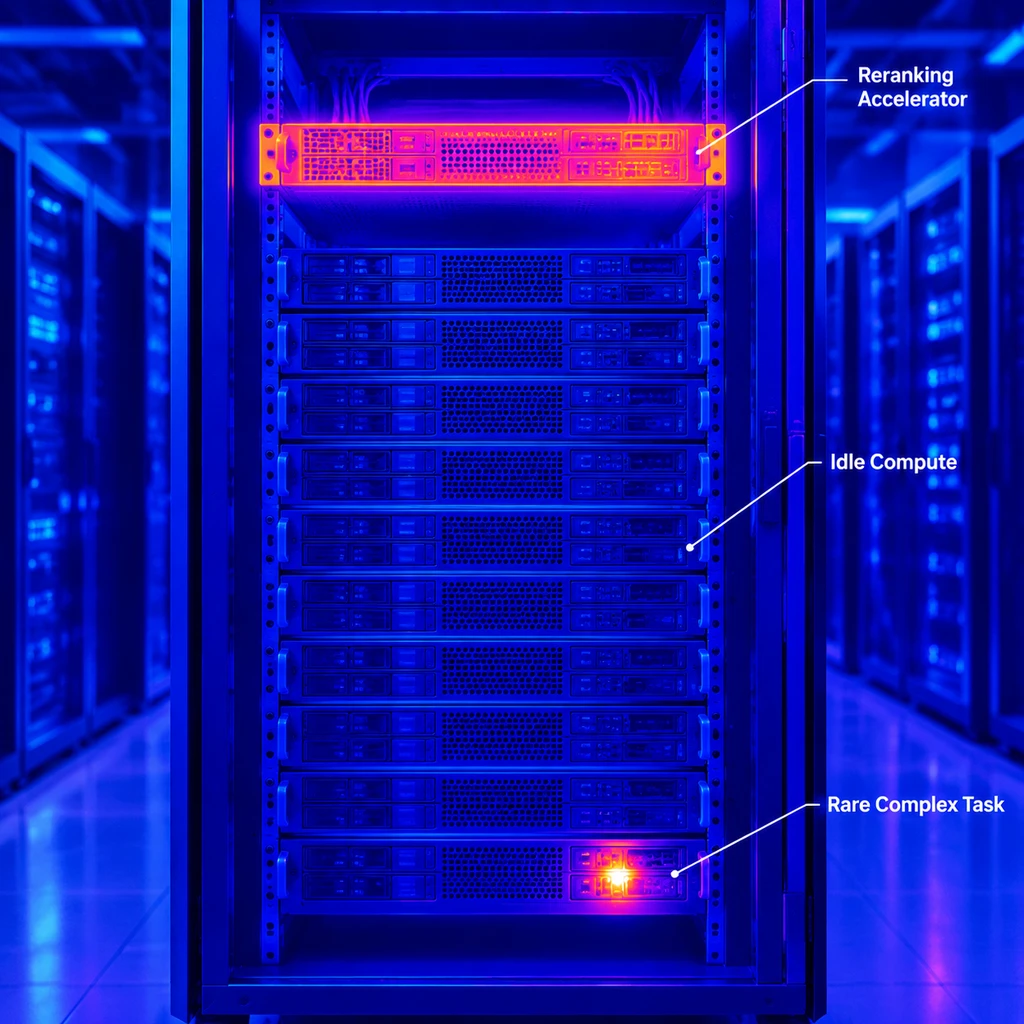
而由 Christopher Ré 团队推进的 CLM-8B,更像是工业界迫切需要的高性能筛选器(Reranker)。它抛弃文本生成,利用预计算向量理论上支撑上千量级候选集的瞬间打分。
- 结论.不要把 CLM-8B 当作替代通用 LLM 的执行底座,它的正确生态位是挂载在高吞吐流水线前端的动作重排器与快速验题官。
技术演进往往循环往复。智能体架构从最初迷信单一自回归模型包打天下,到今天把判别式与检索机制重新请回核心流程,并不是技术的倒退,而是工程理性对算力账本的必然妥协。