苹果在开源社区一向动作罕见,一旦扔出新模型,往往带有鲜明的工程意图。在 Hugging Face 悄然上线的 apple/LensVLM-9B,给困扰整个行业的长上下文显存墙提出了一个激进方案,不再费力去拼几十万个文本 Token,而是把长文本直接排版、拍照,压缩成几张低分辨率缩略图扔给视觉语言模型,等到真正需要细节时,再通过工具动态把相关页面展开回原始文本或高清图像。
这种设计直指长文本推理的核心痛点。全量长文本输入会导致 KV Cache 显存暴涨,而传统文本检索又需要维护体积庞大的向量索引。苹果给出的这套视觉压缩思路,表面上看颇为精巧,骨子里却是一笔代价沉重的算力倒挂账。
显存与耗时的倒挂账本
长文档问答的最大瓶颈从来不是算力上限,而是显存带宽。当上下文拉长到数万 Token 时,维持注意力机制运转的显存开销会迅速吞噬整张显卡。
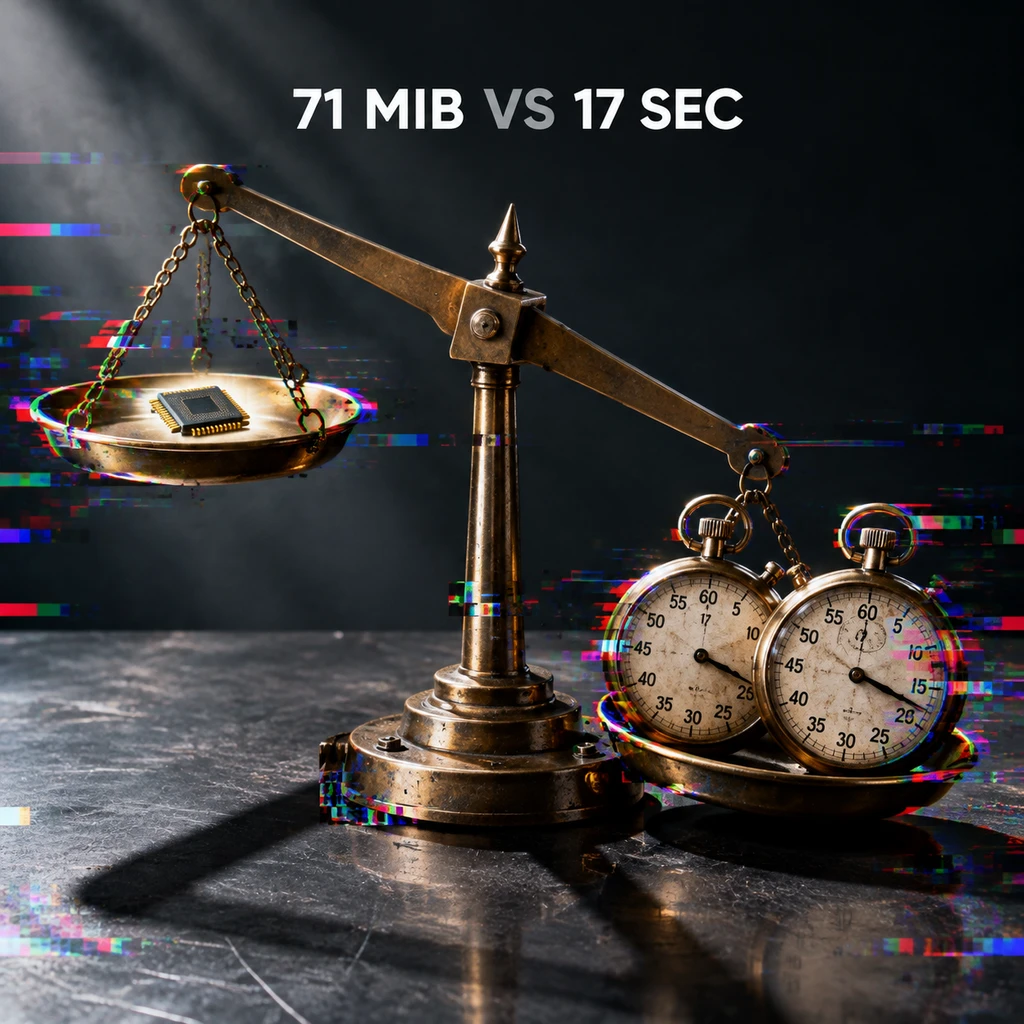
在 20 页图像测试用例中,LensVLM-9B 展现了显著的显存压缩能力,峰值 KV Cache 从基线的 334 MiB 大幅降至 71 MiB,直接省掉近八成的显存常驻开销。
但省下来的显存,几乎全被多轮往返的推理消耗殆尽。在 B200 GPU 单批次测试下,纯文本基线单轮耗时只需 8 秒,而 LensVLM-9B 单次调用展开请求的总耗时却拉长到了 17 秒。系统先要看缩略图、判断哪一页有用、触发工具调用,最后再将内容拼回上下文进行第二轮推理。以时间换空间换得如此彻底,意味着它天然与即时交互场景绝缘。
压缩极限下的断崖下跌
LensVLM-9B 基于 Qwen3.5-9B-Base 构建。苹果的研究团队在训练时冻结了视觉编码器和投影层,纯粹依靠指令微调与强化学习,让语言模型端学会使用特定标签与工具。
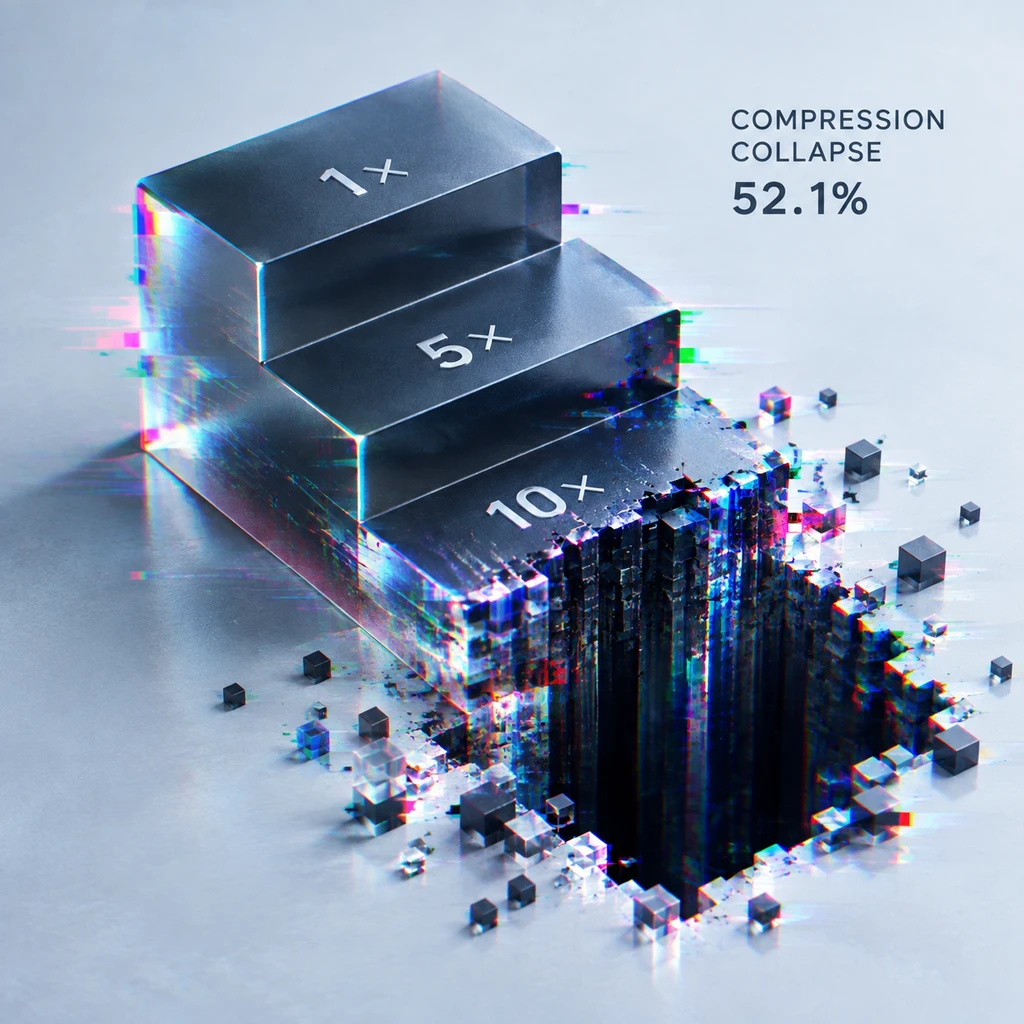
在 Reader 端渲染设定中,系统支持 5×、10× 和 15× 的目标压缩。折算进最终展开的关键页面后,对应的实际有效 Token 压缩比分别为 4.3×、7.4× 和 10.1×。
在 7 个长文本问答基准测试里,未压缩的全文本基线能拿到 72.4% 的平均准确率。当压缩倍率处在温和区间时,LensVLM 表现相对稳健,在 4.3× 压缩下拿下 68.9%,不仅大幅甩开传统视觉检索模型 ColPali 的 56.1%,也压过了知名文本检索模型 BGE-M3 的 65.1%。
视觉折叠能保留版面结构,却扛不住信息密度的硬性剥离。
然而一旦推到 10.1× 的极端压缩区间,系统局限迅速暴露。模型不仅整体问答准确率跌到 52.1%,关键页面的定位命中率更是从 5× 档位的 76.8% 出现滑坡,砸到了 52.1%。此时它的问答水平已经被最优纯文本检索方案 Jina-v4 追平至完全一致的 52.1%。多模态带来的版面感知优势,在过度压缩的马赛克文字前荡然无存。
并非端到端神话,仍需外部锚点
很多人容易产生一种误解,以为把文字拍成图片输入,大模型就能自行看图识字、端到端解决一切。但 LensVLM-9B 从底层设计上就不是通用 OCR。
它扮演的更像是一个带有空间感知的目录检索调度员。整个机制能够闭环,前提是后台必须始终驻留着完整的原始纯文本或高精度图像源文件。模型如果从低分辨率缩略图中察觉到了相关线索,就会发出指令,调用外部工具回填未经压缩的信息。一旦第一轮定位失误,被剧烈模糊化的字迹将彻底变成不可读的噪声,模型没有任何自愈能力。
- 风险.当前测试范围被严格限制在 32K 原始文本 Token 内,且官方仓库限制了外部反馈,尚未出现经得起检验的第三方复现基准。
在处理包含图表排版的原生 PDF 评测(MMLongBench-Doc)中,这种两阶段策略体现了其合理性,让模型调用高分辨率图像变焦工具,在 15× 设定下取得了 41.9% 的准确率,显著高于调用传统外部 OCR 工具的 32.1%。这说明它在视觉版面结构识别上的确高出纯文本分块一头,但这种能力必须放在特定边界内审视。
买椟还珠的道理在工程界屡见不鲜。LensVLM 确实证明了将长文本转化为视觉信号分级加载的可行性,把宝贵的显存腾给了模型本身。但在端侧设备普遍对延迟极度敏感、云端推理按秒计费的现实约束下,让用户多等一倍的时间来换取显存缩减,这笔买卖在短期内依然只是一场极其特殊的工程权衡。