在 2026 年 8 月 27 日至 9 月 9 日期间,Cloudflare 的 Workers AI 服务经历了一次罕见且严重的跨租户数据泄露。其托管的模型 GLM-5.3 在处理超过 681,280 token 的超长上下文请求时,因推理引擎 SGLang 的配置漏洞,错误地将前序用户的 KV 缓存片段输出给了后续请求。虽然 Cloudflare 确认受影响的仅有 155 条响应,且无恶意利用痕迹,但这一事件暴露了分布式推理架构下,底层内存逻辑隔离在极端边界情况下的脆性。
分布式推理的架构代价
Cloudflare 的 Workers AI 采用的是一种高性能的“解耦预填充/解码”(Disaggregated Prefill/Decode)架构。简单来说,它将大模型任务拆解为两步:由预填充(Prefill)节点处理 prompt 并生成 KV 缓存,通过 Mooncake 协议传输给解码(Decode)节点生成回答。
KV 缓存本质上是一组固定大小的内存页,为了追求极致的吞吐量,推理引擎通常不会在请求完成后立刻清零内存,而是通过逻辑标记实现“覆盖式复用”。这要求引擎必须极其精准地追踪每一个内存页的归属。然而,GLM-5.3 这次事故证明,当配置逻辑出现偏差时,这种复用机制会直接演变为数据污染。
为什么是 681,280 这个数字?
问题的核心在于 Cloudflare 的配置与引擎实现之间的脱节。GLM-5.3 本身的上下文窗口配置为 1,048,576 token,但物理 GPU 的 KV 缓存池容量仅能容纳 681,280 token。
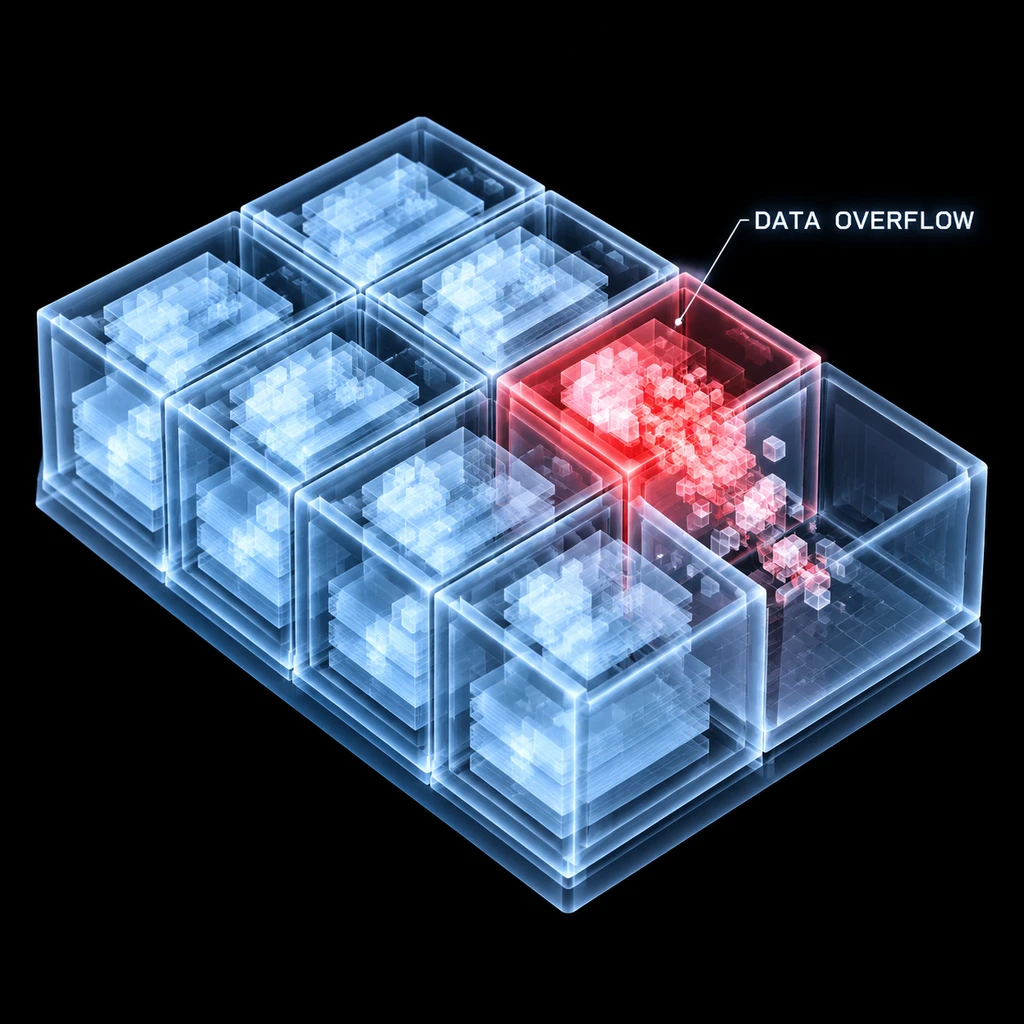
在正常流程下,若请求超出容量,引擎应返回错误。但 SGLang 存在一个调度逻辑漏洞:当请求被拒绝(Rejected)时,它错误地将该请求的 KV 缓存传输给了解码节点。解码节点由于无法区分“已处理的有效数据”与“被拒绝请求产生的残留占位符”,直接读取了内存页中残留的上一位用户的历史状态。
- 风险.在复杂的分布式集群中,如果准入控制逻辑(Admission Queue)仅校验请求是否“存活”而非校验请求是否“合法/完成”,跨节点的数据泄露几乎是必然的。
如何堵上这个技术债
Cloudflare 的修复措施包含两层逻辑:首先是物理上的配置对齐,将 KV 池扩容至 204 万 token,彻底避开了触发拒绝机制的风险;其次是在 SGLang 层面引入强制校验补丁(如 PR #36988 和 #38935),要求解码节点严格校验传输的 token 数量是否与预留空间匹配。
这一事件也提醒了开发者,在追求推理性能的过程中,往往会引入难以察觉的系统级脆弱点。
- 结论.对于依赖 disaggregated 架构的推理引擎维护者而言,将租户隔离逻辑前置到准入调度层,已成为确保大规模高并发推理安全性不可避开的共识。