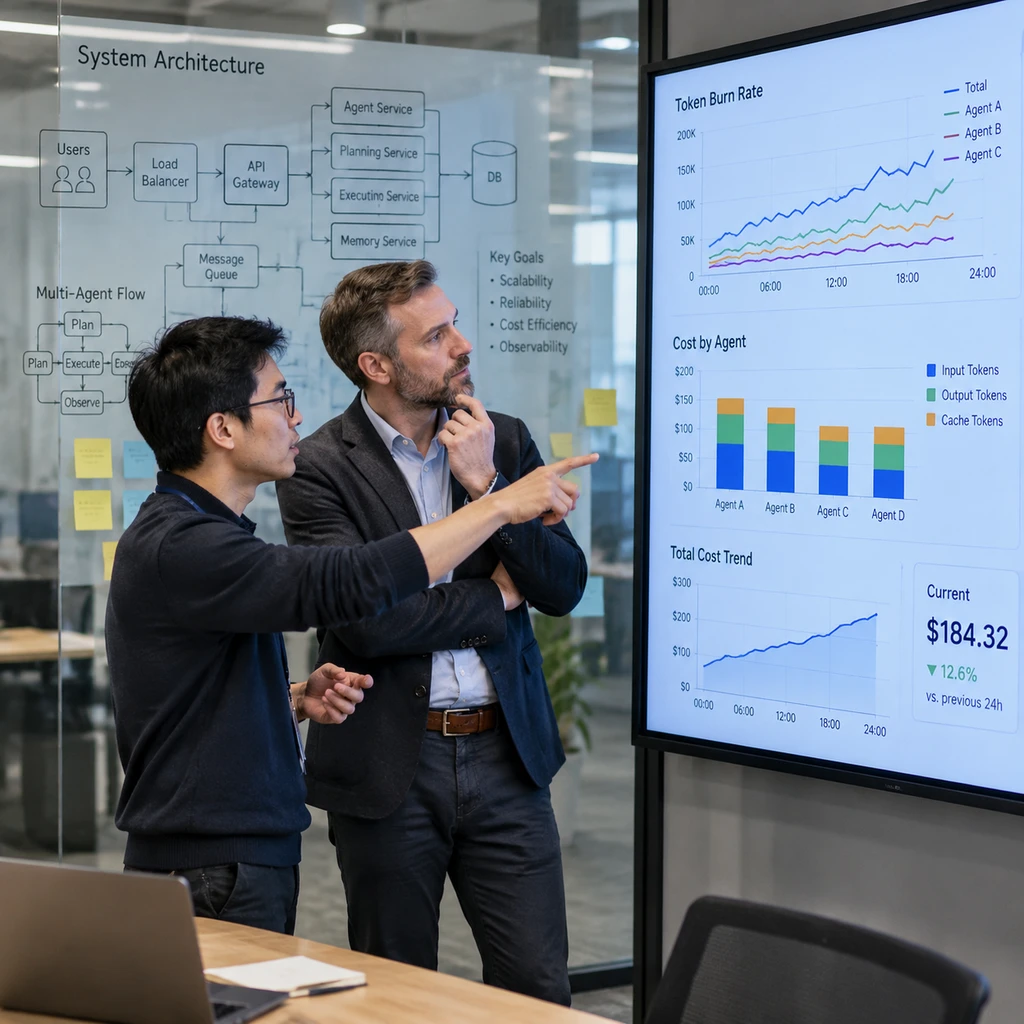
评估公司 Vals AI 与大模型研发机构 Anthropic 近期披露的评测数据,给行业内持续高烧的多智能体协作热潮泼了一盆冷水。实测表明,让多个模型分工协作的集群架构,往往让企业的调用成本膨胀 1.8 至 5.1 倍,但在绝大多数实际场景中,最终产出几乎没有迎来可衡量的质量改善。
这项研究刺破了人多力量大的工程幻觉。许多技术团队在单模型推理遇到天花板时,试图通过多智能体相互拆解、执行与交叉校验来攻克复杂任务。然而来自主流实验室的硬核测试证实,智能体团队买到的是任务处理的并发速度,而非更高的智力上限;为了这种微弱的提速,企业正在向 API 提供商支付惊人的协调税。
数据击碎神话:5 倍成本换不来质量跃迁
Vals AI 在涵盖 50 个应用的 Vibe Code Bench 基准评测中,针对 GPT-6 Sol 与 Claude Opus 5.5 展开了单体与团队架构的严苛对照。在全部四组跨推理强度的对比中,只有 GPT-6 Sol 在中等推理强度下取得了统计学显著的增长:团队架构得分从 77.6% 提升至 84.9%(提升 7.3 分,p=0.005),但对应成本也从 1.22 美元直接增至 3.07 美元。
在剩下的三组对比中,团队模式的 p 值均落在 0.16 至 0.81 之间,意味着在统计学意义上,团队与单体几乎没有能力差异。最具讽刺意味的断崖发生在 Claude Opus 5.5 的极限推理测试中:
当单体 Claude Opus 5.5 已经跑在最高推理强度时,其平均得分达到 89.8%,单应用成本为 $23.77;组建多智能体团队后,得分仅微升至 93.2%,单应用成本却暴增至 $122。为了这不足 4 个百分点的非显著浮动,企业客户必须付出超过 5.1 倍 的真实账单。
需要指出的是,Vals AI 亦承认其评测未进行多次随机种子重复测试,分配提示词的编写差异可能引入混淆变量。但在工程实操层面,这一组极端对比足以表明:当底层单模型已被完全压榨至高算力状态时,继续向其上方堆砌角色扮演式的代理拓扑,已经很难逼出额外的问题解决能力。
算力折换的是时间,从来不是智力上限
如果多智能体无法换取质量飞跃,它在工业界的真实价值究竟落在何处?OpenAI 研究员 Noam Brown 在 Dwarkesh 播客中给出了清晰的定性:多智能体系统的主要价值是以算力换时间,其核心收益在于并发加速,而非输出更完美的答案。
Brown 指出,4 个智能体协作往往能以 2 倍的成本将任务耗时缩短一半。但这种加速比严格受制于任务形态。网络检索、数学验证这类可以轻易切分的子任务,非常适合并行展开;而像连贯编写一本长篇小说这类需要强上下文依赖的工作,堆叠一万个智能体,其结果就像让一万个人同时写同一部小说一样荒谬。
Anthropic 在自身公布的技术测试中也确认了同样的边际收益收窄轨迹:
| 任务类型(Opus 5.5) | 1 个智能体 | 10 个智能体 | 30 个智能体 | 100 个智能体 |
|---|---|---|---|---|
| 知识库构建 (得分) | 0.53 | 0.70 | 0.71 | 0.74 |
| 交互定理证明 (Lean 得分) | 0.39 | 0.66 | 0.66 | 0.68 |
在长达 24 小时的知识库构建任务中,智能体规模从 1 扩到 10,得分确实从 0.53 跳升至 0.70。然而当继续扩展到 30 个乃至 100 个智能体时,质量曲线几乎完全走平,从 30 增加到 100 仅换来 0.03 的分数微调。另一款参与测试的模型 Fable 5.1 更具代表性:在知识库任务上将其智能体规模从 30 个强行推至 100 个时,其得分甚至发生了轻微倒退。
在包含 166 个基准任务的 ProgramBench 测试中,Anthropic 发现 5 智能体架构使隐藏测试通过率达到 60% 的速度比单智能体快了 2.7 倍。但这一切并非免费午餐,在 20M token 的严格预算约束下,速度收益的背后是 token 消耗速率的急剧失控。
拆解协调税:企业账单里的隐形黑洞
导致多智能体集群在工业界投入产出比崩塌的直接元凶,被 OpenAI Codex 开发者 Eric Provencher 归纳为协调税。在实际工程落地中,并发智能体往往没有在攻克业务核心逻辑,而是在彼此的上下文摩擦中空转。
Provencher 直言,运行超过 2 个子智能体通常就会引发灾难。为了实现所谓的反思与审查,系统会让子代理反复互相询问、打包全量上下文重发,并对彼此输出的代码挑刺。多智能体协作本质上面临着分布式系统典型的通信开销与《人月神话》困境:向一个本就需要连贯逻辑的任务里添加更多沟通节点,只会把时间全耗在信息同步上。
多智能体不是质量工具,而是一座用成倍 Token 账单折换执行耗时的昂贵加速器。
更严重的问题在于官方基准测试往往掩盖了企业的真实财务代价。Anthropic 在系统卡统计中所呈现的 Token 开销,仅仅针对单一上下文窗口去重后的使用量,并未如实计入真实 API 架构中每一次请求所重复传递的全局上下文。在实际云端调用中,这种无休止的上下文在代理之间来回搬运,最终全部转化成了无法带来业务收益的 API 扣费。
- 风险.如果企业自动化业务并不要求任务必须在数秒内秒级完成,盲目采用超过 2 个节点的复杂智能体集群,极易演变为只烧 Token 不产出质量的负资产。
对于正在规划企业内部 AI 落地的架构师与技术决策者而言,现在的当务之急是重新评估所谓智能体蜂群的经济可行性。在绝大多数涉及深度推理和代码编写的任务上,与其让几个能力平庸的子代理假装开会讨论,不如直接将预算倾斜给单智能体深度思考方案,在更简练的异步管线中压榨单一模型的算力极限。