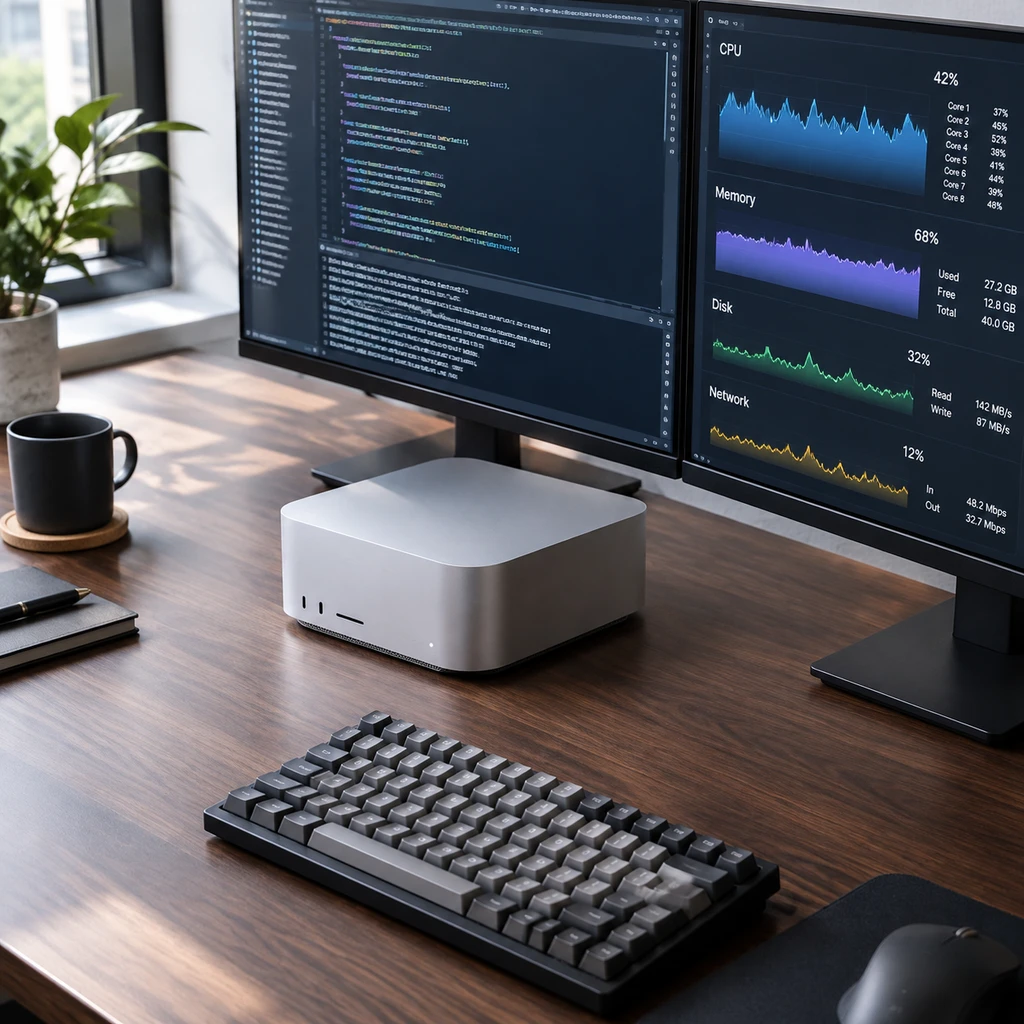
为了逃离云端巨头的月费订阅与数据窥视,科技爱好者正掀起一场把大模型搬回个人桌面的硬件军备竞赛。The Verge评测编辑Antonio G. Di Benedetto近期在一台配备256GB统一内存的M5 Ultra Mac Studio上,部署了开源框架Hermes Agent与1250亿参数的Qwen 3.8 Flash Next模型,试图让AI在完全私密的环境下接管日常事务。然而,这套价值数千美元的设备在经历配置挫折后,初期承担的核心工作只是一份经常因电脑休眠而中断的清晨简报与整理Steam游戏库。
花重金构建的本地智能体并未如预期般无缝接管工作,反而暴露出高昂硬件成本、工程断层与虚假安全感之间的尖锐矛盾。当消费级硬件开始以运行Agent为卖点时,用户买到的究竟是生产力飞跃,还是一个维护成本极高的昂贵玩具?
硬件账本:统一内存的算力军备竞赛
将千亿参数模型塞进个人电脑,首先是一场对硬件规格的严苛筛选。Antonio测试所用的M5 Ultra Mac Studio基础版起售价为5,499美元,配备30核CPU、64核GPU与96GB内存,于2026年9月22日开始发货。而在Windows阵营,高配Surface RTX Spark Dev Box定价达5,999美元,预计2026年11月发货;英伟达DGX Spark的官方定价更是达到6,950美元。
支撑大模型运行的关键不仅是容量,更是吞吐速率。M5 Ultra的统一内存带宽达到1.2TB/s,大幅领先M5 Max的614GB/s,更是将RTX Spark的300GB/s与DGX Spark的273GB/s甩在身后。然而,统一内存由操作系统、图形渲染与模型推理共同切分,无论是macOS还是Windows,都无法将标称内存全额划归模型权重。在扣除系统底噪后,真正留给复杂运算的余量远没有账面宽裕。
动辄五千美元的硬件投入,常常只换来一个被休眠打断的早报生成器。
工程断层:从能聊天到能办事的体验鸿沟
能顺畅输出文字的本地大模型,在转变为执行任务的智能体时会遭遇断崖式体验滑坡。Hermes Agent官方技术文档明确指出,执行Agent级别的长链条任务需要至少64,000 tokens的上下文窗口。庞大的系统提示词与外部工具说明,在推演初期就会对硬件施加极其沉重的计算负担。
MacStories的实测数据清晰还原了这一落差。在运行Qwen3.8-27B时,配备256GB内存的M5 Ultra日常生成速度为每秒48个token,略逊于RTX 5090的每秒59个token。但在扩展至128K长上下文后,M5 Ultra的生成速度骤降至每秒32.4 tokens,首字生成延迟(TTFT)攀升至4.0秒,是RTX 5090(2.0秒)的两倍。随着KV Cache持续吞噬宝贵的显存,原本敏捷的响应变得滞涩。更致命的是逻辑执行能力,社区实测显示,较小尺寸的模型在面临多轮工具调度时,极易陷入直接打印JSON代码却拒绝触发操作的死循环,甚至交出完全空白的响应。
隐私幻象与潜在的数据漏勺
推动用户自建本地工作站的核心动力是对数据主权的渴望。Antonio选择本地部署,很大程度上是为了分析未解禁笔记本规格这类不可外传的机密资料。但在未设置物理隔离的环境中,所谓绝对私密往往只是一种心理暗示。
虽然Hermes Agent宣称不主动收集遥测数据,但开发者文档中明文记录了一项名为shared_metrics的默认指标收集逻辑。普通用户如果不在配置文件中手动增加声明彻底关停,部分调用特征依然存在外溢可能。更现实的隐患在于网络交互渠道:当用户为了便捷将智能体挂载至Telegram、调用外部平台接口或保留云端回退路径时,信息流早已经由公网进出。只要网线没有拔掉,本地算力就不等于绝对的信息孤岛。
- 提醒.在本地部署开源Agent框架时,必须手动核对配置文件关闭底层遥测开关,并对具有网络读写权限的自动化插件执行网络流量审计。
掏出数千美元购买统一内存工作站的个人消费者,短期内恐怕难以得到媲美顶级云端集群的无缝助理体验。面对超长上下文带来的延迟陡增与工具调用的工程脆弱性,盲目追加硬件预算不如理性厘清边界:在本地大模型真正解决长链条推理之前,绝大多数琐碎流程并不需要一台昂贵的专属工作站来代劳。