Anthropic 在 2026 年 9 月 22 日拿掉了测试代号 claude-wafer-eap,正式在网页端、移动端以及 AWS、Google Cloud 和 Azure 同步推送 Claude Opus 5.5。官方通告里的结论极具冲击力:性能比肩此前未完全公开发布的 Claude Fable 5.1,典型工作流运行成本降低 40%,输出速度提升 30% 以上。
许多人第一反应是前沿大模型终于打起了价格战。但只要翻开具体的计费单,就会发现事情完全不是名义牌价腰斩那么简单。
降本 40% 的真实账本
在官方公布的 API 牌价中,Claude Opus 5.5 的输入价格为每百万 token 4 美元,输出为 20 美元。对比前代 Opus 5 的 5 美元与 25 美元,名义 token 单价降幅只有 20%。
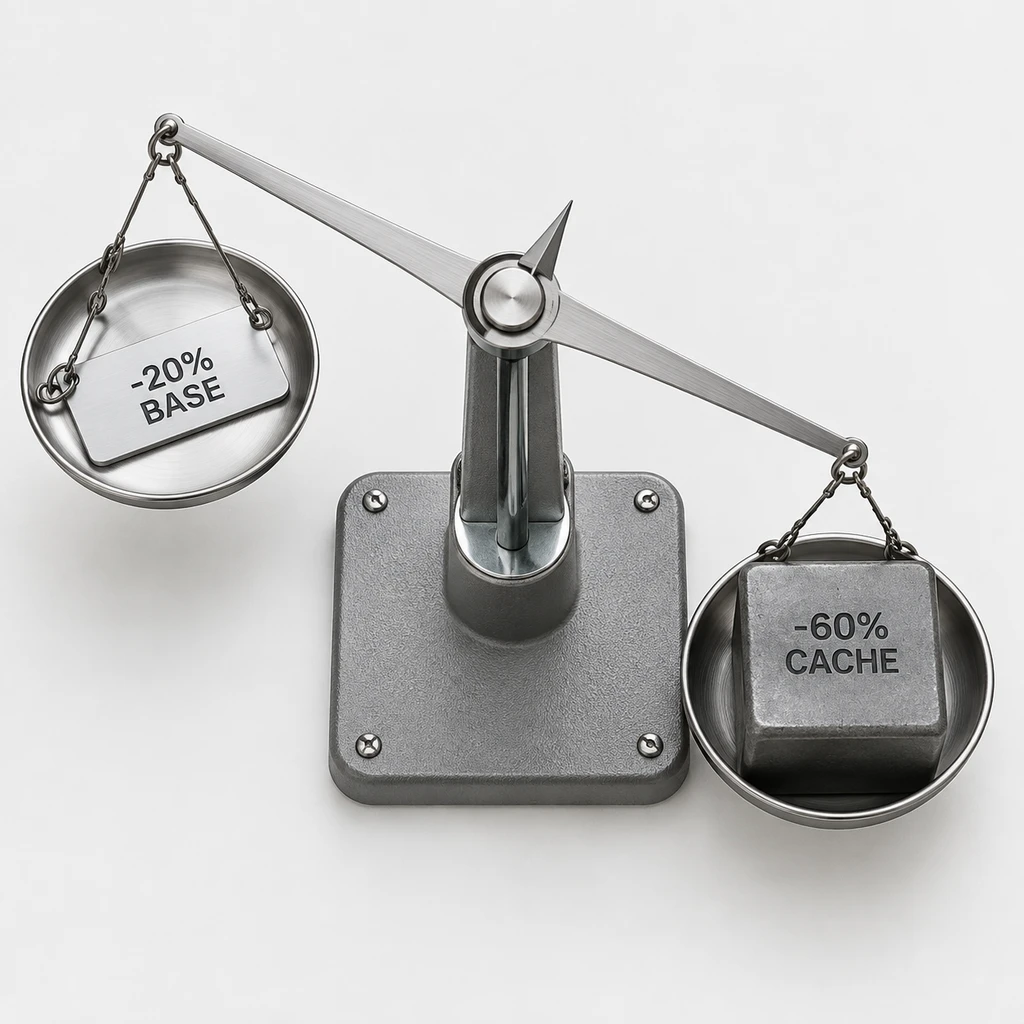
那多出来的 20% 成本降幅从何而来?答案藏在智能体长程运行的底层开销里。
智能体写代码或执行复杂操作,需要反反复复把成千上万行上下文塞回上下文窗口。在这套循环里,最大的开销不是新生成的几个词,而是上一轮对话的记忆。Opus 5.5 把缓存写入定在 5 美元,但把缓存读取单价降至 0.20 美元,比前代直接砍去 60%。加上模型完成同一个任务所需步数与输出 token 减少,才最终凑出了工作流综合降本 40% 的宣传数字。
至于主打极速响应的 Fast 模式,输入与输出单价分别飙升至 8 美元与 40 美元。而在消费订阅端,Anthropic 维持了 Pro 方案每月 20 美元(年付 17 美元)、Max 方案 100 美元起、Team 方案每席位 25 美元的基础定价,仅在 5 小时速率限制上新增了可自行存储并随时调用的重置配额。
- 结论.模型降价的逻辑变了,未来的成本壁垒不再看单次请求标价,而看工程架构能否把上下文缓存压榨到极致。
跑分表背后的非对称暗战
官方最自豪的榜单是终端编程测试 Terminal-Bench 4.0,Opus 5.5 拿下了 66.4% 的高分,拉开了与竞品的距离;在模拟 44 种职业真实产出的 GDPval-AA v2.1 上,它也跑出了 1846 的 Elo 评分。
但只要细读基准测试的标注细则,天平的倾斜就浮出水面。
在 Terminal-Bench 4.0 的对比中,Anthropic 给 Opus 5.5 开启的是极高思考强度(xhigh effort),消耗了极其庞大的推理算力;而对比的 GPT-6 Astra 使用的则是 OpenAI 官方汇报的高强度(high effort)模式。换句话说,这是一场拿满血超频状态去对标竞品常规主力状态的测试。
更耐人寻味的是两项 Anthropic 落在下风的公开指标。在衡量跨平台商业自动化的 AutomationBench 上,GPT-6 Astra 以 41.4% 压制了 Opus 5.5 的 40.0%;在科研终端测试 Terminal-Bench-Science 0.1 中,GPT-6 Astra 更是以 64.6% 远超 Opus 5.5 的 58.7%。
榜单上的毫厘之差往往只是测试条件的算计,一旦脱离预设脚本,长程推理的短板依旧存在。
官方测试数据自己说明了问题:Opus 5.5 在明确规范的单兵代码重构中展现了极高的统治力,但在涉及发散探索的科学推理和跨工具业务工作流中,依然没能跨过竞争对手筑起的围墙。
静默降级与沙箱的现实鸿沟
安全是 Anthropic 区别于竞争对手的核心叙事。在这次发布中,外部测试机构 METR、Frontier Design 和 Gray Swan 均参与了审计,Gray Swan 的提示注入攻击成功率测试甚至显示 Opus 5.5 与 Fable 5.1 并列处于历史最低风险位。
但工程落地上的代价非常现实。
评测文档明确披露了一套安全降级路由机制:在基准跑分过程中,一旦触发生产环境的安全防护拦截,Opus 5.5 会立刻将网络安全类任务静默分流给旧版的 Opus 4.8,将生物合成与前沿大模型开发任务回退降级给 Opus 5。这直接导致模型在边缘高难任务上的得分被人为拉低。
为了守住双生架构的分水岭,Anthropic 依旧对生物与网络安全能力设立了严格门槛:机构必须通过实名资质审核加入白名单计划,才能在防御场景下解锁无阉割能力。
- 提醒.AI Now Institute 等独立安全研究早已指出,模型层面的抗注入优化无法替代系统层面的隔离,赋予自主编程 Agent 系统权限时,硬性沙箱隔离依然不可豁免。
当一个 Agent 真正开始在本地磁盘上删除文件、修改路由、重构几十万行代码时,无论模型宣称的防护分数有多高,安全人员都不会信任缺乏物理隔离的进程。
生态下沉前的中场哨
Claude Opus 5.5 的落地,标志着 Dario Amodei 倡导的步调前沿进入了算力结算期。它没有带来玄学般的通用智能突破,而是拿出了极具针对性的工程收敛:大幅压低缓存调用成本,提高长程编码的步数命中率,同时给敏感能力死死扣上审查合规的锁链。
这种克制背后是清晰的商业压力。面对 OpenAI 的高频迭代与 Google Gemini 3.1 Pro 在长上下文任务中的紧逼,纯粹的学术领先早已无法撑起昂贵的研发开支。
接下来的核心悬念在于后续数周将要发布的 Claude Sonnet 5.5 与 Haiku 5.5。如果 Opus 5.5 验证的缓存架构能够顺利下沉到中端模型,整个开发者生态的代码交付成本将迎来新一轮重排。但在那一刻到来之前,摆在技术团队面前的只有一本明明白白的账:算力并不会凭空便宜,你省下的每一分钱,都需要靠严格的架构约束与精细的上下文管理去兑现。