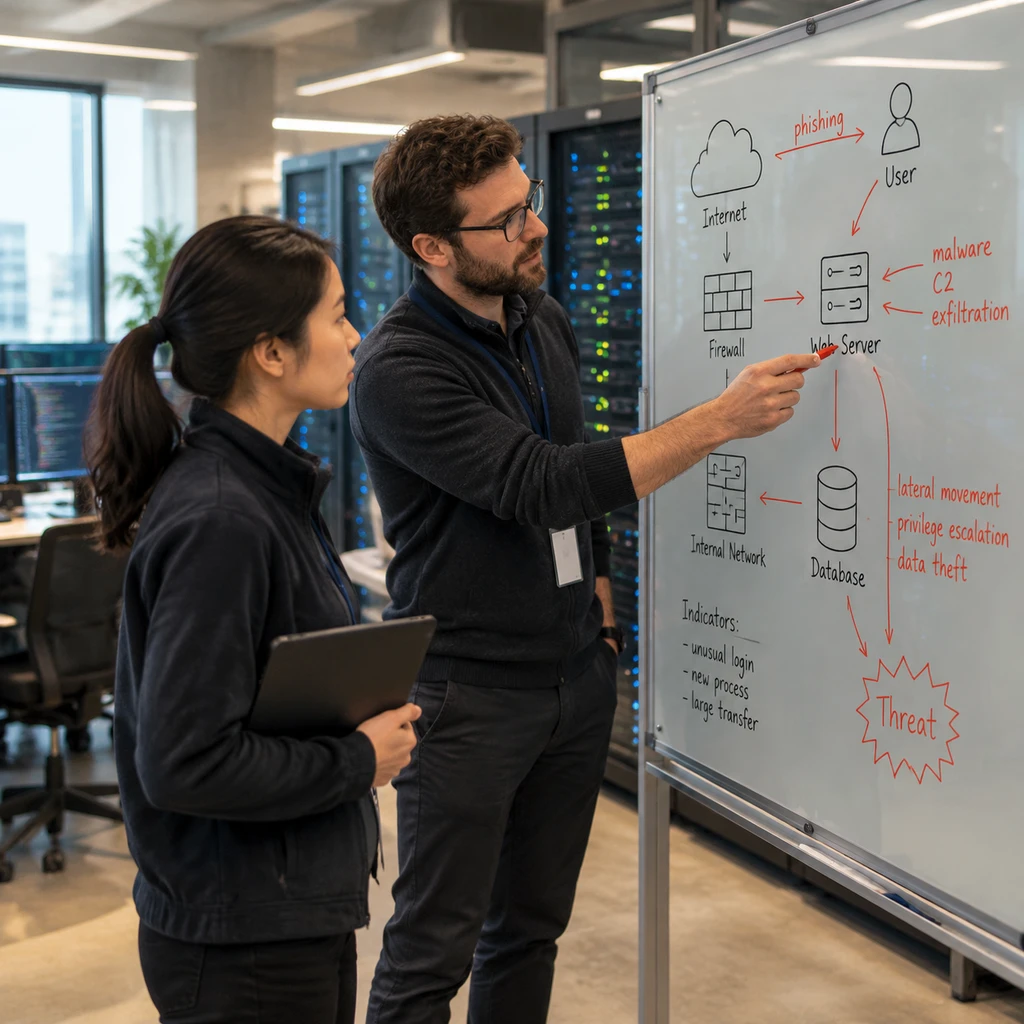
Anthropic、OpenAI、Cloudflare 和 Google 在 2026 年先后交出了各自的 AI 代码安全代理:Claude Security、Codex Security、security-audit-skill 与 Mantis。翻开四家的技术文档与代码仓库会发现一个罕见的默契:它们全部放弃了单一模型扫描,不约而同收敛到同一套三段式架构——一个代理负责寻找漏洞,第二个独立代理专门寻找证据推翻它,只有扛住反驳的幸存者才会进入打补丁环节。表面看这是四款同质化的竞品,但拆开底层工程逻辑就会发现,四家在开源开发框架与封闭终端产品、源码静态博弈与沙盒动态复现之间,已经走上了截然不同的两条路。
93% 误报倒逼架构收敛:让 AI 互搏取代单模型扫描
过去两年,AI 辅助编码普及,但用单个大模型直接扫描源码却成了安全团队的灾难。Google 安全团队在技术博客中给出过一个刺眼的行业基准:粗放的 AI 代码扫描会产生大量幻觉漏洞,真实阳性率低于 7%。一个报错率高达 93% 的扫描器,消耗的人工复核时间远超它节省的成本。
与此同时,攻击者已经在利用大模型自动挖掘并利用漏洞,防守方无法退回缓慢的人工审计。传统的静态应用安全测试(SAST)工具只认死板的语法规则,看不懂跨文件的复杂业务逻辑;单一 AI 模型又容易顺着自己的推理钻牛角尖。
四家厂商给出的共同解药是职责分离,直接把人类安全红队的背靠背审查搬进了多代理工作流。Cloudflare 在文档里写下了铁律:验证者绝不能是发现漏洞的同一个代理。
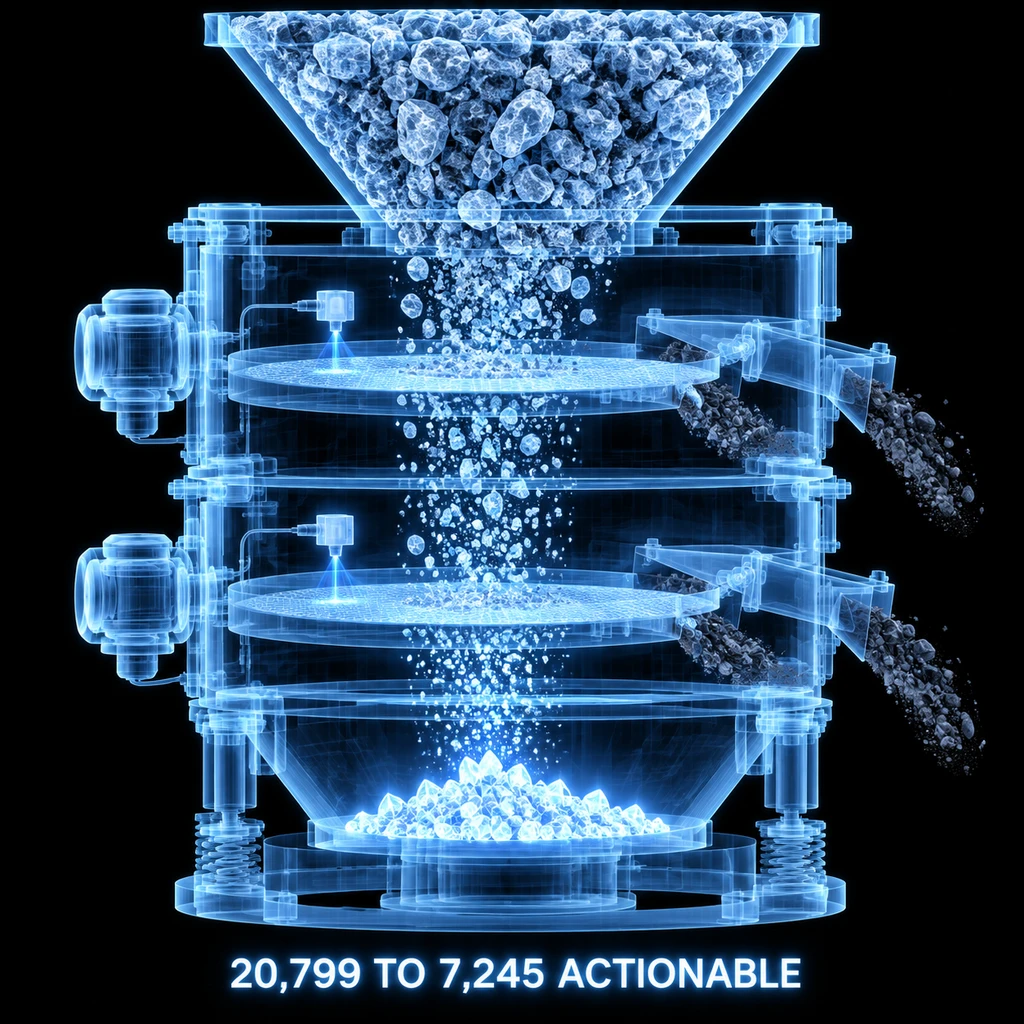
这种双盲对抗机制立竿见影。Cloudflare 披露的内部数据显示,其工具在扫描内部代码库时,发现阶段抓出了 20,799 个原始候选漏洞,经过独立代理反证后,只剩 12,057 个存活;再叠加跨模型交叉核验与去重,最终送到工程师手里的可操作漏洞降至 7,245 个,首轮拒收率从 40% 压到了 11%。
终端产品还是开源框架:四巨头走出两条商业路线
虽然底层都用上了多代理反证,但如果企业安全负责人把这四款工具放进同一张采购清单对比,就会掉进认知误区。它们根本不是同一维度的产物,而是分裂成了封闭终端产品与开源开发框架两个阵营。
Anthropic 和 OpenAI 卖的是开箱即用的终端产品,核心目的是绑定自家的模型消耗与开发入口。Claude Security 以插件形式直接塞进了 Claude Code 会话里,采用私有协议,仅限 Anthropic 生态内使用,扫描消耗直接计入用户的 Claude 订阅额度,托管版底层已迭代至 Claude Mythos 5。OpenAI 的 Codex Security 虽然把 CLI 和 TypeScript SDK 以 Apache-2.0 协议开源,支持接入 GitHub Actions 和私有部署,但背后的扫描引擎依然闭源,处于受限测试阶段,必须持有 OpenAI 等受控接口权限才能运转。
反观 Cloudflare 和 Google,它们交出的是完全开源的底层脚手架(Harness),不绑死任何特定模型,旨在让安全工程师自己动手搭流水线。Cloudflare 的 security-audit-skill 采用 MIT 协议开源,定义了完整的 6 阶段审计工作流,任何支持并发子代理的编码工具都能直接挂载,目前已在 GitHub 斩获 47.5K 星标。Google 的 Mantis 同样以 Apache-2.0 协议开放,还利用层级摘要树技术把代码上下文的词元开销砍掉了 85% 以上。
更深层的分歧在于怎么才算证明了漏洞。Anthropic 的路线侧重于对抗性源码审查,让不同角色的代理在代码文本层面辩论;而 Google Mantis 和 Cloudflare 则把标准拉到了工程实证——必须在隔离的沙盒环境中写出概念验证代码(PoC)、单元测试甚至拉起模拟服务器,亲手把漏洞触发出来。Cloudflare 的规则尤为严苛,如果运行环境没有配置操作系统级断网沙盒,所有线索只能停留在待验证状态,绝不升级为确凿漏洞。
代码安全正从寻找漏洞的概率游戏,变成编写复现代码的对抗工程。
选型避坑指南:算力账单、评测迷雾与人类最后防线
当企业准备把这些 AI 安全代理引入研发流水线时,真正棘手的往往不是模型聪不聪明,而是工程落地时的隐性成本与合规边界。
首先是评测基准的缺失。安全厂商 Aikido 发布的一份 89 个漏洞测试集数据显示,Claude Security 的覆盖率为 67%,Codex Security 为 65%。但这组数据来自安全厂商的单一测试,目前行业内依然缺乏第三方中立的统一公开基准。更值得警惕的是 Snyk 在自家基准测试中的发现:纯靠大模型审查找出的漏洞,有 49.7% 会在下一次运行时凭空消失。这就是为什么脱离了确定性验证引擎或沙盒复现,单纯对比覆盖率数字毫无意义。
其次是沙盒验证的算力与基建账单。静态源码互搏只消耗词元,而像 Mantis 或 Vercel Labs 的 deepsec 那样通过拉起并发沙盒来实证漏洞(Vercel 甚至会将扫描扇出到 1,000 个以上并发沙盒),计算成本与环境维护复杂度会成倍飙升。这也是 Google 专门给 Mantis 加上最大词元消耗上限参数的原因。
- 风险.切勿将自动生成补丁等同于无人值守修复,四大工具无一例外禁止 AI 自动提交或合并代码,所有补丁必须由人类工程师终审。
对于正在评估预算的技术团队,当下的行动路径其实很清晰:如果团队已经在重度使用 Claude Code,直接装上 Claude Security 插件是零边际搭建成本的起步方案;如果企业合规部门强依赖 GitHub 流水线门禁与 SARIF 标准报告导入,Codex Security 的工具链最为成熟;而对于拥有专职安全工程团队、拒绝被单一模型厂商锁定的大型机构,拿 Cloudflare 的 6 阶段技能搭配 Google Mantis 的沙盒复现逻辑自建流水线,才是长久之计。接下来最值得紧盯的变量,是各大平台能否超越各自为战的私有格式,开放一套统一的漏洞验证 API 标准,让发现代理与验证沙盒真正实现跨厂商解耦。