2026年11月13日,Anthropic交出了一份颇具反差感的故障报告(事件ID为nn11wk485zfn)。从09:58 UTC开始调查到11:05 UTC部署修复,整整67分钟里,大批用户被意外强制登出,遭遇OAuth登录失败、反复弹窗、聊天界面冻结乃至个人资料丢失。耐人寻味的是,底层接口Claude API(api.anthropic.com)全程显示正常运行。大模型底座毫发无损,把用户挡在门外的,仅仅是前端那把坏掉的“身份锁”。
67分钟的假性宕机与分裂的恢复表
先把这起事故的账算清楚:
- 波及范围.claude.ai网页端、开发者后台Claude Console(platform.claude.com)、编程工具Claude Code以及企业办公工具Claude Cowork四个核心组件同时报错。
- 核心病灶.用户登录认证(authentication)环节崩溃,并非底层推理算力枯竭。
- 修复分化.官方在11:05 UTC宣布部署修复并转入监控状态时,只有Claude Code和Console恢复正常,核心网页端claude.ai仍处于重大故障(major outage)状态,Claude Cowork则处于降级(degraded)状态。
- 信息留白.Anthropic在状态页里用一句笼统的“正在监控恢复”带过,既没交出根本原因(root cause),也未披露受影响的具体用户规模。
更隐蔽的麻烦藏在企业办公侧。Claude Cowork在11月13日的降级,实际上叠加了另一场始于11月12日17:52 UTC的先发故障。那场事故导致Microsoft 365的邮件、日历、搜索工具及Claude for Outlook全部中断,Anthropic将其归因于微软方面的连接器问题。这意味着企业用户实际上遭遇了跨平台连接器中断与自身认证崩溃的双重打击。
黑色72小时与巨头的传统IT软肋
如果只把视线停留在Anthropic一家,很容易觉得这只是一次偶然的运维失误。但把日历往前翻两天就会发现,整个AI行业在11月中旬经历了一场罕见的认证连环劫。
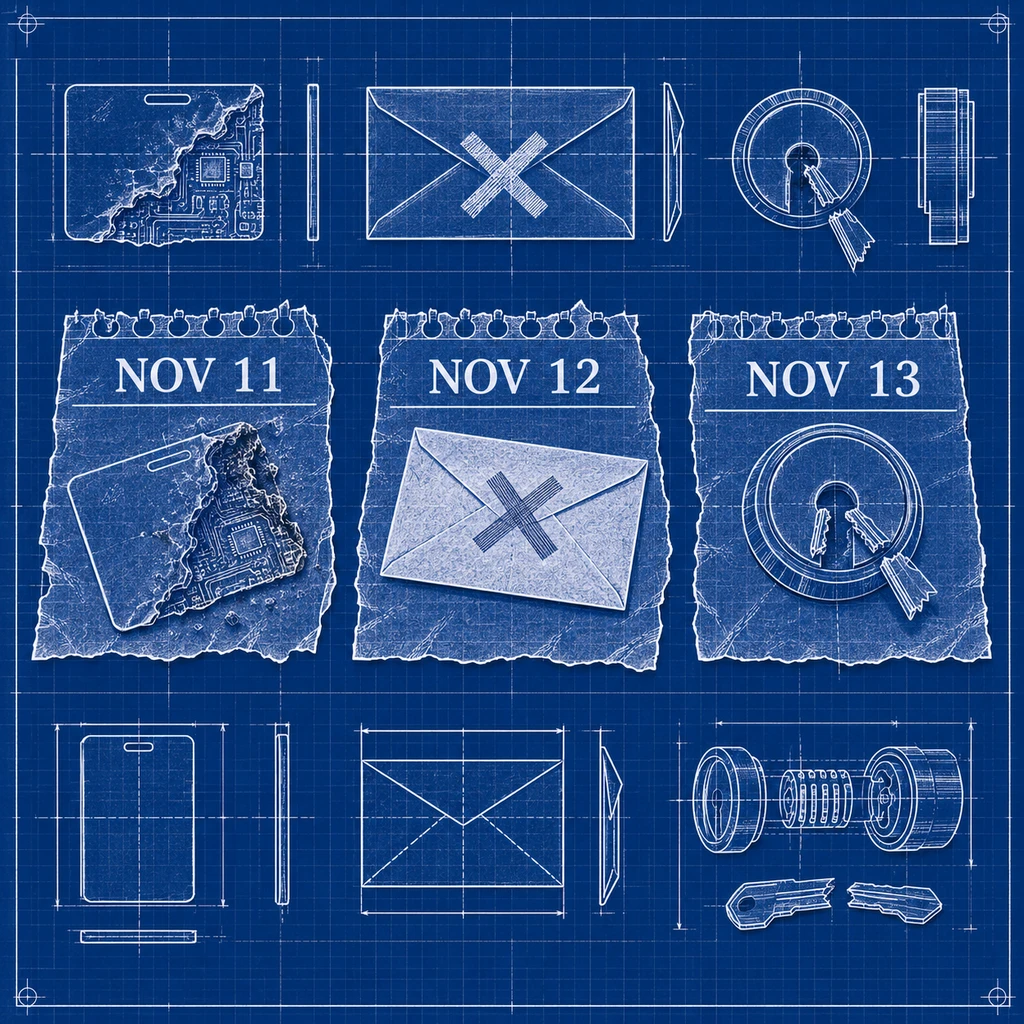
11月11日,OpenAI发生影响登录、注册、多项ChatGPT功能及API创建对话的故障,从调查到解决的更新跨度为9分钟。紧接着在11月12日19:36至21:43 UTC,GitHub因上游邮件服务商中断,导致部分用户无法登录、验证邮箱或重置密码,直接波及Copilot的正常访问。再加上11月13日Claude的认证崩溃,三大头部平台在短短72小时内,排着队在用户访问控制这个传统IT环节栽了跟头。
算上这次事故,Anthropic在11月中旬的故障记录已经相当密集:11月8日因模型错误导致Claude.ai、API、Code和Cowork中断14分钟(08:18至08:32 UTC),11月10日又发生一起持续4分钟的模型过载错误。但相比前两次实打实的模型故障,11日至13日这场行业集体的登录瘫痪,显然指向了另一个架构盲区。
大模型越往深处走,死穴越不在算力
为什么手握顶级算法团队的AI公司,会接二连三在“开门迎客”这件事上摔跤?
算力决定大模型的上限,但最脆弱的那根连接器决定了它的下限。
《韩非子》有言,千丈之堤,以蝼蚁之穴溃。早期的生成式AI只是一个独立的网页聊天框,系统可用性基本等同于GPU集群的推理算力。但今天,大模型正在变成深入软件工程(Claude Code)、企业办公流(Claude Cowork)和开发者后台的基础设施。一栋大楼里塞进了太多的房间,身份认证(Authentication)、API网关以及第三方生态连接器,就成了所有业务流必经的咽喉要道。
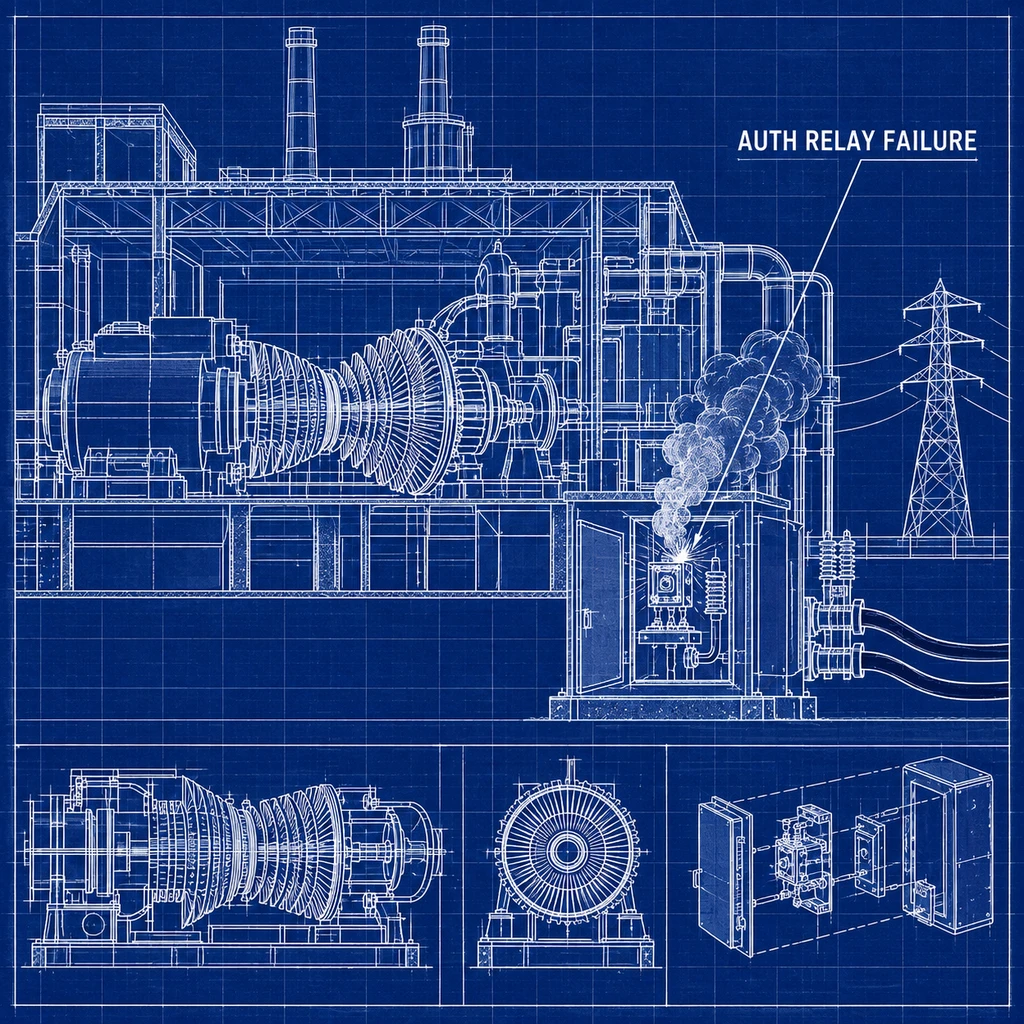
这很像百年前电力工业的演进。早期大家只关心发电机组的功率够不够大;等电网真正铺进工厂和千家万户,导致大面积停电的往往不再是发电厂停机,而是变电站里一个老化的继电器,或是跨区域并网时的通信授信失灵。当然,AI基础设施和传统电网不完全一样,软件生态的跨平台调用链条要隐蔽得多。
看看GitHub Copilot在10月28日的那场事故就能明白这种隐蔽性。当时因为用于向上游模型供应商进行身份验证的凭证无效(invalid credential),直接导致模型请求大面积失败,影响窗口长达92分钟,受影响模型的平均失败率达到9.73%。无论是Copilot的跨服务凭证失效、GitHub被上游邮件服务商拖累,还是Claude Cowork被微软M365连接器卡住脖子,都在说明同一件事:外围管道的脆弱性,已经超过模型过载,成为更频繁的宕机元凶。
- 提醒.切忌简单拿状态页的报错次数给Claude、ChatGPT和Copilot做可靠性排名,因为各家统计口径混杂了身份认证、模型推理与第三方设施故障(OpenAI就明确表示其可用性指标聚合了不同层级、模型和错误类型)。
同平台换模型失灵,容灾逻辑该改了
我更在意的是,这场认证危机直接废掉了许多技术团队现有的容灾手册。
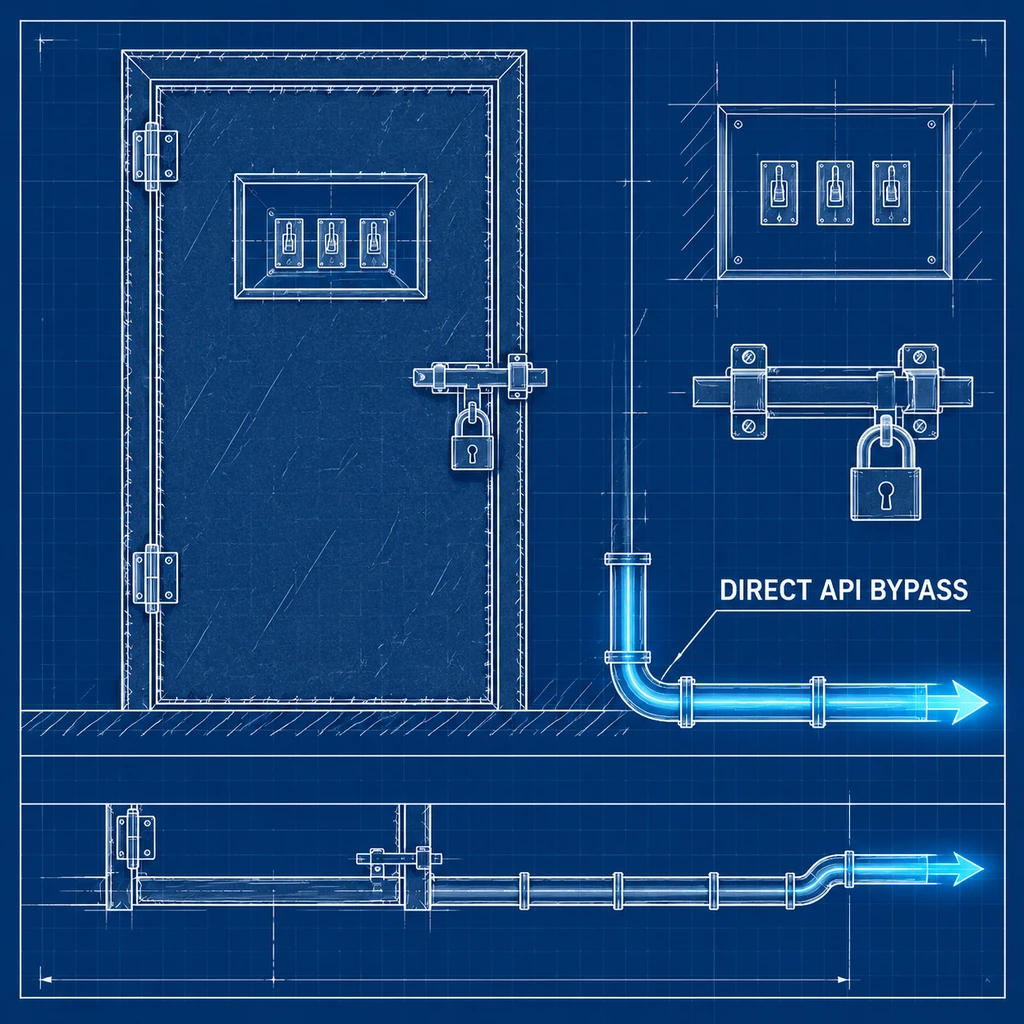
过去应对AI服务中断,行业里最流行的做法是“同平台切换模型”。比如在11月9日GitHub Copilot发生模型级故障时,官方给出的标准缓解建议就是在内部切换备用模型。这招在11月8日或10日那种单纯的模型过载事故里确实管用。
但在11月11日至13日的认证级故障面前,这套方案彻底失灵。当OAuth登录崩溃、账户体系把你踢出局时,你在Claude Code或网页端里根本连选模型的界面都进不去;当微软M365连接器中断时,换再聪明的模型也读不到一封邮件。
对于重度依赖AI的研发和办公团队,这次事件给出了一个极其现实的架构教训:把鸡蛋放在同一个前端应用里太危险了。本次故障中,直接集成底层Claude API的企业客户毫发无损,而依赖网页端和IDE插件的开发者则全面停摆。
- 建议.研发团队必须将日常工作流拆分为官方前端与独立API两条访问路径,并配置跨供应商的备用凭证,确保在单一平台大门锁死时,能直接通过底层接口逃生。
接下来真正需要紧盯的,是claude.ai何时能从“重大故障”真正转为“已解决”(Resolved),始于11月12日的Microsoft 365连接器故障何时彻底修复,以及Anthropic敢不敢交出那份迟到的认证崩溃底层原因报告。毕竟,发电厂造得再气派,总不能每次都让用户摸黑堵在变电站门口。