同样是喂给 ChatGPT 的网页,有的内容进门前就被整理成了高密度摘要,还直接排在提示词最前面;有的却只能切成零碎的原始文本,排在队伍末尾等模型挑拣。2026年10月27日,柏林初创公司 Peec AI 的生成式引擎优化(GEO)研究员 David Konitzny 扒开了这层底牌。他发现 OpenAI 配置的三个新闻引擎里,只有一个叫 labrador 的引擎会填充 provider 字段,顺藤摸瓜就能揪出 12 家出版商和旗下的 43 个域名。但这事如果只看成给签约媒体开后门,就太小看 AI 搜索对流量规则的改写了。
先把账面上的名单和机制过一遍:
- 核心名单.包括 Condé Nast、Hearst、Axel Springer、News Corp、Reuters 和 AP 等新闻集团,还塞进了 Allrecipes、Tom's Guide、Welt 等网站的食谱、评测与购买指南。
- 管道落差.ChatGPT 不会实时抓取这些合作方页面,而是直接接收预生成的摘要(pre-generated summaries),并置于所有常规网页结果之前;普通网站只能作为原始文本片段进入。
- 榜单截断.在 Konitzny 分析的 1,000 个案例里,一旦涉及排名列表,预生成摘要点名提及第 1 至 3 位条目的比例高达 70%,到了第 7 至 10 位直接摔到 23%。
预摘要漏斗砍掉了榜单后半截
我更在意的是 70% 与 23% 这组悬殊的数字。过去二十年做传统搜索引擎优化(SEO),品牌方和测评站有个默认共识,只要挤进谷歌首屏前十,或者在 Tom's Guide 的年度购买指南里混个第八名,总能分到一勺长尾汤喝。
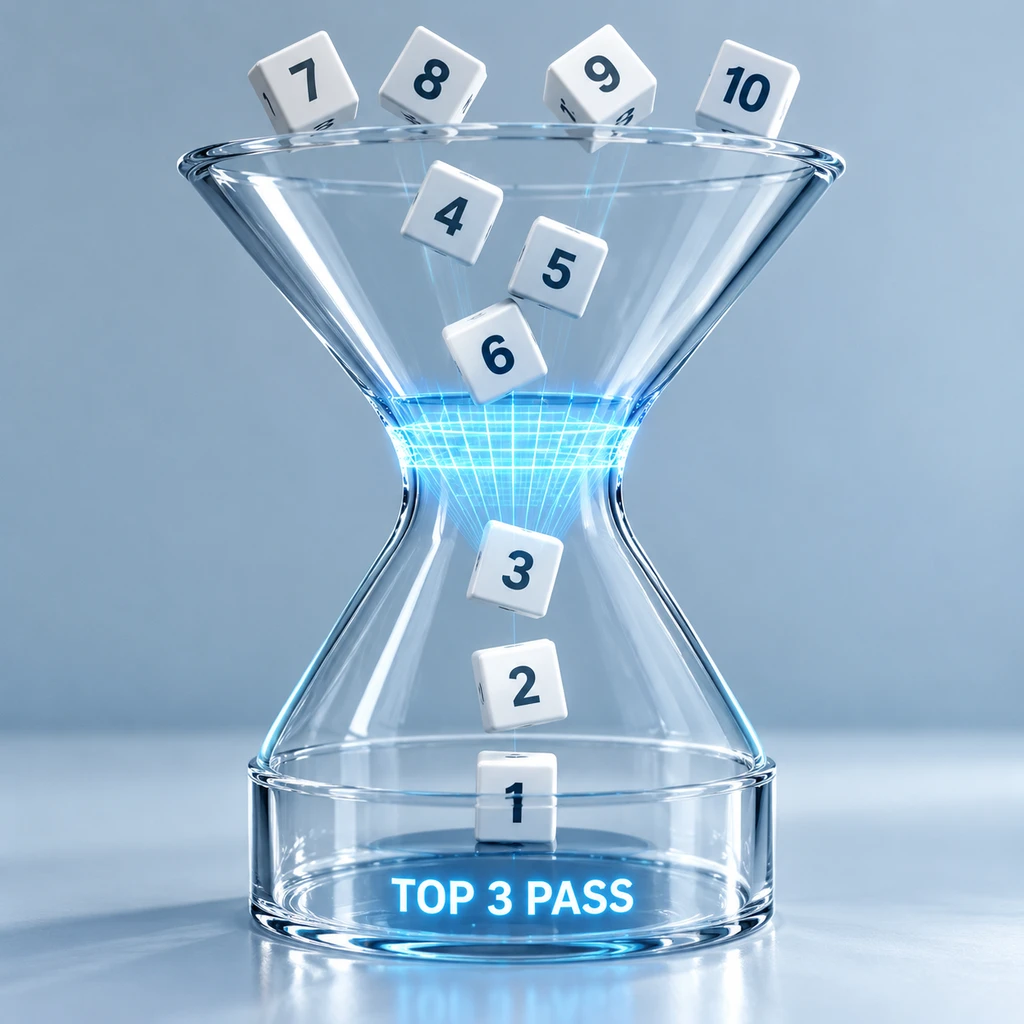
生成式引擎直接把锅给掀了。ChatGPT 在生成最终回答之前,先由底层的预摘要算法对长榜单做了一次剧烈的“二次过滤”。排名第 7 到第 10 位的商品或食谱,还没等到主模型开口说话,就已经在检索管道的预处理阶段被直接抹掉了。
流量生杀大权,已经从搜索结果页移交到了提示词截断处。
这就好比古代科举的“誊录”制度。考生卷子写得再好,如果负责抄卷的书吏在进呈主考官前嫌字多,直接把后半截裁了,主考官连看都看不到。对于依赖评测网站导流的消费品牌而言,进不了头部榜单前三,在 AI 搜索里就等于直接蒸发。
- 风险.依赖中腰部榜单排名的电商与消费品牌,在 AI 预摘要的截断机制下将面临严重的曝光归零风险。
专属 VIP 管道还是通用自建索引
如果顺着“交钱签协议就能进 VIP 通道”的逻辑往下骂,这事很容易写成一个经典的商业黑幕故事。毕竟 OpenAI 早在 2023年12月13日 就与 Axel Springer 签了大单,2024年5月22日 签下 News Corp,2024年10月31日 上线 ChatGPT search 时也大方承认同时使用第三方搜索商与合作伙伴直供内容,到了 2025年1月15日 与 Axios 的合作公告里,更是白纸黑字写明允许展示精选摘要和节选。
但技术实测却给这个单一的“钞能力叙事”泼了冷水。Peec AI 的 Tomek Rudzki 早在 2026年9月4日 发表的《ChatGPT built its own search index》一文中,就把 Labrador 定性为 OpenAI 的内部检索索引,并讨论了其中的 provider 标签。更直接的反证来自研究机构 RESONEO 的测量报告《What ChatGPT pulls, what it shows, what it cites》,他们发现数百个没有签署协议的媒体机构,同样获得了与合作伙伴一模一样的片段处理待遇。
另一位独立研究者 David McSweeney 在 QueryBurst 的调查中也观察到,部分主要出版商的检索载荷里确实出现了原文页面没有逐字对应的合成片段(synthesized snippets)。但他看得很克制,明确指出这究竟源于缓存、自建索引还是出版商直接推送尚属推测,生成模型到底怎么接收这些摘要也还没定论。
把这几块拼图凑齐就会发现,外界把 OpenAI 在 2024年7月25日 发布 SearchGPT 原型时说的“显著引用和链接出版商”(prominently citing and linking),误读成了给签约伙伴承诺搜索排名特权。Labrador 更像是 OpenAI 为高权重站点搭建的一套通用预缓存索引,签约巨头确实坐在头等舱,但没交保护费的几百家媒体也凭着权重混进了同一节车厢。
网页端与 API 割裂背后的动态博弈
即便挤进了这条高速管道,也不代表就能稳拿前端曝光。Peec AI 在方法论说明里特意划了一条线,他们的自动化交互测的是消费者网页端,而且严格区分了底层的“检索到的信源”与前端“最终展示的引用”。进了提示词,不等于能被模型正确署名,甚至连合作媒体自己都经常遭遇张冠李戴的错误引用。
真正拉开差距的地方在于不同入口的信源偏好。Tim Schatto-Eckrodt 等人撰写的预印本论文对比发现,签了授权协议的媒体在 ChatGPT 网页端露脸极多,而 API 端却更偏爱百科类和冷门信源。2025年11月9日 披露的汉堡大学研究数据更扎眼,他们在五周内收集了德语区新闻问题的超过 24,000 个回答,发现 Axel Springer 旗下的 welt.de 和 bild.de 合计占了网页端引用的约 13%,到了 API 引用里却暴跌到只有 2%。
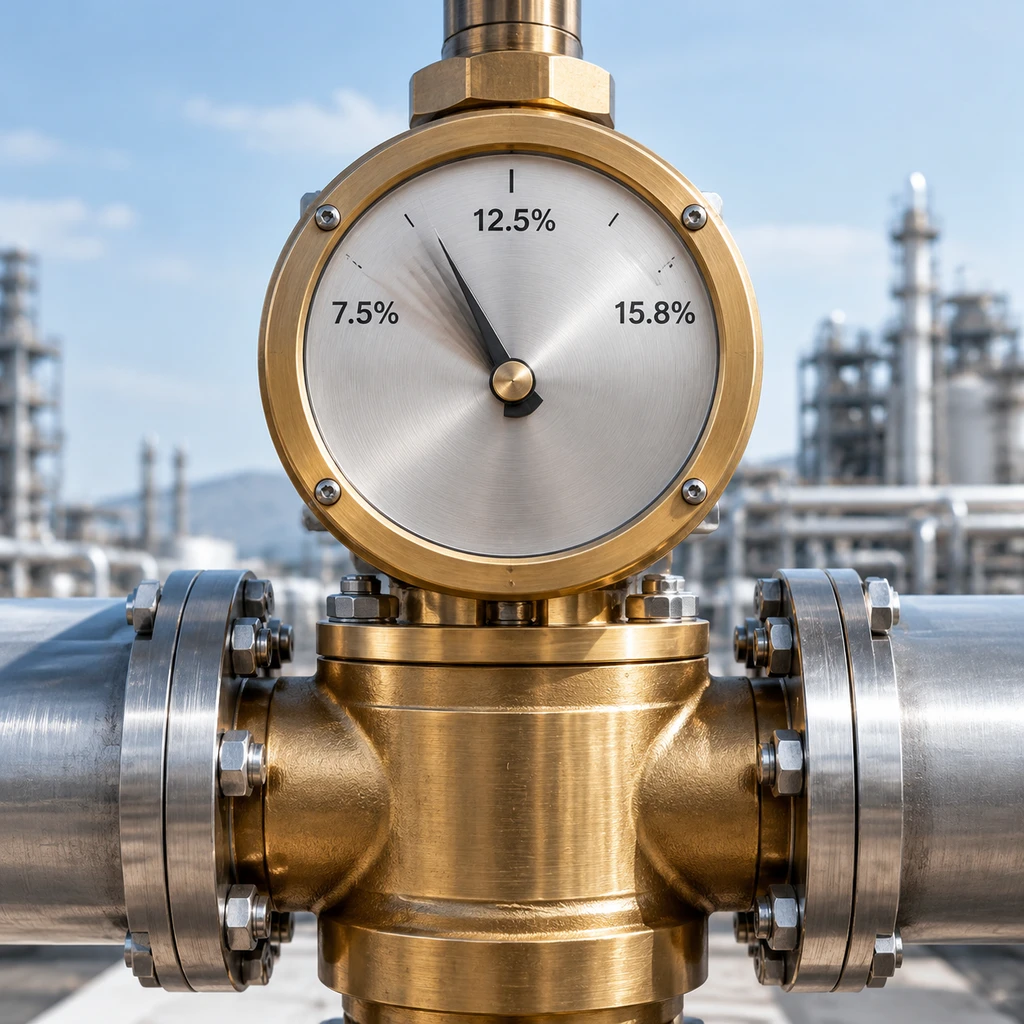
就算是网页端的优势,也不是铁板一块。Ahrefs 的监测报告显示,在 ChatGPT 引用最多的 200 个域名里,合作出版商的合计份额从 2026年3月 的 7.5% 一路猛涨到 7月 的 15.8%,但到了 9月下旬 又回落至 12.5%。
这就像二十世纪初的报业辛迪加与电报网。巨头们买下专线电报的优先发稿权,确实能比地方小报快一步印上头版,但最终读者买哪份报,还得受制于报童的叫卖路线和版面编辑的临时抽换。OpenAI 的检索黑盒既不是纯粹按合同排座次的功德箱,也绝非一视同仁的中立广场,而是一个在商业履约与算法调优之间反复摇摆的动态漏斗。
- 结论.与其焦虑有没有签下天价授权协议,内容方和品牌方更该盯紧自建索引的预摘要截断规则,以及网页端与 API 端截然不同的信源分发逻辑。
回到开头那条叫 labrador 的管道。当普通网页还在以原始文本碎屑的形态排队时,真正改写行业命运的,早已不是谁排在搜索结果第一页,而是谁能在进入大模型提示词之前,活过那场只留前三名的预摘要清洗。