把一份上百页的招股书或专利塞进视觉语言模型,显卡往往比人先崩溃。2026 年 10 月 27 日,百度在 GitHub 的 baidu/Unlimited-OCR 仓库正式发布 Unlimited OCR 2(又称 Unlimited OCR Works 2),代码采用 MIT 开源协议,模型权重同步上架 Hugging Face 的 baidu/Unlimited-OCR-2。这距离百度在 2026 年 6 月 22 日发布初代论文(arXiv:2606.23050,基于 R-SWA 机制、支持数十页与 32K 最大长度)刚好过去四个月。新版直接把目标钉死在百页级文档解析上,但细看它的底层机制与部署配置,你会发现:它用注意力裁剪驯服了解码显存,却在工程落地上做了一次相当现实的妥协。
512 Tokens 的账本与 10 页窗口的代价
传统视觉大模型一碰到几十上百页的 PDF,就会撞上三堵墙——KV Cache 显存随页数线性甚至平方级暴涨、跨页表格与段落断裂、生成退化陷入重复死循环。
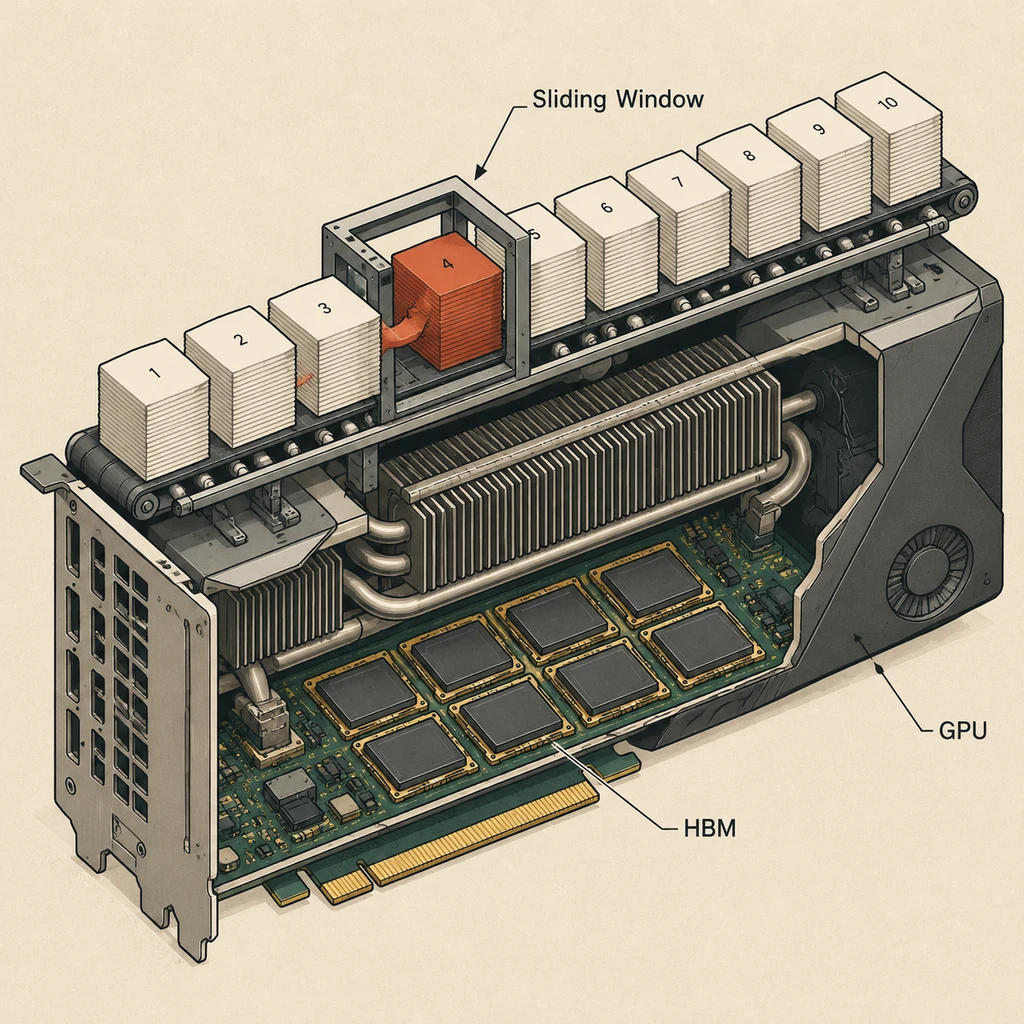
Unlimited OCR 2 的解法是把初代的 R-SWA 升级为稀疏参考滑动窗口注意力(SR-SWA)。模型不再死记硬背前面几十页的全部视觉和文本特征,而是只维护一个固定的工作参考集(例如 512 tokens)。无论文档翻到第 20 页还是第 100 页,每一步解码的延迟和显存占用都能保持近乎恒定。官方宣称它在数十页基准 MPDocBench 和百页级基准 MarathonDocBench 上拿到了最高分,不过公开的 README 里并没有直接放出具体跑分表格,技术报告还躺在 Git LFS 里。
账面上的数字很漂亮,但看开源项目不能只看论文摘要,得看它的部署脚本怎么写。
在官方给出的实际部署示例里,长文档并不是一口气塞进去的,而是按 10 页一个窗口(10-page windows)切开处理,同时复用前一个窗口的 KV 尾部来保持上下文衔接,公开测试环境直接用上了 80GB 显存的 A800 GPU。
解码步显存恒定,绝不等于端到端总显存便宜。
我不太买账的是把注意力裁剪包装成无限视野的宣传口径。在工程落地上,图像切片、高清页面缓冲和并发队列全都要吃内存;更棘手的是窗口大小的二选一难题:你如果为了省显存把 10 页窗口缩得更小,跨过第 10 页和第 11 页交界处的长表格与段落合并就会受损。早年 PC 内存不够时,程序员靠虚拟内存分页把大程序跑起来,代价是频繁换页时的卡顿与状态割裂;今天的百页 OCR 依然在给物理显存交同样的买路钱。
- 风险.把 10 页滑动窗口进一步调小虽能压低峰值显存,但会直接损伤跨窗口边界的段落衔接与跨页大表格合并精度。
同门 96.34 分珠玉在前,为什么还要另起炉灶
不少技术团队看到百度又发了一个文档大模型,第一反应是拿它去替换手里现有的解析管线。这恰恰踩进了“一个大模型通吃所有 PDF”的误区。
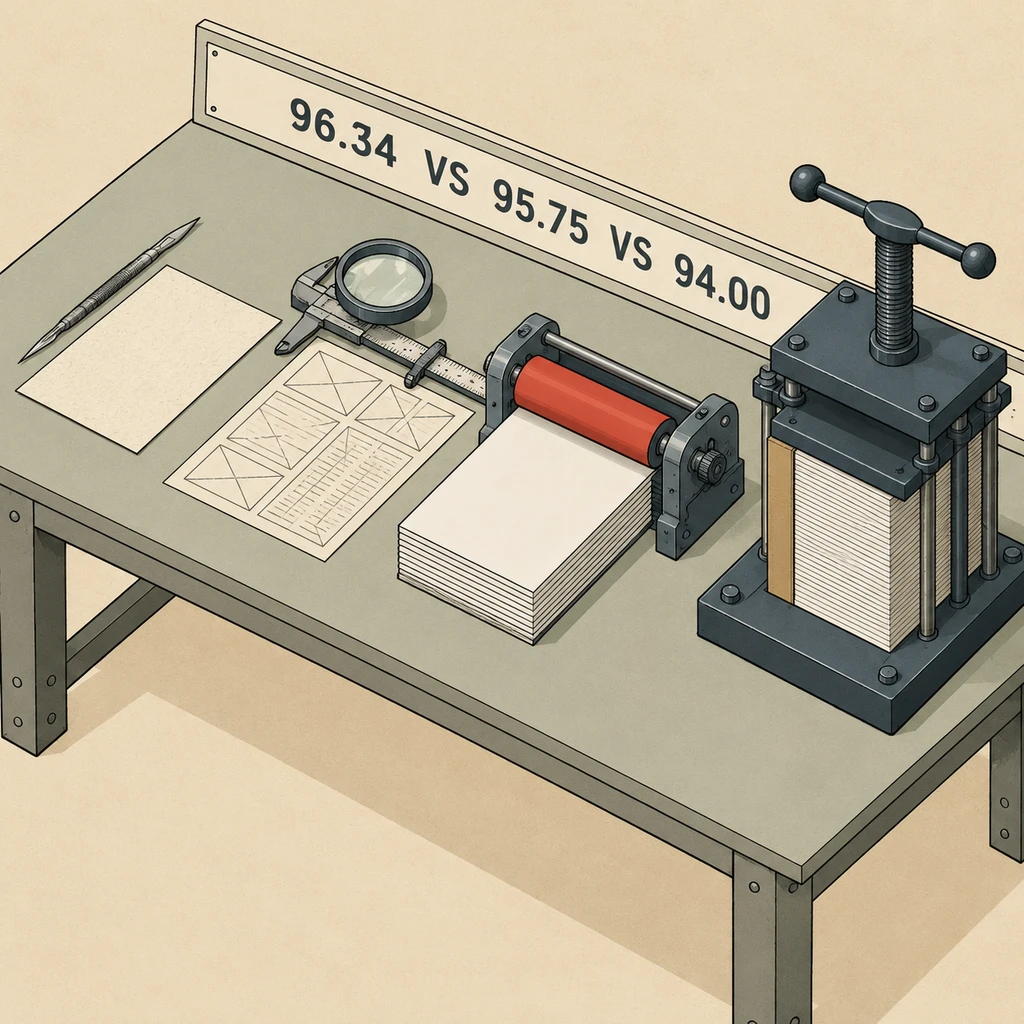
去翻一下公开基准 OmniDocBench 的 v1.6_full 综合解析榜单,你会看到一个很微妙的排位。百度自家的 PaddleOCR-VL-1.6(仅 0.9B 参数)拿到了 96.34 分,OpenDataLab 的 MinerU2.5-Pro(1.2B 参数,需 8GB+ 显存)拿到了 95.75 分,而初代 Unlimited-OCR 的得分是 94.00 分。
韩非子讲“一手独拍,虽疾无声”,技术工具的排兵布阵也是同理,单靠一个重型长窗口模型拍不响整条数据流水线。百度内部已经有 96.34 分的小钢炮 PaddleOCR-VL-1.6,之所以还要单独开源一条 Unlimited OCR 2 路线,是因为两者的主战场根本不在一个维度上。
| 解析工具 | 核心参数 / 资源门槛 | 最优适用场景 |
|---|---|---|
| PaddleOCR-VL-1.6 | 0.9B 参数 | 扫描件单页高精度还原与常规跨页表格合并 |
| MinerU2.5-Pro | 1.2B 参数 / 8GB+ 显存 | 多栏公式密集的复杂科研 PDF 解析 |
| IBM Docling | 轻量级原生解析 | 自带文本层的原生 PDF 低成本批量吞吐 |
| Unlimited OCR 2 | A800 (80GB) 官方测试级 | 招股书、长篇专利等百页级上下文连续重建 |
如果你的业务是每天清洗几万份自带文本层的普通办公 PDF,用 IBM 开源的 Docling 就够了;如果追求单页扫描件极限精度,0.9B 的同门师兄反而更轻更快。Unlimited OCR 2 的唯一不可替代性,在于把散落在几十页里的章节层级、跨页长表和上下文编号串成一棵完整的结构树。
进生产环境前,先查初代留下的三道旧伤
模型在基准测试上拿第一是一回事,放到企业知识库管线里昼夜不停地跑是另一回事。
我更在意的是初代版本在 GitHub Issue 和第三方实测里暴露出的那些工程暗礁。只要看看社区在初代上踩过的坑,你就知道验收 Unlimited OCR 2 时该往哪里使劲了:
- 生成死循环(Issue #84):2026 年 7 月 26 日有开发者反馈,模型在解析包含专利序列的文档时,会把序列错误转换成巨型 HTML 表格,直接触发逃逸重复拦截的生成死循环。
- 页分隔符丢失(Issue #107):2026 年 10 月 18 日的报告指出,无论在 Transformers 还是 vLLM 推理后端下,模型都会出现多页分隔符丢失或错位——对需要按页码做引用溯源的 RAG 系统来说,页码错位意味着检索出来的证据直接失效。
- 报错却返回成功码(Issue #103):2026 年 10 月 15 日暴露的脚本漏洞显示,当推理请求全部失败时,脚本依然可能返回代表成功的退出码,导致自动化流水线把空结果当成正常数据往下游传。
除了官方仓库的报障,第三方开发者 Omar Kamal Hosney 曾在 24GB 显存的 RTX 4090 上用 SGLang 实测过初代模型。在英文表格和学术排版上它的还原度确实漂亮,但一碰到 39 页的历史阿拉伯语扫描件,字符准确率就掉到了 60–80%,其中 10 页还莫名其妙混入了杂散的中日韩(CJK)字符,并伴随着 2 次生成死循环。
- 建议.企业团队在把 Unlimited OCR 2 接入生产管线前,务必拿 Issue #84 的长序列转 HTML 表和 Issue #107 的跨页分隔符做一次回归压测。
眼下外部还没有人拿出它在同硬件条件下与 PaddleOCR-VL-1.6、MinerU 2.5 的百页端到端独立横评。回看那份被百页招股书撑爆显存的报警日志,Unlimited OCR 2 确实递出了一把能切开长卷的快刀;但刀刃在跨过第 10 页窗口交界处时会不会卷刃,还得看社区第一波真实长表的复测结果。