开源AI阵营正在试图构筑一道新的安全防线,但它面对的现实却格外骨感。2026年9月17日,Baseten旗下的研究机构Base Labs宣布与Hugging Face及Goodfire达成开源权重模型安全合作,计划研发并发布一套贯穿训练与推理监控的安全方法。
这项合作直指开源生态最尴尬的伤疤。在Hugging Face平台上,目前已有超过6000个被消融安全护栏的模型公开流通。所谓消融(abliteration),就是攻击者直接对模型权重动手术,定向切除拒绝执行有害指令的特征方向。当原本在训练阶段费尽心力做好的对齐被几行代码抹去,开源模型的安全承诺便形同虚设。
三方拼图试图把黑盒拦截推进到白盒内省
传统的模型安全几乎全靠外置守卫。Meta为Llama生态构建了包括Llama Guard、Prompt Guard、CyberSecEval、Code Shield以及LlamaFirewall在内的庞大防御工具链,其本质是在输入和输出两端设卡拦截;OpenAI在发布开源权重模型gpt-oss前,则通过恶意对抗性微调验证生物与网络安全能力未突破高危阈值,并配套发布了开源策略推理分类器gpt-oss-safeguard。
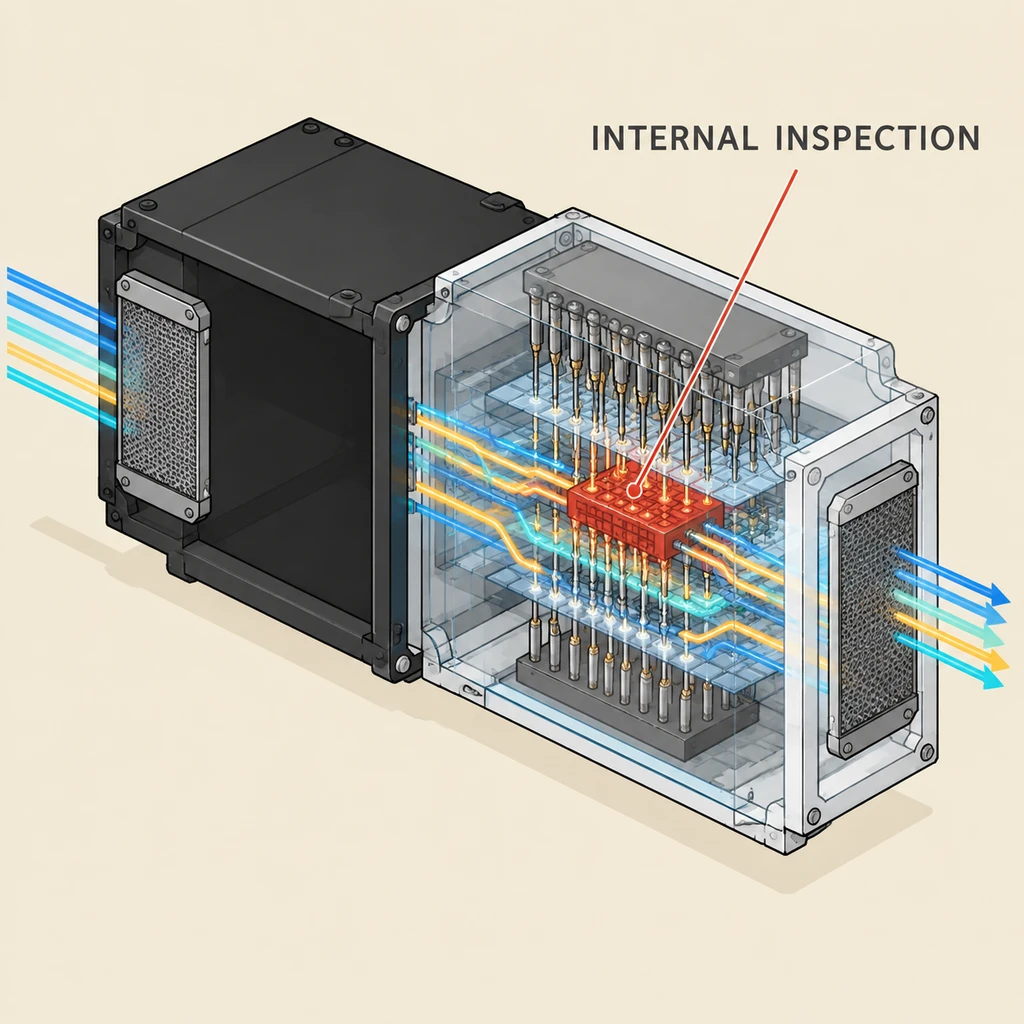
这类做法的问题在于,模型本身依然是个黑盒,守卫只看得到吐出来的字,看不到神经元内部正在酝酿什么。
Base Labs、Goodfire与Hugging Face的联盟,试图换一条路径。三家各自掏出了家底:估值达到130亿美元的推理服务商Baseten在2026年6月完成15亿美元融资,负责提供底层容器与工程部署;融得1.5亿美元的Goodfire主攻机制可解释性;Hugging Face则手握全球最活跃的开源模型分发网络。
技术路线上,Goodfire此前已经针对Llama 3.1、Llama 3.3以及DeepSeek R1发布了稀疏自编码器(SAE),验证了模型激活级特征引导技术,并尝试将内部表征作为训练奖励信号来抑制幻觉。与此同时,Base Labs此前在Qwen3-4B-Instruct上完成了宪法对齐实验,对比监督微调、强化学习与同策略自蒸馏,证明了密集同策略监督能在改善模型分布外表现的同时,不推高良性查询的过度拒绝率。这套逻辑的吸引力在于,安全不再是模型外贴的膏药,而是试图织进推理激活的纹理之中。
纸面规范与工程现实之间的巨大沟壑
愿景听起来很完整,但只要把镜头推近,就会发现目前的合作依然停留在概念倡议期。截至2026年9月17日,该联盟尚未发布任何具体的技术规范、评估测试集、基准跑分、威胁模型或明确的发布安全阈值。
更严峻的是,在可解释性赛道上,他们并不是走在最前面的探索者。Anthropic在机制可解释性上已经推进到了电路追踪与非输出隐式思维检测,并开源了支持主流开源权重模型的电路追踪工具。相比之下,Goodfire与Base Labs的白盒方案仍面临学界的核心拷问:模型内部激活特征与最终的安全输出之间,是否存在真正稳固的因果关系?一旦遭遇专门设计的自适应对抗攻击,特征层面的监控是否会被轻易欺骗?
与此同时,评估体系的公信力也是硬伤。Hugging Face自身推行过Community Evals与Evaluation Cards机制,其前期研究明确指出,当前绝大多数公开发布的模型评测因缺失关键元数据而无法独立复现。如果一套安全标准连基准数据的复现条件都无法满足,行业很难将其作为严肃的生产采纳依据。
- 风险.若白盒监控导致推理延迟成倍增加,企业级客户在实际部署时往往会优先关闭安全插桩,让标准在落地环节彻底空转。
无法规避的物理消融悖论
即便这套机制在技术上完全跑通,开源权重本身还有一个无法绕开的逻辑死穴:物理控制权的转移。
权重只要交付到本地服务器,安全契约的主动权就彻底易手。
闭源大模型可以通过云端API严防死守,切断异常请求。但开源模型不同,用户拿到的是数十GB的浮点数矩阵。无论上游训练时设计了多么严密的内部特征约束,只要下游开发者拉取权重,利用几张显卡进行对抗性后训练,或者直接通过数学计算定位并消融拒绝层,那些精巧的安全设定就会被直接抹去。
三方联盟提出的标准很难回答一个根本问题:当本地部署者把监控代码整段注释掉,或者使用纯裸权重运行时,这套安全体系要靠什么生效?
- 结论.开源模型安全不能停留在“防君子不防黑客”的口号式结盟,唯有拿出经得起对抗微调检验的硬核实证,新标准才具备立足的可能。