联合国统计机构正在做出一场迟来但激进的妥协。2026年9月17日,联合国宣布与谷歌合作上线全新数据平台 UN System Data Commons,正式替代服役多年的旧版 UNData 门户,并全面接入由模型上下文协议支持的自动化调用接口。这意味着全球范围内的自动化程序与大模型智能体,第一次能够通过自然语言直接调取跨机构的国际多边统计数据。
促成这一转向的直接推力,是一份令人难堪的基准测试。联合国儿童基金会披露的最新研究显示,主流大模型回答全球发展指标时的平均准确率仅有 21.2%,约六成回答无法给出可用数字;即便面对同一问题,两天后重新测试的数字一致率也只有约一半。当决策者和公众日益习惯向对话机器人索取数据,官方权威数据如果无法被算法解析,就会被大模型生成的幻觉全面挤压。
替换老旧的 UNData,联合国把数据喂到大模型嘴边
长期以来,联合国系统的权威统计更像是一座高门槛的专业堡垒。旧版 UNData 门户主要依赖欧洲统计局主导的 SDMX 标准构建。这种格式有着极其严谨的代码列表和元数据定义,但在结构上晦涩笨重,对大众和自动化程序极不友好。与此同时,联合国儿童基金会网站来自 ChatGPT 引用链接的访问量在今年同比激增 67%,各类智能体助手已经占到其总访问量的近一成。公众的检索习惯已经彻底迁移,官方系统却依旧停留在传统数据库的表单时代。
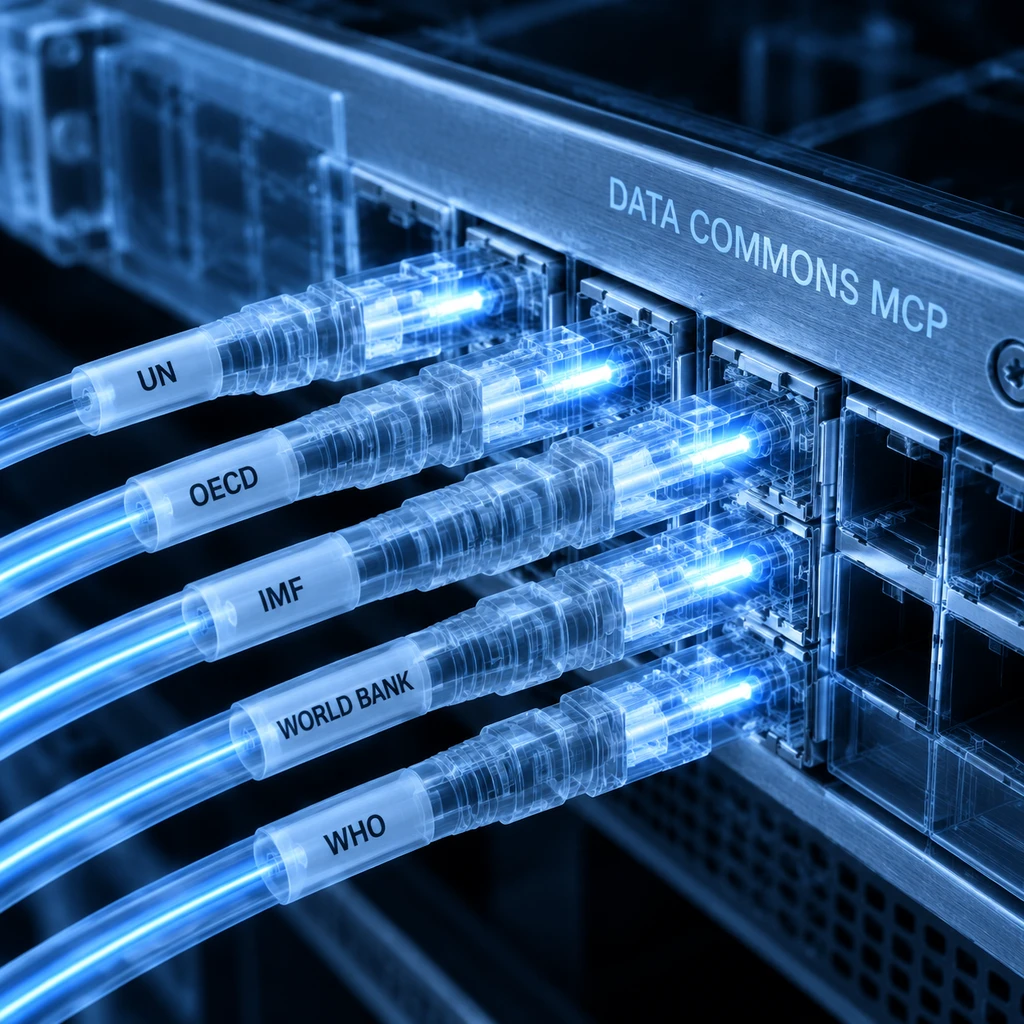
为了打破这种脱节,联合国拉来了自 2018 年起就在搭建公共数据知识图谱的谷歌。本次合作部署在联合国治理的实例上,由谷歌慈善机构提供 200 万美元能力建设资金与技术支持,日后交由联合国团队独立运维。启动初期已有 26 个联合国实体承诺加入,近 20 个机构的数据直接上线,联合国的目标是到 2027 年接入 80% 的统计数据集。这里设定的八成目标特指联合国自身统计集的整合进度,绝不能与此前多边会议中所谓八成发展指标偏离轨道的政策研判混为一谈。
从技术脉络来看,这并非一次仓促的公关联姻。从 2023 年秋季推出面向可持续发展目标的原型,到 2024 年联合国际计算中心拓展机构,再到 2025 年秋季上线核心服务协议,双方用了三年时间把底层知识图谱逐步铺设成型。通过标准化接口,智能体如今可以在几秒钟内整合跨国别、跨维度的复合指标并自动绘制图表,不再需要研究人员手动从十几个分散数据库中清洗搬运。
21.2% 的准确率背后,语义检索抹不平统计学口径
那份测出 21.2% 准确率的研究,成了联合国加速技术转型的最好注脚。测试覆盖了包括 GPT-4o、GPT-4o-mini、Claude Sonnet 4.5、Haiku 4.5 以及 Gemini 2.5 Flash 和 Gemini 2.0 Flash 在内的多款主力模型。然而,审视这串数字时必须保持审慎:它出自联合国儿童基金会一篇正准备提交学术期刊的工作论文,尚未经过同行评审。由于测试所用的提示词模板、浮点数容差判定标准、模型接口快照以及测试代码目前均未开源,外界尚无法对各家模型的具体得分展开学术层面的交叉验证。
更深层次的隐患在于,把异构统计数据翻译为自然语言图谱,本身就是一把双刃剑。
抹平元数据的语义便利,往往掩盖了统计学赖以立足的口径深渊。
在标准的 SDMX 框架下,联合国儿童基金会公开发布的官方开发包要求严密记录指标代码、访问日期以及数据快照版本。严肃的政策分析不仅需要一个数字,还需要知道这个数字是基于抽样调查、数学模型估算,还是成员国直接上报的原始实测值。但谷歌平台的设计理念是优先解决可访问性,将复杂的统计元数据扁平化映射为通用实体。这种改造极大地解放了大模型的语义初筛能力,却把至关重要的分母口径与误差范围剥离到了视线之外。
- 风险.谷歌官方明确声明平台无法确保底层数据的准确性,各数据源刷新节奏并不一致,且不承诺任何系统可用性保证。
如果直接依赖模型协议抓取的数据做决策,极易掉入权威失真的陷阱。以宏观经济研究中广泛使用的世界银行发展指标数据库为例,其系统包含近 1.6 万个时间序列,但世界银行官方特别警示,其自带的可持续发展标签数据集并非联合国官方监测指标;在国际法意义上唯一具有法定基准效力的,是由各专门托管机构直接呈交的联合国官方接口。一旦智能体缺乏对统计权威链条的识别机制,看似来自联合国的漂亮图表,其底层逻辑可能早已南辕北辙。
依赖巨头搭建底座,政策决策需要双层验证管道
让一家商业科技巨头深入联合国统计神经中枢,其象征意义远超 200 万美元的资助本身。在技术实现上,目前的模型上下文协议依然存在明确边界:它不仅需要接口身份凭证,目前也尚不支持非地理实体探索、突发事件关联或直接输出结构化图表。更根本的考量在于数字主权,当多边国际组织的权威数字资产与硅谷头部公司的开源事实标准深度绑定,国际公共产品的中立性需要依靠更严格的架构审计来维系。
对于正在将大模型引入严肃研究的智库学者与政策分析师而言,使用这一系统的前提是建立清醒的防御性姿态。
- 建议.摒弃直接依赖单一自然语言协议输出报告的做法,在工程端建立双层调用机制:以前端协议做广义发现,以官方底层标准做证据固化。
科研复现与政策审计天然排斥动态漂移的知识图谱。一旦底层统计机构在无明确版本提示的情况下修正历史序列,自动生成的政策结论就会彻底丧失回溯依据。大模型确实需要一把读懂官方统计的钥匙,但给它一本字典,并不意味着它写出的文章天然具备法律与科学效力。在联合国的权威公信力与算法的便利诱惑之间,人工核验依然是那道不能失守的闸门。