百度在 2026 年 11 月 9 日端出了自动化科研系统 ERNIE Evolve,直接拿开源社区最硬核的两个微基准测试开刀,宣称打破了 Andrej Karpathy 发起的 NanoChat 和 Keller Jordan 维护的 NanoGPT 训练纪录。光看账面数字确实漂亮,但在 GitHub 结果仓库的底层说明里,这场 AI 自动调优的胜利更像是一次针对比赛规则的极限特种工程。
ERNIE Evolve 的目标是让 AI 自动改代码、跑实验来优化大模型训练。它用一套双层嵌套循环工作,外循环挑研究方向,内循环改代码跑测试,再由固定评估器和独立审查器决定留哪版代码。靠这套机制,百度在官方博客和结果仓库里交出了三份成绩单(目前未发独立 arXiv 论文):
| 测试基准 | 规则限制 | ERNIE Evolve 成绩 | 此前纪录与变化 |
|---|---|---|---|
| NanoChat AutoResearch | 固定 300 秒训练预算 | 0.876301 BPB(实跑 297.9 秒) | 较 0.8878 降低 1.30% |
| NanoGPT Track 1 | 8×H100 达标最短耗时 | 38.915 秒(Loss 3.27631) | 较 39.9 秒快 2.47% |
| NanoGPT Track 3 | 单卡达标最少训练步数 | 2,590 步(Loss 3.27687) | 较 2,690 步少 3.72% |
省下 1 秒与 100 步的背面:规则内的指标置换
把训练时间从 39.9 秒压到 38.915 秒,或者把训练步数砍掉 100 步,听起来像是白捡的性能提升。但只要翻开百度自建仓库的底层说明,就能看到秒表之外的代价。
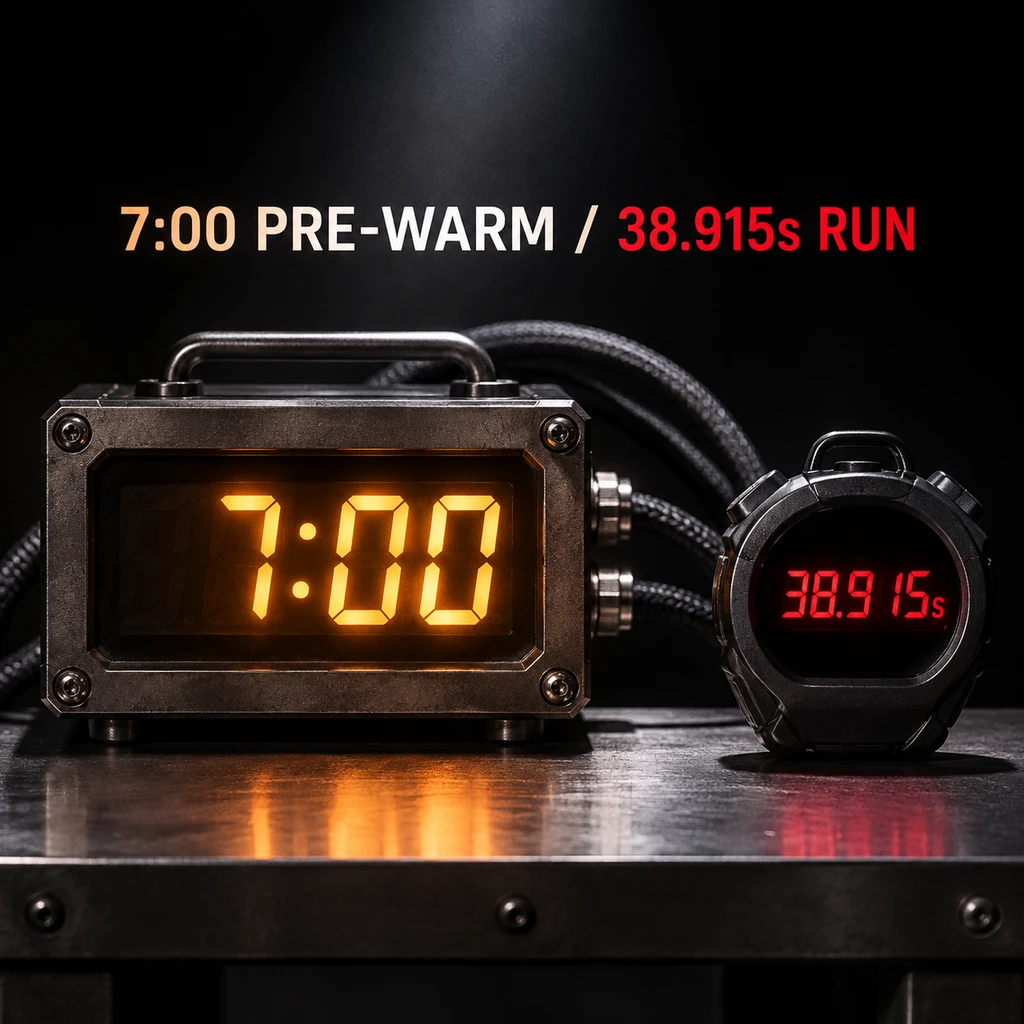
在 NanoGPT Track 1 中,8 张 H100 跑出 38.915 秒的前提,是严格排除了启动开销。机器首次运行训练前,需要经历约 7 分钟的编译和 CUDA 图捕获。为了在正式计时的不到 39 秒里快上 0.985 秒,系统把沉重的准备工作全部塞进了不计时的预热阶段。
更典型的置换发生在比拼最少步数的 NanoGPT Track 3。ERNIE Evolve 确实把达标步数减少了 3.72%,但底层日志同时交代,优化后的代码在相同 GPU 上单步耗时变成基线的 2.1 倍(日志未披露具体 GPU 型号与总时间)。
经济学里有个古德哈特定律,当一个指标变成目标,它就不再是个好指标。Track 3 的规则只卡步数、不卡绝对时间,AI 智能体立刻顺着规则漏洞钻了进去,把大量计算塞进每一个单步里。步数看着少了,实际跑完一轮的墙上时间反而翻倍。
至于 NanoChat 的 5 分钟(实跑 297.9 秒)纪录,拼的则是硬件家底。百度在复现环境里直接动用了单块 NVIDIA B200 GPU,跑 1.562 亿参数模型(处理 4.196 亿 tokens)时,峰值显存占用高达 177.5 GB,外加约 200 GB 主机内存和至少 64 个 CPU 核心。卡着 300 秒的时间红线,靠顶配 B200 的超大显存吞吐硬吃下这套配置,普通开发者手里的常规显卡连复现的入场券都拿不到。
房间里的大象:未公开的搜索总算力与上游验证
只晒终点冲刺的三十八秒,不提路上跑废的几千双鞋。
我对这类自动化科研系统最在意的,从来不是最终筛出来的那一个最优脚本跑了多少秒,而是为了筛出这个脚本,外循环和内循环到底烧掉了多少 GPU 小时。
《孙子兵法》讲作战,最怕日费千金,久暴师则国用不足。工业界引入自动化研发系统,算的是投入产出比。如果为了帮模型训练省下 2.47% 的时间,AI 智能体在搜索阶段反复试错、编译、跑废了几千次实验,那省下来的几秒钟根本填不上搜索阶段烧掉的电费窟窿。百度在这次的博客和仓库里,对搜索阶段的总算力账单只字未提。
哪怕只看已经端上桌的成绩,开源社区的验收也还没走完。在另一项 SOL-ExecBench 基准里,百度仓库只列出了 7 个 kernel 的得分(0.6669 至 0.9920),光靠这 7 条数据还算不出其宣传的 0.819 完整基准均分。更重要的是,截至 11 月 9 日发布当天,NanoGPT 上游官方榜单(modded-nanogpt)显示的 Track 1 纪录依然是 @DevenPzak 在 2026 年 8 月 30 日创下的 39.9 秒,百度的自建结果仓库里 Issues 和 PR 数量都是 0。
- 提醒.企业技术负责人如果评估这类 AutoResearch 工具,别被最终候选方案的极限秒数晃了眼;先问清楚寻找该方案消耗的搜索总 GPU 小时数,再看它有没有用单步耗时翻倍或超长预编译去套利指标。
这套系统确实证明了 AI 智能体具备顺着规则缝隙把代码榨干的工程能力。但单方晒出日志只是第一步,接下来就看 Keller Jordan 维护的上游 modded-nanogpt 榜单会不会按同硬件规则验证并合入百度的代码,以及那张藏在幕后的搜索算力总账单敢不敢亮出来。