2026年10月27日,Axiom Math 扔出了一颗数学与 AI 交叉领域的重磅炸弹。他们联合 31 位数学家与工程师,在 24 天内用 4310 万行 Lean 代码,完成了数学史上最庞杂的工程——有限单群分类定理(CFSG,俗称巨大定理)的第一代证明形式化。更戏剧性的是,AI 智能体在死磕逻辑细节时,顺手揪出了 1986 年一篇经典群论论文里的反例,团队不得不当场换路,写出一篇 35 页的新论文把窟窿补上。
搜这个项目的读者最需要看清三个核心事实:
- 干了什么.将散布于 715 篇文献、原本上万页的有限单群分类定理,彻底转化为 205 万个经 Lean 4 内核严格检查的形式化声明,代码开源于 GitHub(AxiomMath/CFSG)。
- 比前人快多少.2012 年 Georges Gonthier 团队用 Coq 形式化奇数阶定理(仅是通往 CFSG 的一块基石),耗时 6 年、写下 15 万行代码;如今 Axiom Math 靠人类画蓝图加 AI 暴力填空,把代码规模推高两个数量级,时间却压缩到了三周多,且全量编译控制在 24 小时以内。
- 卡点在哪.仓库虽然做到了零未完成证明(sorry_count: 0),但目前处于自评状态;机器能保证 4310 万行推导一步不错,却无法自证最顶层的数学定义有没有被写歪。
24天写完4310万行代码,机器顺手抓出40年前的幽灵
有限单群分类定理旨在证明每个有限单群要么是素数阶循环群、至少 5 个点的交错群、李型群,要么是 26 个散在单群之一。这一定理的第一代证明由约百位数学家历时数十年拼凑而成,因战线极长且历史勘误频出,一直被视为形式化数学遥不可及的终极圣杯。群论学家 Peter Cameron 曾在 2013 年估算,CFSG 的证明规模比奇数阶定理大一到两个数量级,按当年的人力速度,这几乎是愚公移山。
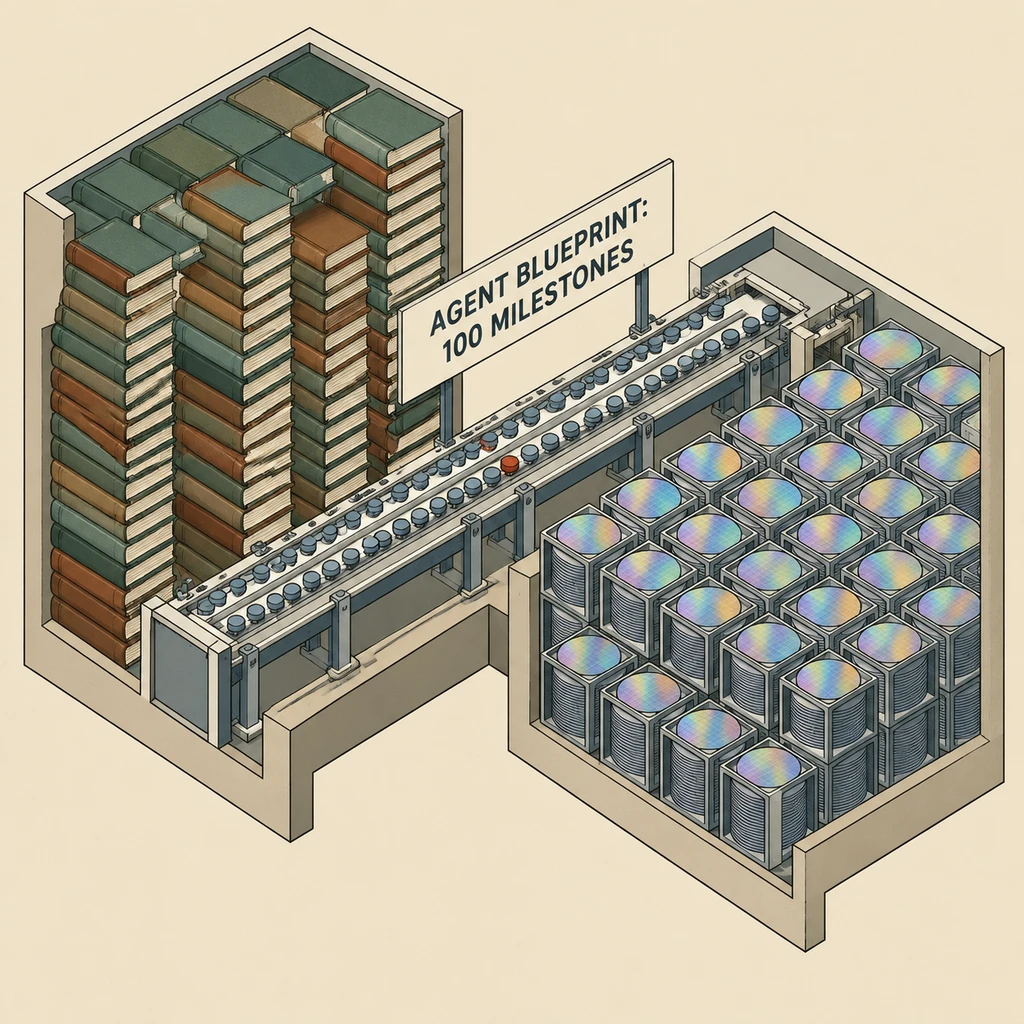
Axiom Math 这次直接掀了桌子。首席研究员 Letong Hong 与核心贡献者 Dean Cureton、Vasily Ilin、Bhavik Mehta、Niels Voss、Ken Ono 等人采用了一套流水线打法,由人类数学家拆解出 100 个里程碑,制定初始的智能体蓝图(Agent Blueprint),随后放出包括 AxiomProver 在内的 AI 智能体大军,去暴力填补底层的形式化细节。仅“特征 2 型”与“分支型”两个核心分支,AI 就吞吐了超过 4000 万行 Lean 代码。
真正的惊喜发生在机器啃硬骨头的中途。当形式化推进到“不平衡群定理(Unbalanced Group Theorem)”时,Lean 的内核死活过不去了。团队顺着报错摸查,发现问题不在于代码,而在于人类发表的原始文献有漏洞。
具体而言,Walter 在 1986 年发表的论文(Part II, Proposition 5.9(ii))中给出了一个闭包断言:在排除了 $q=9$、费马素数和梅森素数的特定群族 $\mathcal{L}_0$ 中,相关运算应当保持封闭。但形式化检验无情地撞出了三个反例——$\mathrm{PSL}_2(49)$、$\mathrm{PSL}_2(81)$ 和 $\mathrm{PSL}_2(289)$ 在二阶域自同构(外自同构)中心化子的作用下,会直接逃逸出 $\mathcal{L}_0$,衍生出被明令排除的分支 $\mathrm{PSL}_2(7)$、$\mathrm{PSL}_2(9)$ 和 $\mathrm{PSL}_2(17)$。
人类的直觉允许在纸面上写一句“易证”滑过去,但 Lean 的类型检查器是一堵铜墙铁壁。为了绕开这个死胡同,团队没有停下等待群论学界开会,而是调头搬出 Solomon 1976 年的极大 2-分支理论,以保持单群顶(preservation of simple tops)为核心重写了单群情形的替代证法,顺带在 Hexagon 平台上发了一篇 35 页的纯数学新论文(2610.00575)。
零 sorry 背后的审题死穴
看完前面的狂飙突进,很容易产生一种“AI 已经彻底接管纯数学”的错觉。但如果扒开 AxiomMath/CFSG 仓库底层的元数据文件 formalization.yaml,你会看到一个极其克制却关键的标签:自评(self-assessed)。
在形式化验证的规矩里,内核通过绝不等于大功告成。诚然,这个仓库的数据干净得吓人:基于 Lean 4.35.0-rc3 构建,未完成的证明(sorry_count)为 0,定义中的跳步(sorry_in_definitions)为 0,没有动用存在安全隐患的 native_decide 指令,全库仅依赖 Classical.choice、propext 和 Quot.sound 三个标准经典公理。经过 Lake 构建工具的深度优化,这 4310 万行巨无霸代码甚至能在 24 小时内跑完全量编译。
机器能担保四千万行推导不越雷池,却无法担保人类没把考题抄错。
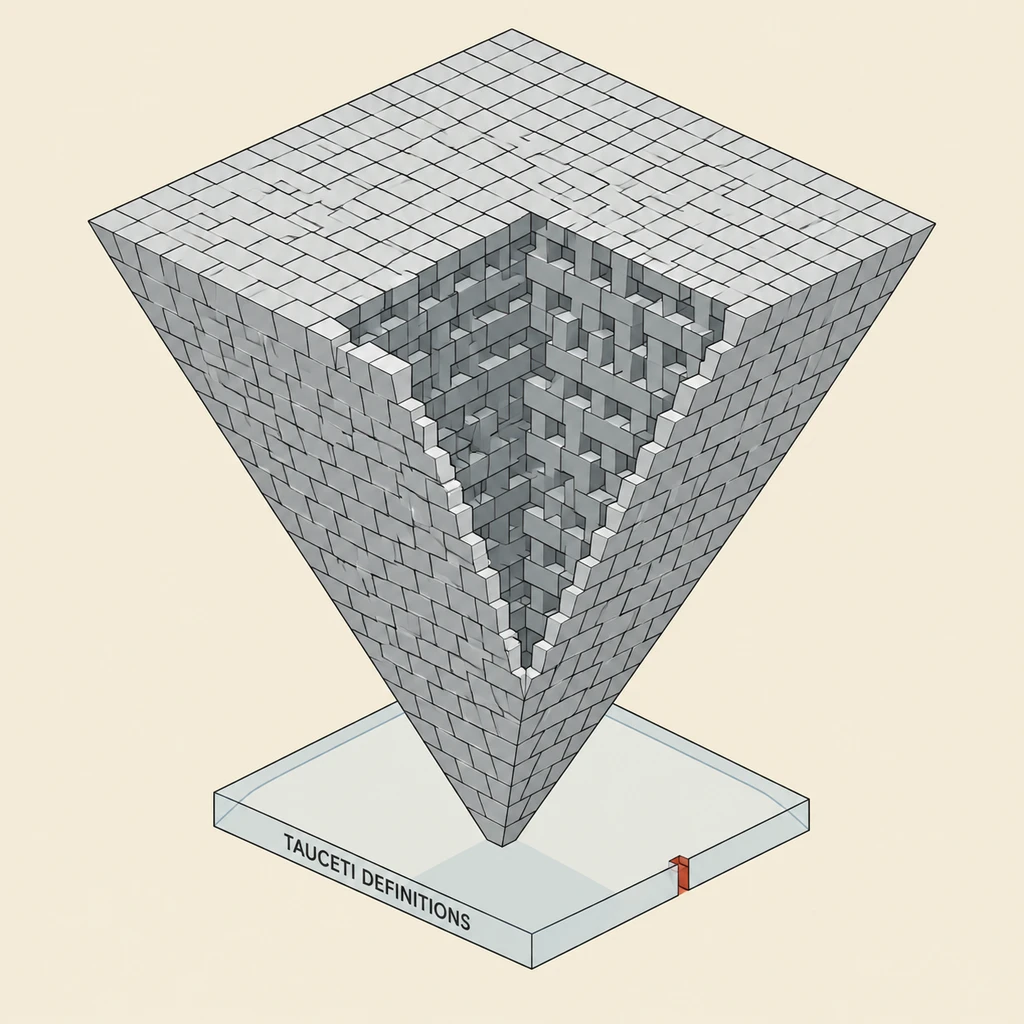
这正是整个事件最微妙的转折点。形式化证明的链条里藏着一个无法靠算力消解的不对称性:中间的 205 万个引理和声明,哪怕写得再绕、再冗余,只要 Lean 内核放行,它们在逻辑上就是铁板钉钉的真命题;但位于金字塔尖的那个最终主定理,以及支撑它的底层数学定义,必须由人类肉眼逐字审计。
在 AxiomMath/CFSG 仓库中,最终主定理位于 Comparator/Solution.lean 下的 CFSGComparator.classification,其定理陈述直接引用自一个名为 TauCeti 的外部独立库(TauCeti.ClassificationStatement.{u})。这么设计正是为了把“答题过程”与“考卷题目”物理隔离。
问题在于,要陈述有限单群分类定理,你得先在 TauCeti 里把素数阶循环群、交错群、16 个无穷系列的李型群以及 26 个散在单群(包括构造极其繁琐的魔群 Monster)全部用代码严格定义出来。如果某个底层定义在角落里多加了一个不该有的假设,或者把某个群族的边界静默收窄了,AI 依然能欢快地跑通 4310 万行证明,但证出来的却是一个被弱化过的假定理。
- 风险.目前早期喝彩多来自项目内部或关联学者(如参与项目的数学家 Ken Ono 与 AI 学者 François Charton),而 Georges Gonthier、Kevin Buzzard、陶哲轩以及独立的有限群论专家尚未交出针对
TauCeti顶层定义与lean4checker --fresh的第三方审计报告。
同样需要给那个“机器揪出 40 年数学漏洞”的故事降降温。Walter 1986 年论文里的反例确实被抓了个正着,但这并不意味着有限单群分类定理此前摇摇欲坠。群论学界早就为不平衡群定理铺设过多条不同的证明路线,Walter 的路径只是其中之一。AI 这次干的活,更像是给一座老旧但稳固的大桥做全身 CT 扫描,找出了其中一根辅梁的隐裂并换上了新铆钉,而不是推翻了整座桥的力学结构。
韩非子有云,右手画圆,左手画方,不能两成。过去一百年里,数学家既要当高屋建瓴的建筑师,又要当砌砖抹灰的泥瓦匠,往往在浩如烟海的局部引理中耗尽半生精力。19 世纪末的铁路狂潮曾把人类从长途跋涉的体力极限中解放出来,但随之而来的,是跨越全大陆的列车时刻表与标准轨距制定权之争。
今天的形式化数学撞上了相似的拐点,只是和铁路时代不完全一样,这次被工业化的不是物理位移,而是逻辑演绎本身。当一个 Gorenstein–Walter L-平衡定理单模块就能膨胀到 400 万行 Lean 代码,地球上已经没有任何一个碳基大脑能够通读这份证明。数学家手里的活计正在发生不可逆的分化:写证明的苦役归了硅基智能体,而人类被迫退守到最后一道、也是最凶险的一道防线——做那个确保题目没写错的出卷人。接下来几周,整个数学界真正屏息等待的,不是 AI 还能再刷出几千万行代码,而是哪位人类群论老手能拍着胸脯签下字,确认 TauCeti 里那几行顶层定义,真的装下了人类想问的那个宇宙。