2026年11月3日,艾伦人工智能研究所(Ai2)发布长上下文状态追踪基准测试 StateBench,配套公开了包含约 16,300 行标准测试子集的开源库。测试把 Gemini 3.8 Flash、Claude Opus 5.5 以及 GPT-6 Sol 和 Luna 拉到同一个赛场,让它们顺着长文档追踪变量的动态变化。结果很扎眼,在最长的复杂状态追踪任务上,这四款前沿模型的准确率全部暴跌至 13% 或更低。
过去两年,大模型厂商轮番把上下文窗口卷到百万级,靠大海捞针测试证明自己过目不忘。StateBench 直接捅破了这层窗户纸,找回几万字前的一个静态数字只是单点检索,顺着几万行代码或长篇推理小说推演一个变量的连续流转才是真实世界的状态计算。现在的顶级大模型,干的依然是翻书找字的活,根本算不完长链条的动态账。
为什么能大海捞针的模型,算不对五个杯子换球?
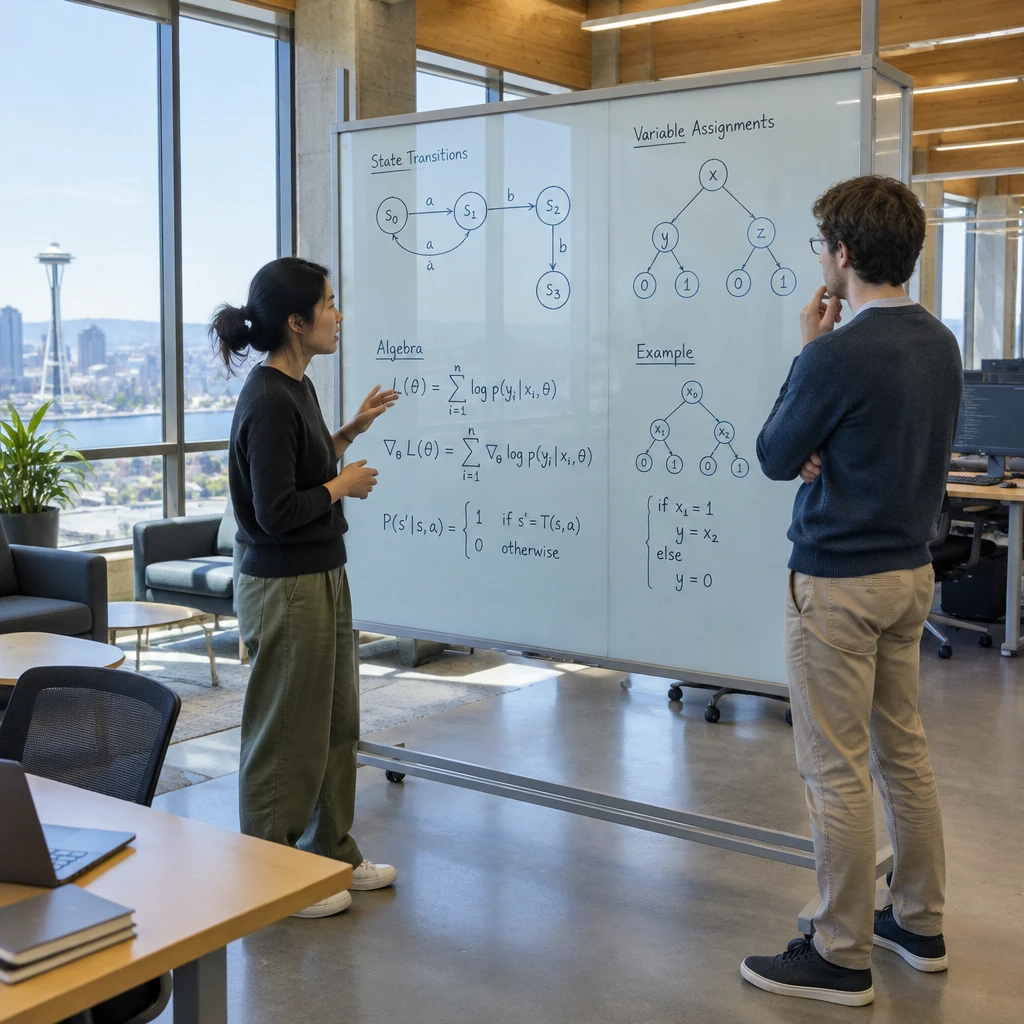
以往的学术评测要么只测静态检索,要么一上来就抛最难的群论问题,中间缺了给日常任务定级的标尺。Ai2 研究员 Jackson Petty、William Merrill 和 Ashish Sabharwal 在技术报告中引入代数里的 Krohn–Rhodes 理论,按原子操作把状态追踪拆成了四个难度递增的台阶。
为了公平对比,测试先生成一条最难的变量赋值序列,再保持变量数量、取值和位置不变,向下派生出三个简单版本:
- 不可变赋值(R-trivial).类似代码里的
let x = 4或人的出生日期,设定后永不改变,模型只需找回初始值。 - 按值覆盖(Aperiodic).类似
x = 4后面跟着x = 2或调温器设置,模型只要找到最新一次赋值,历史记录全可丢弃。 - 自引用累加(Soluble).类似
x = x + 5或比赛计分牌,每次更新依赖当前值,漏掉中间一步就会算错总数。 - 交叉引用与置换(General finite):类似
x = y或魔术师在五个杯子下藏球后反复交换位置($S_5$ 置换问题),变量之间互相依赖,牵一发而动全身。
这四层台阶刚好卡住了大模型的命门。Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 两款模型在前两级任务上表现稳健,因为无论是找初始值还是找最新覆盖值,本质上都可以靠注意力机制一步定位。
一旦踏入第三级自引用累加和第四级交叉引用,它们的准确率随着文本拉长直线跳水。在这些高难级别里,最终答案对中间每一步都高度敏感,漏看一次交换或算错一次加法,后面的推演就全盘皆输。
架构有解药,为什么预训练模型还是沦为盲猜?
既然标准 Transformer 的并行注意力机制在理论上就搞不定长链条置换,换用带持续运行记忆的循环架构(如 Gated DeltaNet)或混合架构能不能破局?我更在意的是 Ai2 为此做的两组对照实验,它直接戳破了行业里另一个流行迷思。
研究团队先做了一组靶向直接训练实验。他们从头训练了 6 个 2.75 亿参数的小模型,涵盖带 RoPE 或 NoPE 位置编码的 Transformer、混合架构以及两种 Gated DeltaNet 变体。这些模型只在包含 8 到 256 次赋值的数据上训练,随后直接拉到多达 64,000 次赋值的超长序列上测试,相当于最大训练长度的 250 倍。
| 模型架构变体 | 前三级难度(最长 250 倍外推) | 第 4 级 General finite(最高难度) |
|---|---|---|
| Transformer(RoPE / NoPE) | 随序列拉长明显退化 | 训练长度内即无法完全学会 |
| GDN⁺(非负特征值记忆更新) | 保持近乎完美准确率 | 超出 256 次训练长度后迅速退化 |
| GDN± / Hybrid±(正负特征值) | 保持近乎完美准确率 | 近乎完美泛化至约 10 倍训练长度 |
这组硬数据证明,架构差异确实决定了状态追踪的天花板。纯 Transformer 在训练长度内都学不会第四级任务;而允许正负特征值、记忆更新更灵活的 GDN± 与混合模型,不仅在前三级跑满 250 倍长度外推,在最难的交叉引用上也能稳稳撑到训练长度的 10 倍左右。
但一回到现实的预训练模型,剧情立刻反转。研究团队测试了使用相同语料预训练、训练上下文不超过 64,000 tokens 的开源模型家族,包括 70 亿参数的 Olmo 3(纯 Transformer)、引入 Gated DeltaNet 层的 Olmo Hybrid,以及 2.75 亿和 27 亿参数版本。结果所有预训练模型在第二级按值覆盖上就随着输入变长开始丢分,到了第四级交叉引用任务,哪怕是带有 Gated DeltaNet 层的 Olmo Hybrid,准确率也全部躺平在随机猜测水平。
架构给得出理论上限,现有的预训练配方却根本没把能力教出来。
更尴尬的是,预训练模型连题目换件衣服都认不出来。2.75 亿参数的混合架构和 Gated DeltaNet 模型,在做 RULER 风格的第一级简单题时能拿接近满分;一旦把完全相同的底层逻辑包装成电子表格编辑格式,准确率瞬间跌回随机盲猜。
《孙子兵法》里讲,「水因地而制流」。现在的混合架构就像挖好了能通水的河道,但通用的网页和代码预训练语料里,根本没有足够密集、干净的长程状态转换信号去冲刷它。模型在预训练里学会的依然是走捷径猜词,而不是老老实实维护内部状态机。
这也让我对各家宣称能自主维护长周期记忆的 Coding Agent 多了一分警惕。十九世纪铁路网刚铺开时,人们以为只要铁轨修得够长,列车就能无限跑下去,直到撞上信号调度失灵引发的连环追尾,才明白轨道长度和调度能力是两码事。今天的大模型把上下文铁轨铺到了百万 token,状态调度的扳道工却还在靠猜。
不过看这份榜单时也要留个心眼,报告里的开源预训练模型是用候选答案选项(candidate answers)打分的,而 GPT-6 等闭源前沿模型是直接生成最终状态(generated final states),两套评测协议不宜直接横向比原始分高低。同时,StateBench 目前假设变量集合是固定的,还没法评估对话中途突然冒出新人物、新变量时的动态追踪能力。
- 风险.开发长代码分析或长周期 Agent 的工程团队,如果把多步状态传递和变量交叉引用直接扔给大模型在上下文里心算,即使用上 GPT-6 或 Claude Opus 5.5,长链条下的准确率也会崩盘,必须用外部代码解释器或显式数据库接管状态维护。
至于基础模型团队,换上 Gated DeltaNet 混合架构只是拿到了入场券。接下来真正的硬骨头,是怎么改写预训练的数据配比和训练目标,把那个在实验室里能外推 250 倍的状态机,真正唤醒在通用大模型里。