在拥挤的地铁或安静的开放式办公室里,对着电脑大声念出代码指令或私密消息,始终是一件令人尴尬的事。Y Combinator 支持的初创公司 The Subvocal Company 近日推出了一款名为 Subvocal 的无声输入眼镜,试图直接干掉麦克风收音。官方宣称佩戴者无需发出任何声音,也不用开启摄像头,只靠几乎看不见的微小口型动作,就能以每分钟 200 词以上(200+ WPM)的速度把内容实时转化成文字,直接输入到 Claude Code、Cursor、ChatGPT 或 Slack 中。这款硬件目前已开启早鸟预订,但如果我们剥开其宣传演示,去翻看它底层的射频原理、监管门槛以及自家的招聘启事,就会发现这款明星硬件距离真正的日常可用,还隔着几道尚未跨过的工程鸿沟。
499 美元买一张 2027 年的射频期票
Subvocal 解决的是 AI 时代一个非常具体的交互冲突。语音是人类向大模型和编程 Agent 倾倒想法最快的方式,但声音天然缺乏隐私,还会干扰旁人。以往的无声语音接口(SSI)要么像 MIT 著名的 AlterEgo 那样在脸上贴满表面肌电图(sEMG)电极,要么依赖摄像头对着嘴部做视觉唇语识别。Subvocal 换了一条更隐蔽的路线,把射频传感技术塞进了普通眼镜的形态里。
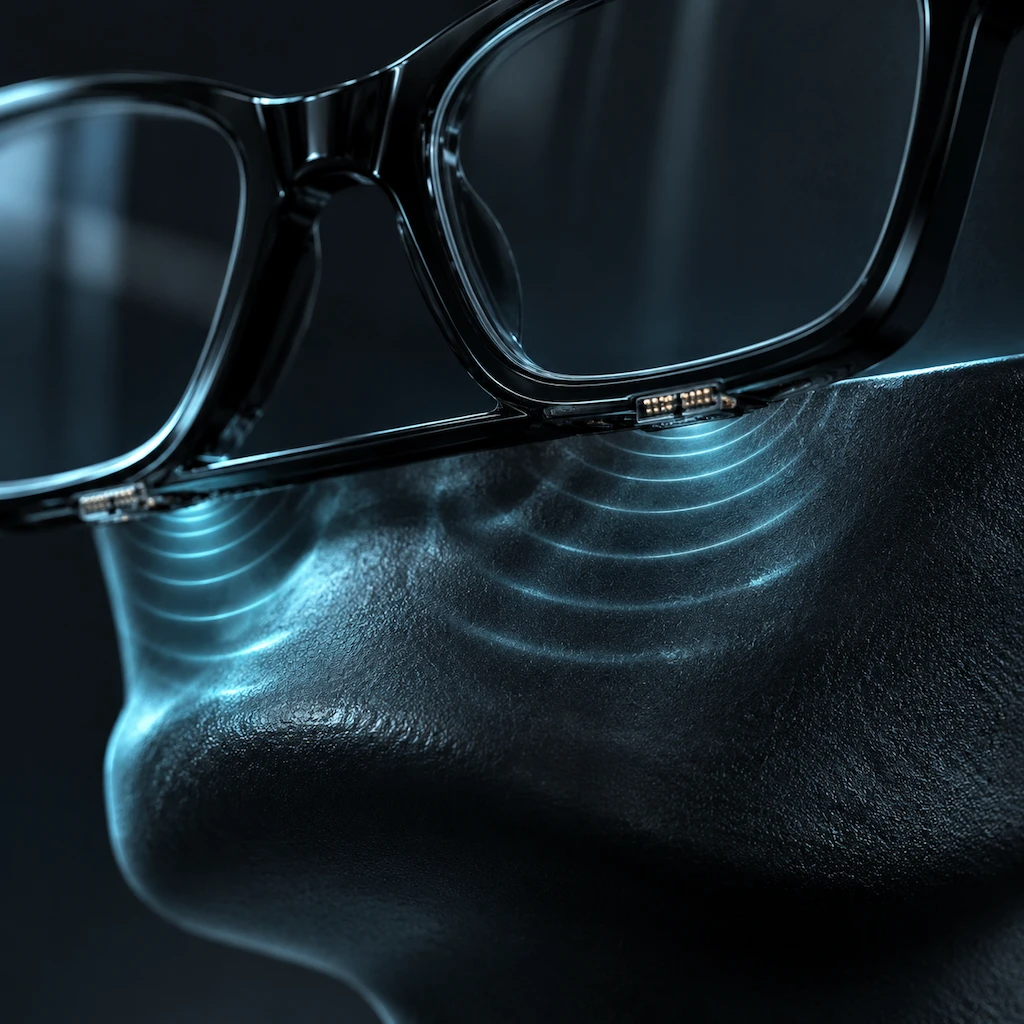
根据其在 Y Combinator 披露的信息,这副眼镜不靠摄像头拍嘴型,也不会读取大脑里无意识的杂念,而是主动向面部发射低功率无线电波。当用户刻意做出无声的口型动作时,面部肌肉和组织的微小运动会改变无线电波的反射信号,底层模型再把这些信号变化实时解码为文字。因为完全不依赖声音传播,周围的交通噪音、咖啡馆音乐或同事交谈都不会干扰输入。
这种主动发射无线电波的方案,直接决定了它的商业交付节奏。Subvocal 的早鸟预订总价为 499 美元(划线原价 699 美元),用户需要先支付 199 美元定金,发货前再补齐 300 美元尾款,税费、运费以及可选的处方镜片费用均需另算。虽然官方承诺定金在支付尾款前随时可退,且会在批准后 7 个工作日内原路退回,但它的预计发货时间一直排到了 2027 年第一季度(1 月至 3 月)。目前付费预订仅对美国市场开放,且交付明确受制于美国联邦通信委员会(FCC)的监管批准。此外,Hacker News 社区上也有发帖质疑该项目只是对康奈尔大学实验室 2023 年某项研究的劣质克隆,不过该指控帖目前尚无具体评论与分析支撑。
招聘启事拆穿了官网的成熟滤镜
如果只看消费端官网,你会觉得这是一款随时可以量产的成熟产品:支持开放词表实时解码、只需简短的个人校准、结合上下文轻松纠错。但到目前为止,Subvocal 官方并未公布任何具体的字错率(WER)、测试参与人数或针对未见新用户的基准测试数据,仅在 Y Combinator 的发布帖里模糊地表示错误率相当低。
真正的工程实情,藏在他们同期发布的机器学习负责人(Head of ML)招聘启事里。
官网许诺的是即戴即用的未来,招聘启事招的却是来救火的工匠。
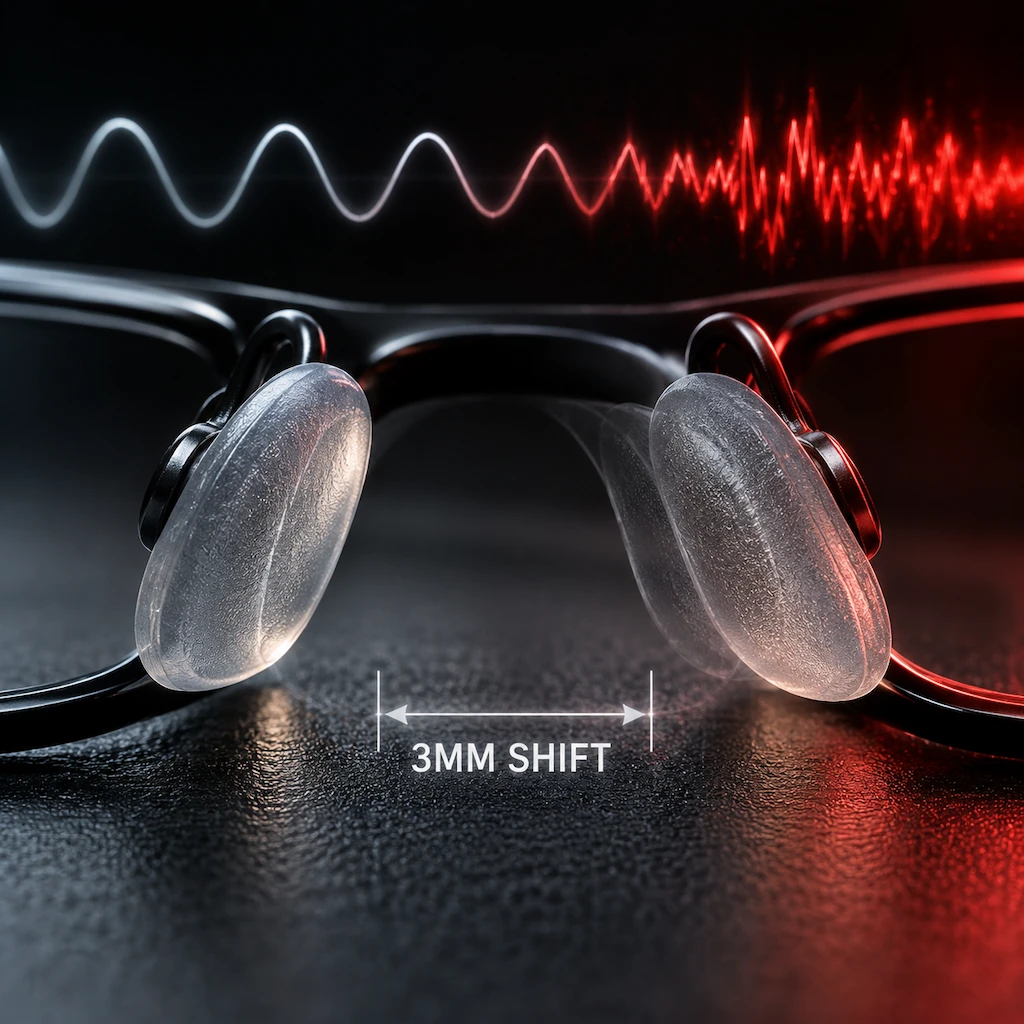
在这份招聘文件中,团队直接坦白了底层模型尚未攻克的难关:利用大约 15 分钟的校准数据去适应一名新用户,依然是当前的工程攻关目标;而如何让模型实现跨人群、跨使用周期(sessions)以及跨佩戴位置的泛化,更是摆在眼前的核心挑战。
什么叫跨佩戴位置的泛化?你在工位上揉了揉眼睛,或者去洗手间摘下眼镜再戴上,镜架在鼻梁上的位置就会发生几毫米的偏移。对于靠反射无线电波捕捉细微肌肉动作的传感器来说,这几毫米的位移足以让此前采集的信号特征彻底失真。如果每次扶一下眼镜都要重新做十来分钟的校准,所谓在地铁和工位上随时默念写代码的流畅体验就无从谈起。
历史标尺下的 200 词神话与现实选择
把 Subvocal 放进无声语音接口的学术坐标里横向对比,更能看出其宣称指标的激进程度。长期以来,无声语音设备极易在小词表或特定测试者身上刷出高准确率,比如 Hacker News 网友曾指出某款号称 95% 准确率的设备,其实只是在 5 个预设句子各重复 100 次的封闭条件下测出来的;一旦进入开放词汇和连续语音,性能就会断崖式下跌。
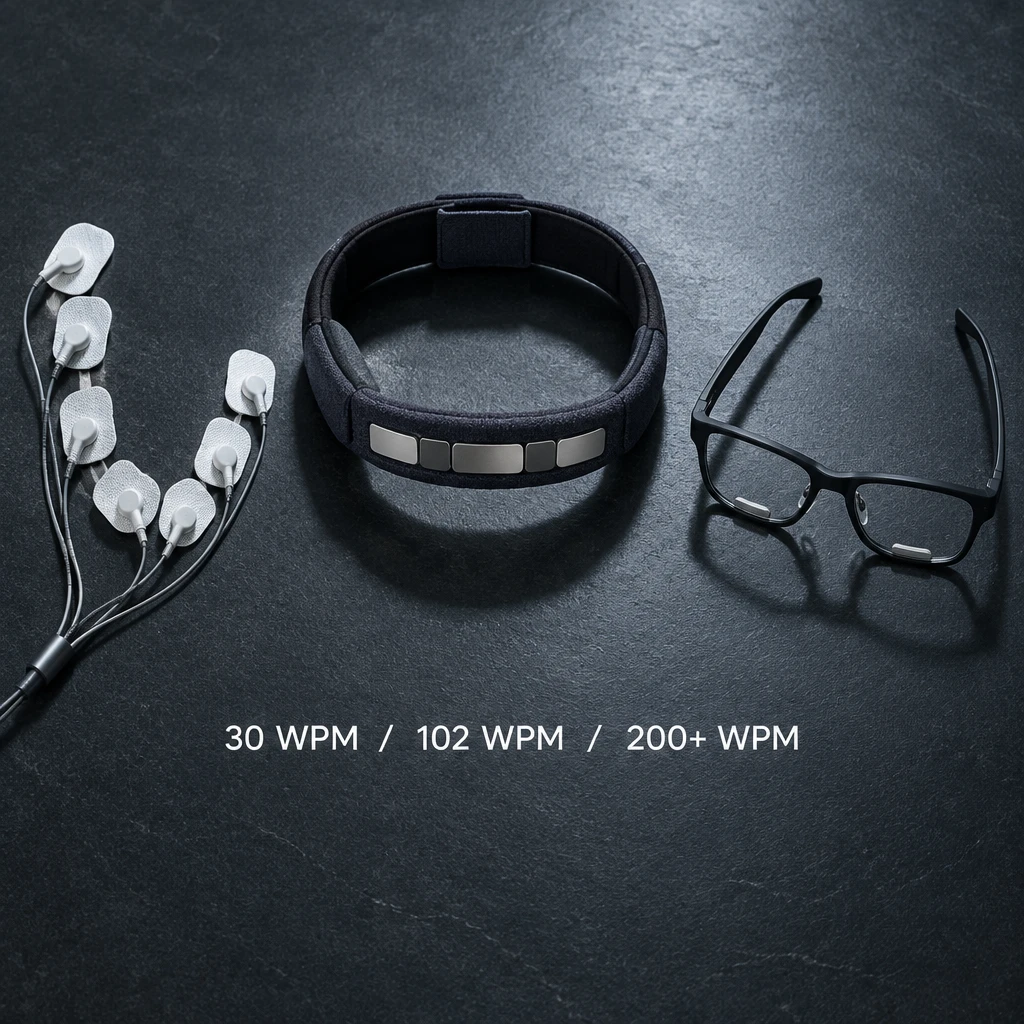
即便强如该领域的学术标杆 MIT AlterEgo,其在 2018 年论文中报告的 92.01% 准确率,也仅仅是针对 10 名参与者的 0 到 9 数字识别,单次发音后处理延迟为 0.427 秒,算术应用的个人校准同样需要约 15 分钟。到了 2019 年的连续语音硕士论文中,面对仅由 20 个词汇组成的 200 个句子数据集,AlterEgo 配合语言模型后的字错率(WER)依然高达 10.7%(无语言模型为 14.8%),记录到的平均发音速率只有 102.4 WPM,且效果高度依赖电极粘贴位置的一致性。
另一个参考坐标是 Unbabel 与 HALO 团队在 2025 年 9 月 27 日预印本中披露的系统。为了绕开免校准与高准确率的冲突,他们干脆放弃了逐字听写,改用头带电极捕捉眉毛肌肉收缩,用来在 AI 生成的预设句子回复中做选择。这套系统虽然做到了无需个人校准和 96.26% 的手势分类准确率(F1 分数为 85%),但在渐冻症(ALS)患者测试中的实际沟通速率只有约 30 WPM。
| 方案名称 | 核心传感机制 | 词汇范围与测试基准 | 披露准确率 / 字错率 | 实际沟通速率 | 校准与佩戴限制 |
|---|---|---|---|---|---|
| Subvocal | 眼镜射频(RF)传感 | 宣称开放词表连续语音 | 未公布具体数据(仅称错误率低) | 宣称 200+ WPM | 15 分钟校准与位置泛化仍在攻关 |
| MIT AlterEgo (2018) | 面部贴片表面肌电 | 0-9 数字识别(10 人) | 准确率 92.01% | 单次延迟 0.427 秒 | 算术应用需约 15 分钟个人校准 |
| MIT AlterEgo (2019) | 面部贴片表面肌电 | 20 词组成的 200 句数据集 | 字错率 10.7%(无语言模型 14.8%) | 102.4 WPM | 严重依赖电极位置一致性 |
| Unbabel / HALO | 头带电极测眉毛收缩 | 选择 AI 生成回复(非逐字) | 手势分类准确率 96.26%(F1 85%) | 约 30 WPM | 无需个人校准 |
当学术界连 20 个词的连续识别都只能做到 102.4 WPM 且伴随 10.7% 的错字率时,Subvocal 直接跳到开放词表 200+ WPM,却拿不出任何同行评审或基准测试协议支撑。更现实的对照在于,如果程序员只是想在安静的办公室里不发出声音地驱动编程工具,Hacker News 社区上已经出现了像 Hushkey 这样的纯软件替代方案——直接调用 MacBook 自带摄像头在本地做唇语识别,虽然牺牲了移动性和无摄像头卖点,但零硬件成本且现成可用。
- 风险.现在掏出 199 美元预订 Subvocal 的早期尝鲜者,不仅要把资金锁定到 2027 年第一季度并承担 FCC 审批的不确定性,更可能拿到一副每次扶眼镜都需要重新校准的半成品;在官方放出无剪辑、未见新用户的开放词表实测 Demo 之前,捂紧钱包才是最理性的决定。