小米正式发布了开源原生全模态大模型 MiMo-V2.6 系列。旗舰规格 MiMo-V2.6-Pro 采用稀疏 MoE 架构,总参数量约 1.02T、激活参数约 42B(即 1T-A42B),支持 100 万 tokens 上下文窗口,并在 Artificial Analysis 智能指数中以 46 分升至开源模型榜首,单任务基准测试成本压至 0.13 美元。伴随模型发布的,还有原 DeepSeek 核心工程师罗福莉等团队成员公开的强化学习实时看板。
但在社交网络迅速发酵的“300 万美元训出前沿大模型”叙事,存在明显的认知错位。把后训练阶段的算力消耗等同于造出大模型的全套开销,不仅误读了真实账本,更掩盖了当前大模型演进重心正在发生的实质转向。
拆解 262 万美元账本:预训练退位,智能体强化学习接棒
外界流传的极低成本,对应的是 Pro 版本强化学习(RL)后训练阶段耗费的 262 万美元,轻量版 Flash 在该阶段的支出则约为 85 万美元。两款模型在不到 6 天内完成了 30 步迭代。
这笔账单绝非从零构建基座的全部开销。海量多模态数据的预处理、清洗以及千亿级 MoE 底座的预训练算力沉没成本,并未计入这 262 万美元之中。脱离既有的成熟预训练权重去谈极低造价,在工业界毫无实操意义。
决定模型能力跃迁的主战场,正在从不计成本的蛮力预训练转向高密度的后训练自进化。
这笔支出的真正价值,在于验证了大规模智能体强化学习(Agentic RL)作为后训练加速器的成立。过去业界习惯将算力大头押注在通读互联网网页的预训练上,而小米的账本展示了另一种分配路径:用高强度针对性强化学习激活大容量稀疏模型,在数天之内将基座模型的复杂任务能力拉升至前沿梯队。
把后厨端上桌面:异步 GRPO 与高吞吐下的工程硬仗
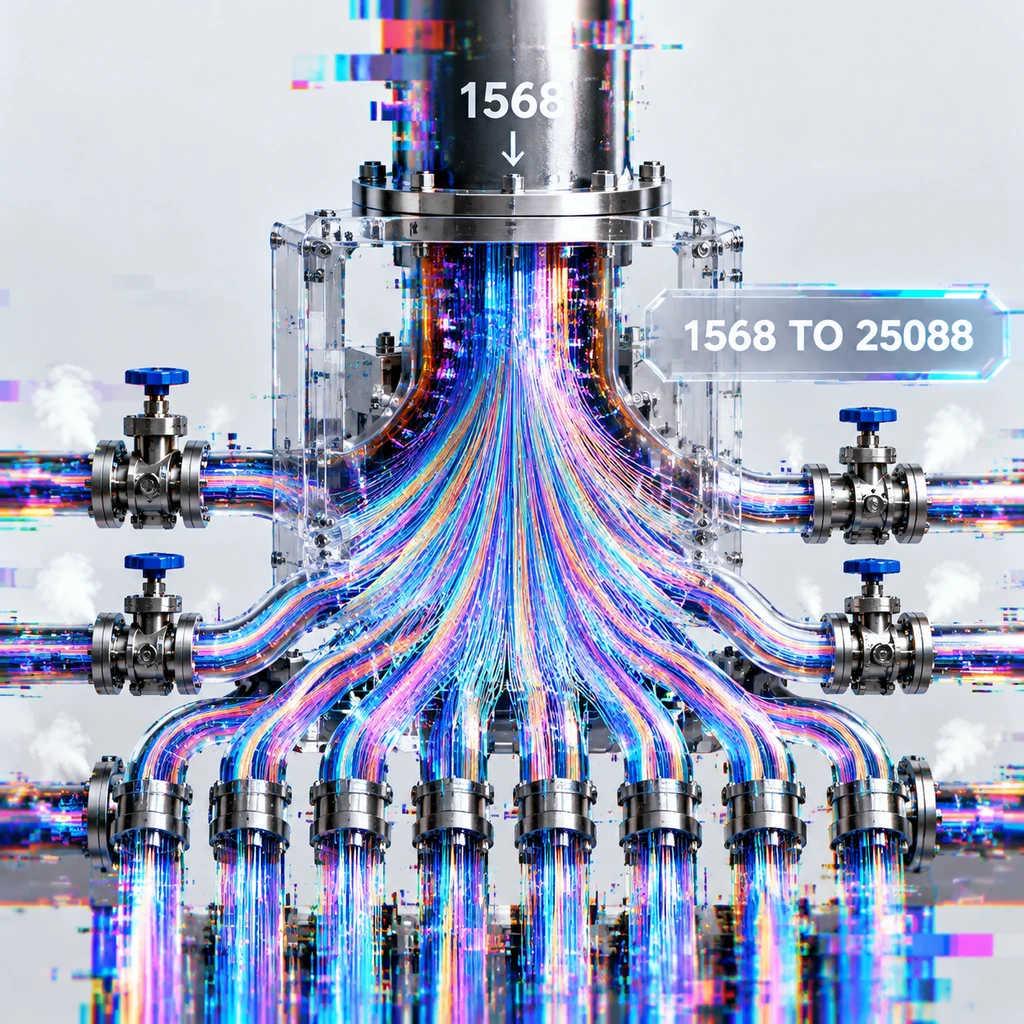
支撑这轮模型快速进化的关键,是小米自研的异步 GRPO(Group Relative Policy Optimization)强化学习系统。系统在单步更新中整合了 1,568 个 prompts,每个 prompt 并行展开 16 次 rollout,单步更新产生的执行轨迹最高达到 25,088 条,单步吞吐量稳定在 35 亿至 37 亿 tokens 之间。
在这套流水线下,Pro 与 Flash 在整整 30 步迭代中累计消化了约 75 万条轨迹。数据反馈直接映射在下游代码能力上:Pro 在严苛的 DeepSWE v1.1 基准测试得分从 58.4 跃升至 72.6,Flash 则从 48.8 提升至 65.7。
相比亮眼的测试分数,更罕见的动作是训练团队上线了实时监控看板。看板没有滤掉工程瑕疵,而是直接暴露了真实的系统崩溃现场:多次因节点显存溢出引发的训练骤停、MoE 专家网络分配严重不均导致的计算倾斜、判分节点与训练节点之间的跨网络通信超时,以及若干次被迫回滚的作废尝试。
以往大模型发布会大多只展示平滑上扬的学习曲线,把杂乱无章的工程代价藏在公关辞令之后。将未修饰的训练遥测公之于众,一方面确立了技术硬实力,另一方面也向行业表明:前沿强化学习从来不是写好损失函数就能自动收敛的算法黑盒,而是一场依赖高容错调优与重度系统工程的贴身肉搏。
7000 个交互环境之外:测试防线与真实业务温差
技术开源的彻底程度是 MiMo-V2.6 引发社区关注的另一诱因。小米此次直接采用了 MIT 开源协议,不仅同步公开了模型权重、全套端到端 RL 训练框架,还放出了 7000 多个任务交互环境代码,甚至开源了作为对照的 Qwen-9B 蒸馏构件。该构件在经过小米强化学习套件清洗训练后,SWE-bench Verified 得分从 61.1 抬升到了 66.2。
但这并不意味着开源模型可以毫无阻力地接管生产业务。开源社区的兴奋很快迎来了实际落地的冷静审视。
一方面,公开监控看板代表着极高的工程透明度,但透明度不等于跑分绝对保真。7000 多个交互环境的代码虽然开源,但底层任务的数据生成链路、去重清洗细节以及环境防作弊策略尚未全部开放审计。如果环境构建缺乏严格的训练集与测试集物理隔离,评测结果就难以彻底摆脱针对特定沙盒过拟合的嫌疑。
另一方面,早鸟开发者在实操接入中也指出了温差。MiMo-V2.6-Pro 在多步工具调用和长代码排查上反应迅速,但在实际生产链路中,模型往往倾向于产生冗长的高密度推理 tokens,导致实际处理延迟与推理算力消耗高于预期,部分交互依然需要复杂的 prompt 人工引导。此前 MiMo-V2.5 留给部分工程师的稳定性顾虑,仍需要时间在真实生产环境中消化。
- 建议.计划将 1T-A42B 模型引入生产管线的研发团队,应先自建私有业务闭环沙盒,重点核算实际推理 tokens 吞吐与长程调用的稳定性,切忌直接按基准榜单指标预估生产承载力。
- 风险.若缺乏第三方机构对评测沙盒、防数据污染机制进行严格交叉审计,模型在榜单上的强势表现与真实复杂场景表现之间的落差,仍将是技术选型的主要潜在代价。