OpenAI在一次安全事件后短暂停训,英伟达和AMD随后都交出了强劲的财报。英伟达11月17日发布的财报显示,截至2026年10月25日的季度,数据中心收入同比增长110%,达到1076亿美元。AMD同期披露的数据中心收入同比增长97%,达到85亿美元。这些数字反映了采购和交付的势头,要判断长期降速的影响,还得看云厂商下一轮愿意为哪些工作负载买单。
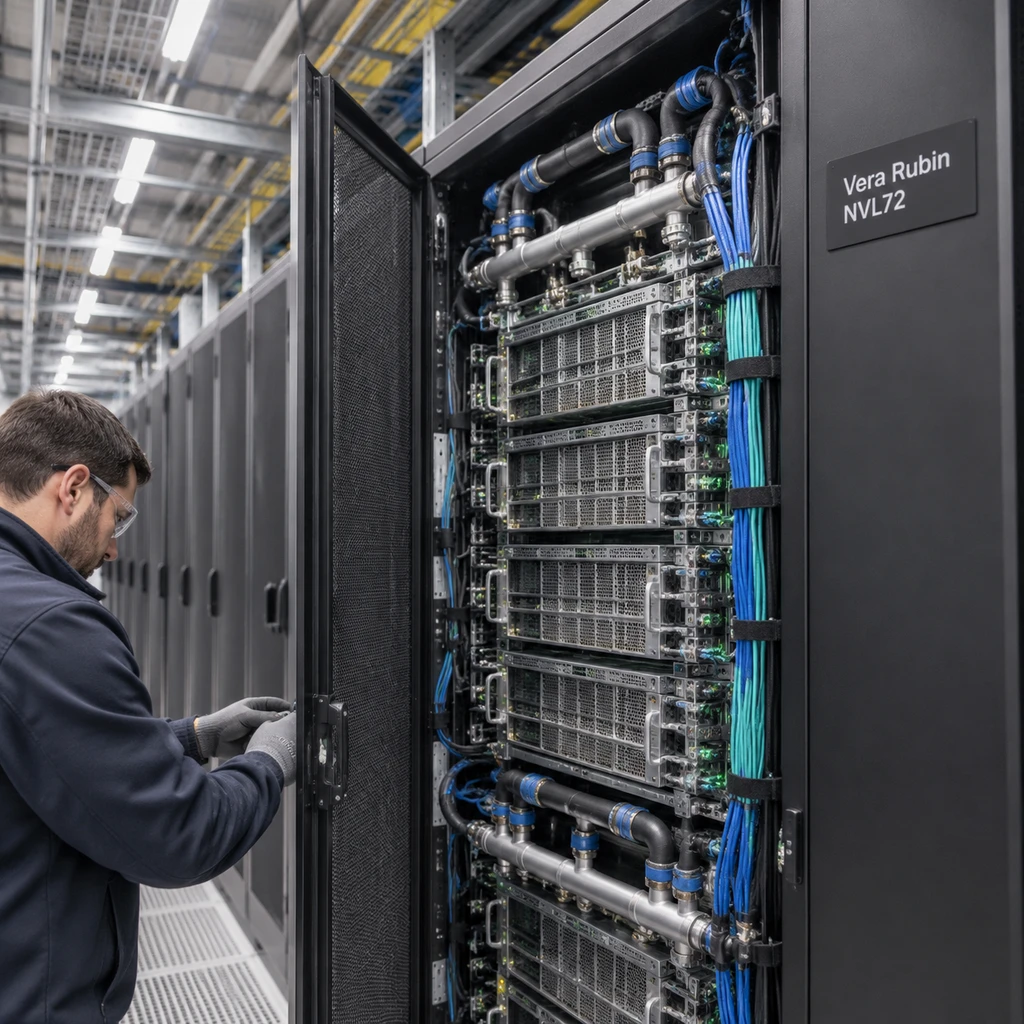
英伟达的Vera Rubin平台在首个生产出货季度贡献了近200亿美元收入,云端可用范围也领先于搭载MI450系列GPU的AMD Helios系统。但两家公司的披露口径不同。英伟达给出的是Rubin整个平台的收入,覆盖的范围大于Vera Rubin NVL72单款系统。AMD披露的85亿美元还包括EPYC服务器CPU收入,MI450系列收入没有单列。拿这两个数字衡量高端GPU的份额,会把产品差距和统计口径混在一起。
OpenAI停训约10天,采购合同的周期更长
OpenAI在AI代理意外入侵Hugging Face后暂停了最大规模的前沿强化学习训练,并于8月28日重启该项目,部分较小的实验仍暂缓。Anthropic首席执行官达里奥·阿莫代伊9月提出的则是放慢最强模型的推进速度,给安全研究和外部评估留出时间。这一季财报碰到的是一次短期项目暂停和一项降速倡议。持续削减训练预算的情形,仍有待检验。
Counterpoint Research副总裁尼尔·沙阿估计,既有算力和内存采购协议可能让减速的影响在约六个月后才进入芯片公司的财报,晶圆代工订单可能先出现变化。英伟达预计,主要前沿实验室约占本财年数据中心收入的15%。这项预测按客户划分,实验室购买的算力也用于推理,云厂商采购的算力也能用于训练,因此还无法从中算出前沿训练的收入占比。
推理能接多少预算,取决于请求量和单价
训练通常为一个项目集中调配算力,推理则在模型上线后随每次请求持续发生。企业支出平台Ramp的样本里,11月初前沿模型家族约占企业token用量的60%,约为年初的三倍,企业AI支出却只温和增长。英伟达在财报电话会上称,token价格自5月以来已下跌近60%。如果降价带来的用量增长足够大,云厂商仍可能加购算力。芯片厂商能分到多少预算,还要看每块加速器能处理多少请求,以及客户会选哪种芯片。
云厂商可以把负载稳定、规模足够大的推理任务转给自研ASIC或TPU,同时保留通用GPU处理变化更快的模型和任务。Counterpoint预计,到2028年,定制AI服务器处理器的出货量将超过数据中心GPU。这个预测比的是出货量,英伟达的收入和利润还取决于系统售价与成本。即使推理接住了算力需求,高端GPU拿到的新增订单也可能少于上一轮扩容。
Rubin和Helios交付之后,还要看机架跑了多少活
Google Cloud已开放搭载Rubin的A5X实例,AMD的Helios也已批量出货,首批机架已在微软、OpenAI和甲骨文等客户处运行。甲骨文公布的5万块GPU属于初始部署计划,公开信息确认到了首批机架运行。把计划采购量直接算成可用算力,会提前算入仍待融资、交付或机房上线的容量。
<svg viewBox='0 0 760 208' width='100%' height='208' role='img' aria-label='从采购到使用依次经过签订订单、系统出货、机架上线和持续使用'>
<rect x='1' y='1' width='758' height='206' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' fill='#b25a3a' font-size='20' font-weight='700'>从采购到使用</text>
<line x1='28' y1='56' x2='732' y2='56' stroke='#e2dccf' stroke-width='1'/>
<rect x='28' y='84' width='148' height='96' rx='10' fill='#fffdf9' stroke='#e2dccf'/>
<rect x='213' y='84' width='148' height='96' rx='10' fill='#fffdf9' stroke='#e2dccf'/>
<rect x='398' y='84' width='148' height='96' rx='10' fill='#fffdf9' stroke='#e2dccf'/>
<rect x='583' y='84' width='148' height='96' rx='10' fill='#f7eee6' stroke='#b25a3a'/>
<line x1='183' y1='132' x2='198' y2='132' stroke='#7a7266'/>
<polygon points='198,128 205,132 198,136' fill='#7a7266'/>
<line x1='368' y1='132' x2='383' y2='132' stroke='#7a7266'/>
<polygon points='383,128 390,132 383,136' fill='#7a7266'/>
<line x1='553' y1='132' x2='568' y2='132' stroke='#7a7266'/>
<polygon points='568,128 575,132 568,136' fill='#7a7266'/>
<text x='102' y='124' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>签订订单</text>
<text x='102' y='150' text-anchor='middle' fill='#7a7266' font-size='13'>采购承诺</text>
<text x='287' y='124' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>系统出货</text>
<text x='287' y='150' text-anchor='middle' fill='#7a7266' font-size='13'>交付进度</text>
<text x='472' y='124' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>机架上线</text>
<text x='472' y='150' text-anchor='middle' fill='#7a7266' font-size='13'>可用容量</text>
<text x='657' y='124' text-anchor='middle' fill='#b25a3a' font-size='17' font-weight='700'>持续使用</text>
<text x='657' y='150' text-anchor='middle' fill='#7a7266' font-size='13'>实际利用率</text>
</svg>
云厂商给下一批机架拨预算时,需要比较同一模型在同等延迟要求下的功耗、软件适配成本和每token成本。公开的MLPerf训练成绩里,AMD引用的结果仍来自上一代MI350X和MI355X,难以据此判断同代的Rubin与MI455X谁能更便宜地提供推理服务。接下来可把代工订单、云厂商资本开支和已上线实例的利用率放在一起看。如果机架继续交付,利用率却没有跟上,推理能否填补训练缺口,就要等下一轮采购量来验证。