2026年10月28日,路透社引述两名知情人士消息称,美国司法部正在审查NVIDIA计划以129.3亿美元收购开源AI平台Hugging Face的交易。这项横跨拜登与特朗普两届政府的反垄断长线调查,同时把准星对准了NVIDIA的过往并购与日常销售——包括它是否只给那些顺带买下NVIDIA网络设备和Groq处理器的客户分配更多紧俏的AI芯片。
外界很容易把这件事看成老套的巨头吞并社区,担心NVIDIA一脚踢开其他芯片商。但翻开NVIDIA向美国证券交易委员会提交的文件就会发现,这笔2026年9月3日官宣、标价129.303亿美元的交易,账面拆得极其精明:约119亿美元付给Hugging Face股东,另外拿出最高10亿美元作为加入NVIDIA的员工股权留任激励。它买的不只是代码仓库,更是用一副10亿美元的金手铐,把开源AI世界最懂开发者生态的那批操盘手锁在自己船上。
先把账本和调查清单摊开
很多报道把各项调查混为一谈,搞得像NVIDIA明天就要上法庭。这里得先把证据边界划清楚:截至2026年10月28日,美国司法部针对Hugging Face收购案和芯片配额搭售的动作,性质上属于信息收集阶段的问询,还不是正式的违法认定,也未必一定会走向公开起诉;NVIDIA对此拒绝向路透社置评,Groq同样未回应置评请求。
但这张问询清单之所以让人后背发凉,是因为它把NVIDIA过去两年零散的动作,串成了一张从底层硬件直通顶层社区的网:
- 顶层入口(Hugging Face):预计2027年上半年完成交割,NVIDIA对外承诺收购后平台将继续支持广泛的芯片、云和AI提供商。
- **算力调度层(Run.ai与SchedMD)**:两家管集群调度与开源编排的软件商已被收入囊中;此前欧盟委员会在审查并放行Run:ai案(案号M.11766)时,就专门评估过NVIDIA把编排软件与GPU硬件捆绑的能力与封锁效应,只是因为当时细分市场还有足够替代方案才予以放行。
- 推理芯片与配额杠杆(Groq):调查人员正在核实NVIDIA是否拿紧俏的AI芯片配额当筹码,要求客户搭售其网络设备和Groq处理器。路透社在2026年9月9日还曾引述《纽约时报》报道,称司法部正调查NVIDIA在2025年与Groq达成的技术授权安排是否为了规避反垄断审查而刻意设计交易结构,不过路透社当时注明无法立即独立核实这一说法。
- 欧洲战线(CUDA与CoreWeave):法国竞争管理局同样在调查NVIDIA的反竞争行为,其发布的生成式AI竞争意见书直接点名了行业对CUDA软件的依赖(当时唯一完全兼容NVIDIA GPU的环境)、对CoreWeave等AI云服务商的投资、自我优待风险,以及潜在的供应限制、不公平合同条款和客户歧视。
闭源巨头造芯自保,NVIDIA必须守住开源大门
为什么一家卖铲子的硬件公司,非要花将近130亿美元去买一个托管开源模型和数据集的网站?
因为大客户正在给自己打铁。当OpenAI、Google、Meta这些头部闭源实验室纷纷自研ASIC芯片,试图摆脱对单一硬件商的依赖时,开源与开放权重模型生态就成了NVIDIA绝不能丢的战略基本盘。以前NVIDIA靠GPU硬件加CUDA编程生态这道双保险吃饭;现在闭源大厂想绕开CUDA直接写底层算子,NVIDIA就得往上游走,把开发者每天找模型、跑测试、下权重的总大门买下来。
社区里不少支持者替这笔交易算过效率账:Hugging Face长期需要烧钱维持庞大的模型托管和免费推理,NVIDIA进场能直接注入资金、算力和企业级支持,帮中小机构降低开发门槛。这话没错,微软当年买GitHub时,大家也是这么欢呼的。
但微软买GitHub时,手里并没有垄断全球八成以上的服务器CPU;而NVIDIA手里捏着全行业排队抢购的GPU配额。
当配额分配权(Allocation Power)和顶层分发入口合体,商业逻辑就变味了。你看司法部同步查的那条线索——客户如果肯顺带买NVIDIA的网络设备和Groq推理处理器,就能拿到更多AI芯片配额。这在反垄断法里叫典型的杠杆传导:用你在A市场的绝对统治力,强行替你在B市场和C市场的新产品开路。
反垄断真正怕的不是关门,而是后台那双眼睛
我更在意的是,既然NVIDIA已经拍胸脯保证Hugging Face继续对其他芯片和云厂商开放,为什么美国司法部和反垄断学者还是如临大敌?
因为外行看垄断,总觉得是新东家在门口挂一块“AMD与Google不得入内”的牌子;内行看垂直并购,盯的是软性歧视和后台情报。
买下中立国,最赚的不是收过路费,而是看清所有对手的底牌。
美国司法部《并购指南》第5条和第6条写得非常透彻,垂直并购最核心的反垄断关切有三样:限制竞争对手获取必要服务、通过提高转换成本巩固既有主导地位(Entrenchment),以及通过新收购的平台获取竞争对手的敏感信息。
把这三条放进Hugging Face的日常运行里,画面立刻就清楚了。19世纪末洛克菲勒的标准石油公司之所以能扼杀对手,不仅因为控制了炼油厂,更因为它通过铁路回扣体系摸清了每一个竞争对手的发货量、去向和成本底线。今天的情况当然不完全一样,开源代码本身是公开的,但开发者的行为轨迹和企业级测试数据却是最高机密。
一旦Hugging Face成为NVIDIA的全资子公司,哪怕代码一行不封杀,它依然握有两个致命武器:
- 默认配置的微小偏航开源模型在法律上保持开放,但在模型搜索排名、官方文档示例、量化工具链的优先适配度上,只要默认配置向CUDA和Groq多倾斜半步,对非NVIDIA后端的测试支持稍微慢半拍,AMD ROCm或独立AI芯片初创公司的推广成本就会翻倍。开发者最怕折腾,一行报错就足以让他们退回CUDA。
- 全行业去CUDA化的雷达监控AMD和Intel的硬件极度依赖Hugging Face这个中立试验场,来向客户证明自己能跑通主流开源模型。收购完成后,如果没有严密的隔离,NVIDIA在后台就能实时看到:哪家大厂的工程师正在用AMD ROCm或TPU高频拉取某款模型、哪一个去CUDA化的开源推理项目正在起势。在替代生态刚冒头的那一周,它就能精准调动自家的工程师和芯片配额去定点狙击。
- 风险.开源社区最怕的从来不是平台收费,而是当你以为自己在用中立工具训练替代方案时,你的每一次跑分和报错都成了算力霸主调整防线的战报。
2027年交割前,看清三个待验证的路标
这笔129.3亿美元的交易把完成时间定在2027年上半年,留出了大半年跟欧美监管机构博弈的缓冲期。同样面临巨大压力的还有AWS、Azure、Google Cloud以及Lambda等算力云厂商——它们既怕Hugging Face把企业级一键部署的推理流量默认导给NVIDIA自家的DGX Cloud或它持股的CoreWeave,又怕自己的大客户在平台上留下的调用数据被竞争对手看光。
接下来大半年,不用听公关稿里怎么歌颂开源精神,盯紧三个硬指标就能看清终局:
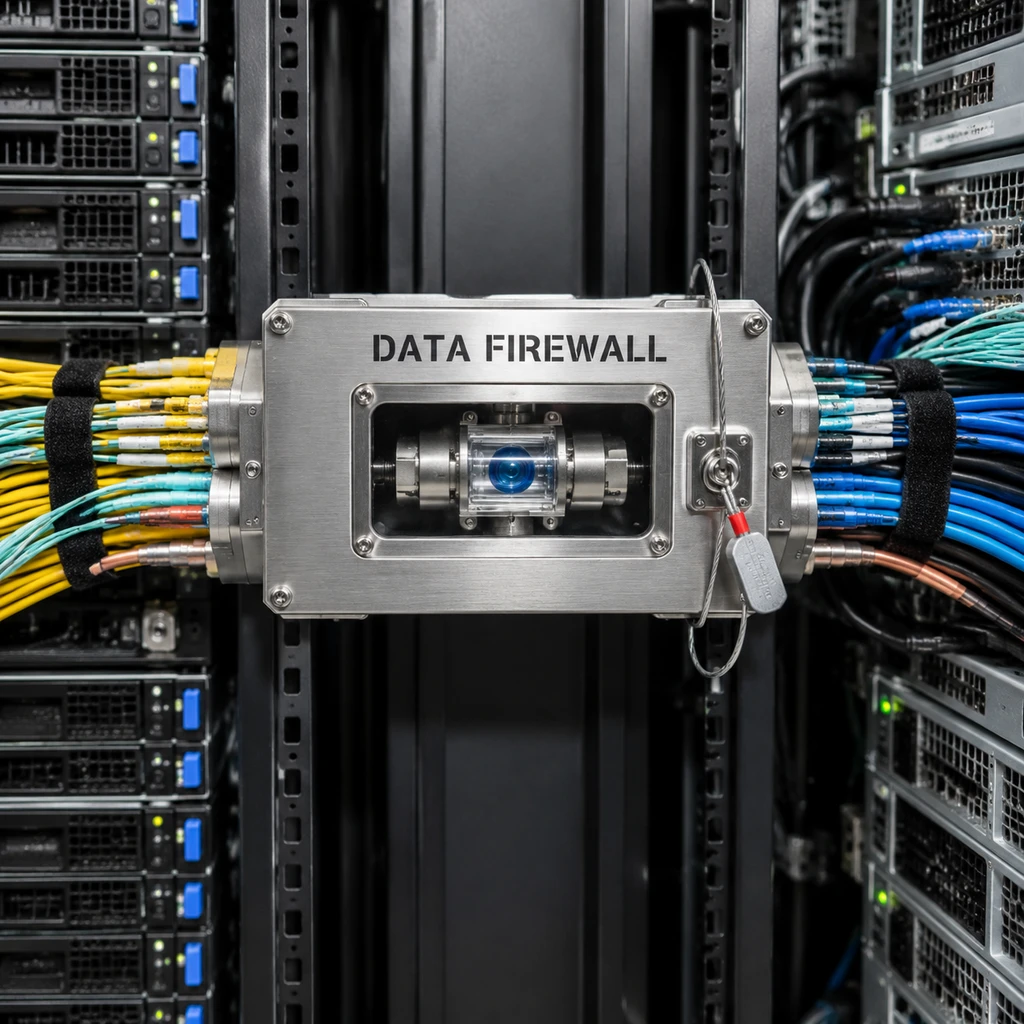
- 结论.第一看美国司法部是否把目前的问询升级为正式的二次请求(Second Request),一旦发出,意味着交易进入耗时漫长的深度反垄断审查;第二看欧盟委员会与法国竞争管理局是否借着此前调查CUDA和CoreWeave的底子同步立案;第三看如果监管层最终不直接叫停交易,会不会逼NVIDIA签下带牙齿的行为性救济承诺——比如强制设立后台数据防火墙、公开模型推荐与搜索排名算法、强制要求新模型首发时对多硬件后端提供同日同等测试支持。
古人讲“假途灭虢”,借道往往不是为了路过,而是为了顺手把那个扼守要冲的小国变成自己的内院。只是这一次,监管者站在城楼上,把账本看得很清楚。