2026 年 10 月,分布式关系型数据库 rqlite 的创建者 Philip O'Toole 发布了一篇回顾长文,梳理该项目自 2014 年 9 月开源以来的十二年历程。当近年来的风投资本与云厂商热衷于将分布式 SQLite 包装成边缘计算时代的原生产物时,这段历史提供了一个完全不同的视角:这从来不是近年来为 Serverless 量身定制的全新架构,而是一场延续了十二年、技术代偿极其苛刻的工程折中实验。
分布式 SQLite 并没有打破单机数据库的吞吐天花板,增加节点完全无法换来分布式数据库那样的横向扩写能力。相反,它的真实本质是以写入性能暴跌为代价,换取单机嵌入式引擎的高可用容灾与强一致状态同步。随着商业化热潮的降温,这项技术正在撕下所有浮夸的光环,退回到它最初成立的狭窄生态位。
并非前沿神话,而是一场持续十二年的单写者实验
公众通常认为分布式 SQLite 始于 2021 年前后边缘计算的兴起,但这一技术脉络在业内早已存在多年。Expensify 自 2008 年前后就在内部生产环境基于 Paxos 选主和两阶段提交维护 SQLite 复制,并在 2016 年 10 月以 Bedrock 的名字开源。2014 年 3 月,基于 Erlang 构建、采用 Raft 复制 WAL 页的 ActorDB 就已在技术社区公开。
Philip O'Toole 在 2014 年 9 月 2 日正式开源 rqlite 时,初衷极为具体:为集群系统提供轻量关系型存储,而无需运维庞大的外部数据库。该项目初期采用 goraft 库,随后在 2016 年 4 月 9 日发布的正式标签版本中重构为 HashiCorp Raft 库并沿用至今。
这一技术谱系无论如何演变,都必须直面 SQLite 核心的物理限制:单写者锁机制。不管外部挂接了多么精巧的 Raft 日志或 Paxos 选主协议,集群内永远只有一个主节点能执行写操作。增加服务器节点不仅不能扩容写入吞吐,反而因为网络仲裁和日志落盘带来了不可忽视的延迟。
复制层级的三岔路,与断崖式下跌的写入性能
为了把单机状态机推向分布式,行业内分化出了三种截然不同的复制颗粒度:命令层、存储页层和文件系统层。每一种选择都在吞吐量与一致性之间留下了显著的妥协痕迹。
rqlite 选择了在应用层复制 SQL 语句与参数。这种方式对网络带宽开销极小,但其代价是从节点必须把主节点执行过的 SQL 逻辑原样重跑一遍。2017 年 Canonical 为解决 LXD 容器编排对外部组件的依赖而打造了 dqlite,选择通过自定义 VFS 直接复制底层物理页与 WAL 帧,省去了从机重复解析 SQL 的开销,却要求将 WAL 驻留在内存中,施加了更紧的内存约束。至于 Fly.io 在 2022 年基于 FUSE 文件系统构建的 LiteFS,则试图将事务变更拦截打包为 LTX 文件做异步分发。
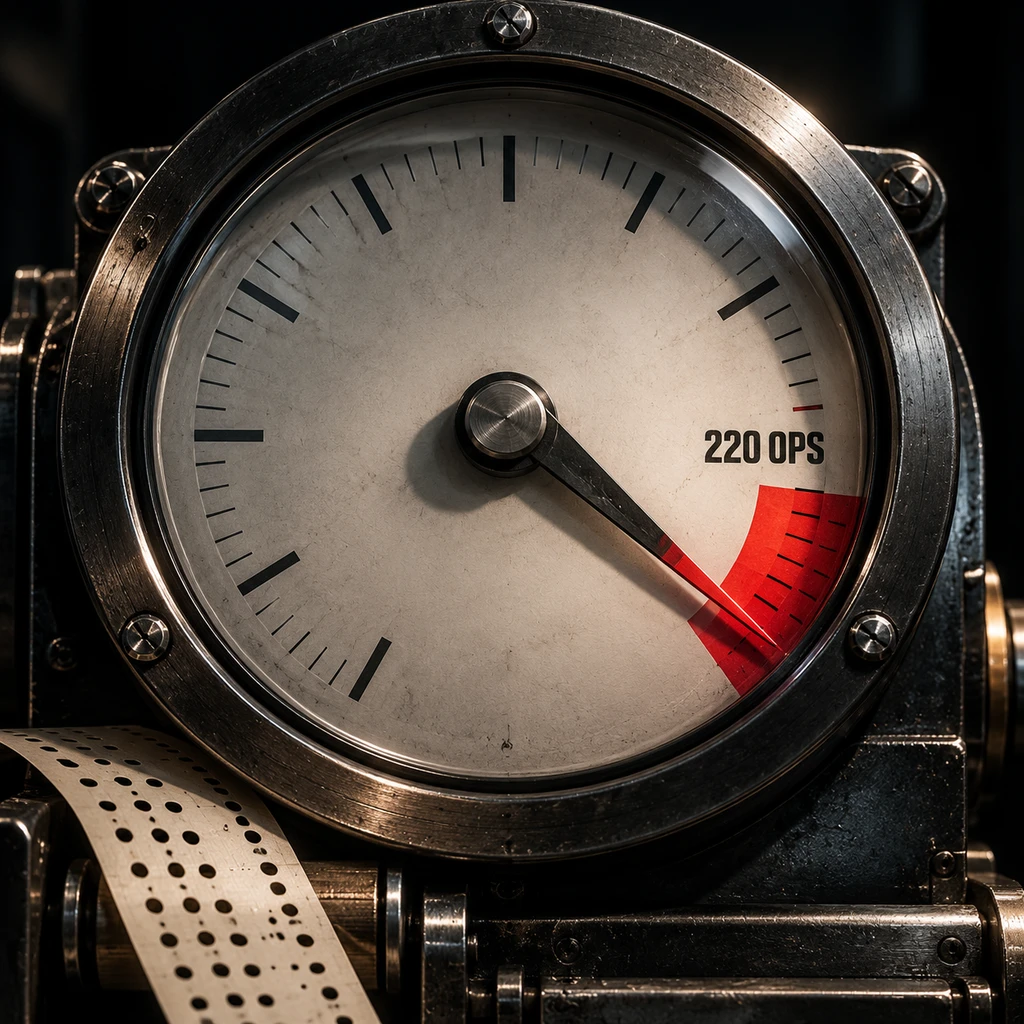
这些复制机制带来的性能代价极其高昂。在 2022 年 5 月 23 日发布的一组基准测试中,O'Toole 在跨 3 个可用区的 GCP 集群上实测显示:单条普通同步写入模式下,rqlite 吞吐量仅约每秒 220 次插入。即便开启批量写入排队,将批处理大小从 16 提高到 32,吞吐量虽提升了约 15 倍,但很快便撞上磁盘 I/O 和共识日志刷盘的硬瓶颈。
分布式 SQLite 从未解决并发写入,它只是用极高的时延税换取高可用仲裁。
文件系统层同样未能幸免。LiteFS 官方文档明确提示,由于用户态文件系统(FUSE)拦截系统调用带来的额外上下文切换,其实用事务吞吐上限通常被压制在每秒 100 次事务左右。更严重的是一致性层面的设计抉择:dqlite 的事务模型保证的是可串行化而非线性一致性,网络分区出现时旧主节点残留短暂的陈旧读窗口;依赖 Consul 租约选主的 LiteFS 采取异步复制,一旦主节点突发宕机,未同步的事务便存在直接丢失的风险。
- 风险.若业务场景要求持续的高频并发写入,引入任何形式的分布式 SQLite 都会迅速引发排队积压与性能雪崩。
商业退潮与神话破灭:边缘计算的叙事反噬
过去几年间,风险投资机构将分布式 SQLite 捧上了风口。以 libSQL 为基础的商业公司 Turso 拿到了早期风险投资,并在 2026 年被 Supabase 收购;Cloudflare 则上线了 D1 与 Durable Objects 存储服务。这些产品把复制细节深埋在云服务账单之后,试图让开发者相信数据库可以在边缘节点既轻量又无缝地多点同步。
然而物理规律无法被商业模式抹平。Fly.io 曾聘用 Litestream 作者 Ben Johnson 并全力押注 LiteFS,但如今 LiteFS 已在其官方文档中被正式标记为超出官方支持范围。与此同时,Turso 也将其核心研发重心转回独立自研的新存储引擎。重度依赖复杂文件系统拦截或深度魔改 SQLite 的商业化试验,在漫长的运维生命周期中逐渐暴露出力不从心的疲态。
| 解决方案 | 复制实现层级 | 写入并发特性 | 一致性模型保障 | 维护现状与定位 |
|---|---|---|---|---|
| rqlite | 应用层 SQL 命令 | 严格单写者(排队批处理) | 默认弱读,支持 Quorum 强读 | 达成 100 万下载,独立轻量服务 |
| dqlite | VFS 脏页 / WAL 帧 | 严格单写者(内存 WAL) | 可串行化(存在分区陈旧读) | Canonical 体系内嵌驱动 |
| LiteFS | FUSE 拦截 LTX 文件 | 严格单写者(主租约) | 异步复制(崩溃面临数据丢失) | 官方文档标记超出支持范围 |
| Litestream | 旁路轮询 WAL 变更 | 单机运行(非集群) | 依赖外部对象存储恢复时点 | 单机容灾主流基石方案 |
市场兜兜转转,最终印证了 Ben Johnson 在 2021 年推出 Litestream 时抛出的判断:绝大多数中小型系统根本不需要一个跨节点的数据库集群。单机 SQLite 具备极佳的读写性能,开发者真正需要的只是一种在机器彻底损毁时能够近乎实时从对象存储恢复数据的低成本手段。
正是在这一背景下,不带任何风投资金背景的 rqlite 展现出奇特的韧性。截至 2026 年 5 月 25 日,rqlite 在 Docker 官方平台达成了 100 万次镜像下载,被 Replicated 与 Text Groove 等企业用于需要私有化独立运行的场景中。在这些不需要重型 PostgreSQL 运维负担、却必须抵御单机宕机的本地化交付系统里,一个开箱即用、完全开源的单二进制文件服务恰好契合了工程现实。
- 结论.对于大多数边缘或中小型系统,单机 SQLite 配合 Litestream 依然是最优解;仅当宕机恢复时间要求降至零且写入频率极低时,rqlite 这一类独立共识服务才有其实际选型价值。