通用大模型就像一个聪明绝顶、但每天都在第一天上班的博士生。为了治好大模型记不住教训的毛病,斯坦福同窗 Ronak Malde、Michael Elabd 和 Arjun Karanam 在一年前创立了 Trajectory。这支仅 18 人的团队刚刚拿下了 4500 万美元 A 轮融资,估值达到 3 亿美元。此轮融资由红杉资本领投,Nvidia、Bessemer Venture Partners 和 Bain Capital Ventures 参投,其自动化后训练平台也同步向公众开放。
这笔钱的账面口径其实有些时间差。早在 2026 年 8 月 11 日,The Information 就披露过 Trajectory 以 3 亿美元估值拿下了红杉参投的 4000 万美元;而翻看 Trajectory 官网主页,目前挂出的数字是 6000 万美元 A 轮加种子轮总额。不管公关节奏如何拆分,资本买单的逻辑很明确:三位创始人分别来自 Google DeepMind(含从 Windsurf 收购招募的成员)和 Apple 基础模型团队,还从 OpenAI、Stripe 和 Netflix 挖来了研究员与产品设计师。他们承诺让不懂代码的律师、医生自己动手训练开源模型,把昂贵的算法外包和前线部署工程师直接踢出局。
外行调教 AI 的黑盒里装了什么
新闻稿里最动人的画面,是律师和金融分析师在日常工作里顺手给 AI 纠错,模型就能像工作了 30 年的老手一样持续进化。Harvey、Rogo、Decagon、Mercor 和 Nvidia 都已经被列在了客户名单上。
但扒开产品底层就会发现,所谓的公众开放与实时进化,现实约束比宣传大得多。Trajectory 官网目前没有公开美元定价表,接入仍需排等候名单或申请 Demo;其核心的持续学习功能 Continual Grading(从专家示例中学习任务专属评分器)和 Group Size 1(从单次生产交互中学习),至今仍挂着研究预览版的标签。
更重要的是,模型并不会因为律师改了一行合同就立刻刷新权重。WIRED 曾在 2026 年 5 月 27 日的报道中点破,Trajectory 的模型更新频率最高约为每周一次,两次更新之间模型完全保持静态。这种机制被联创 Michael Elabd 包装为安全考量:相比让 AI 自己改写代码的递归自我改进(RSI),保留人类在环路中能防止失控。
那不懂代码的律师到底怎么训练模型?真正干脏活的是元评分器(Metagrader)。
在 Trajectory 于 2026 年 11 月 2 日发布的 Continual Grading 报告中,团队用 60 个专家标注任务构建出元评分器,让它学会人类专家的评判标准,再去自动给海量任务打分训练。在 τ³-Bench 评测中,这套方法把奖励分数从 80.0% 提到了 84.9%(直接用原始评分器则是 87.8%)。说白了,外行并没有直接调教大模型,他们只是喂了几十道标准答案,先教会了一个自动批卷机。
实验室数据里的跷跷板困局
如果只看公关稿,你会以为开源模型经过这套流水线洗礼,就能在律所和投行里独当一面。但我翻完了 Trajectory 自己挂在官网上的两份技术报告,看到的却是一场残酷的数字魔术。
在 2026 年 8 月的法律 Agent 报告里,Trajectory 拿开源的 Nemotron 3.5 Lightning 开刀,将其任务全通率(all-pass)从 0% 提升到了 8.3%,顺手赢过了同场测试里拿到 6.6% 的 Opus 4.6;二次优化后,模型的平均输出从 9 万 token 砍到了 3.7 万 token。到了 2026 年 11 月 2 日,他们又对 Qwen3.6-35B-A3B 做了 258 个保留任务测试,用生成式评分标准把 Harvey-LAB 全通率从 1.4% 提到 6.6%,用专家标准则提到 4.4%(两者置信区间重叠)。
省下一半以上的 token 固然能帮应用商省钱,但一个全通率只有 4.4% 到 8.3% 的法律模型,每干十票还要砸九票。更刺眼的真相藏在 11 月 2 日报告的附录里。
模型学会了考满分,却把及格的基本功全忘光了。
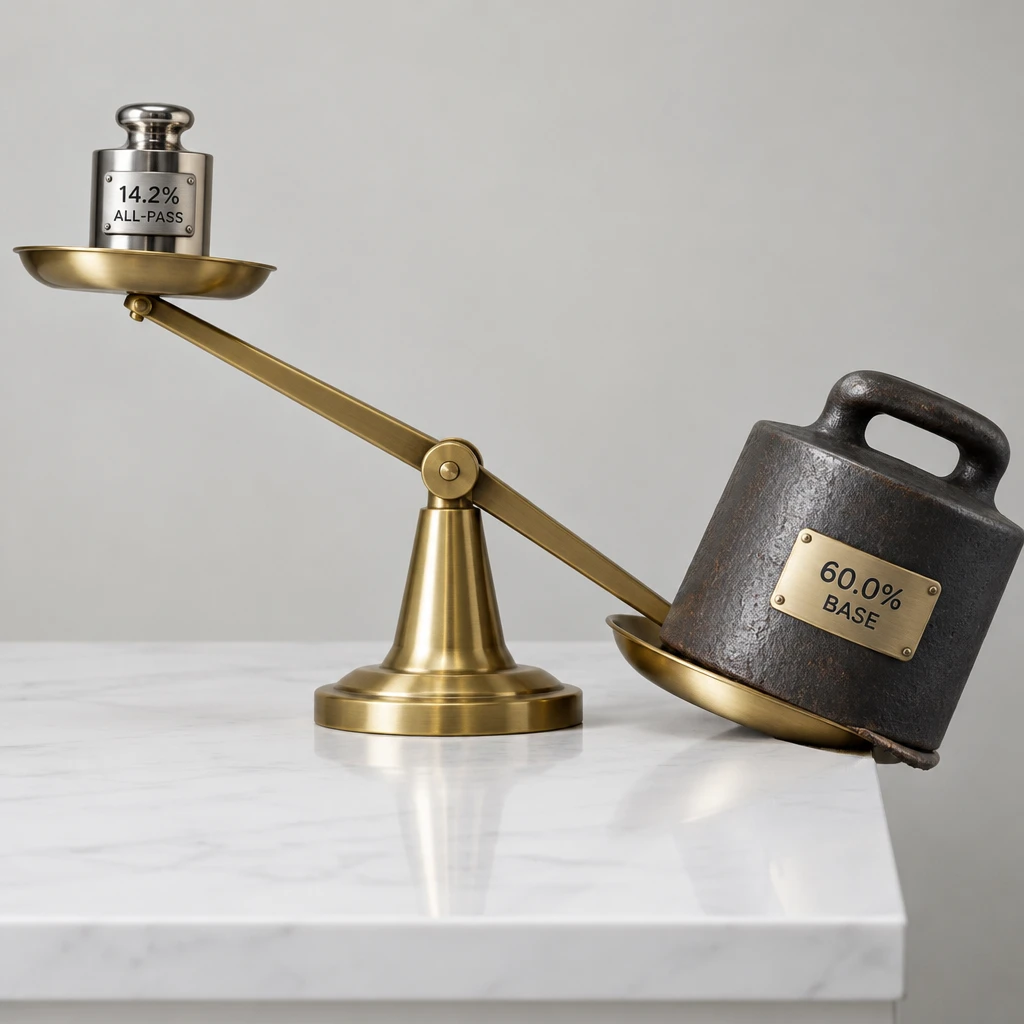
在这份早期 Nemotron 实验附录中,微调后完全满足所有专家标准的任务比例,确实从基座模型的 4.2% 涨到了 14.2%(使用专家标准)和 15.8%(使用合成标准)。但与此同时,模型满足的单项专家标准总比例,却从基座的 76.7% 暴跌到了 66.9% 和 60.0%。
韩非子讲过一个买椟还珠的道理,用在今天的强化学习后训练上依然贴切。当算法为了迎合评分器、拼命把少数任务的通关率往上拔时,模型就会通过牺牲通用基本功来换取局部高分。所谓标杆客户 Rogo 在公开渠道只有员工领英动态提及,没有任何量化案例;Harvey 的成绩单则全出自这套存在明显偏科隐患的内部基准测试。
- 风险.后训练在拉高特定任务通关率时,极易触发灾难性遗忘,导致模型整体单项达标率出现超 15 个百分点的倒退。
百亿美金赛道分裂成两条路
Trajectory 绝不是唯一盯上这块肥肉的公司。就在它拿 3 亿美元估值的同时,后训练赛道已经挤进了前 OpenAI CTO Mira Murati 创立的 Thinking Machines Lab、上个月刚拿到 32.5 亿美元估值的 Applied Compute,以及刚刚融了 1.3 亿美元 A 轮的 Prime Intellect。
但这四家公司虽然都在抢微调的生意,底层的商业算盘已经彻底裂开。
| 公司与产品 | 核心训练与交付范式 | 定价模式与公开实证 |
|---|---|---|
| Trajectory | 专家标注训练元评分器,按周更新开源模型 | 官网未公开定价表,需预约 Demo;Harvey 评测全通率 6.6%-8.3% |
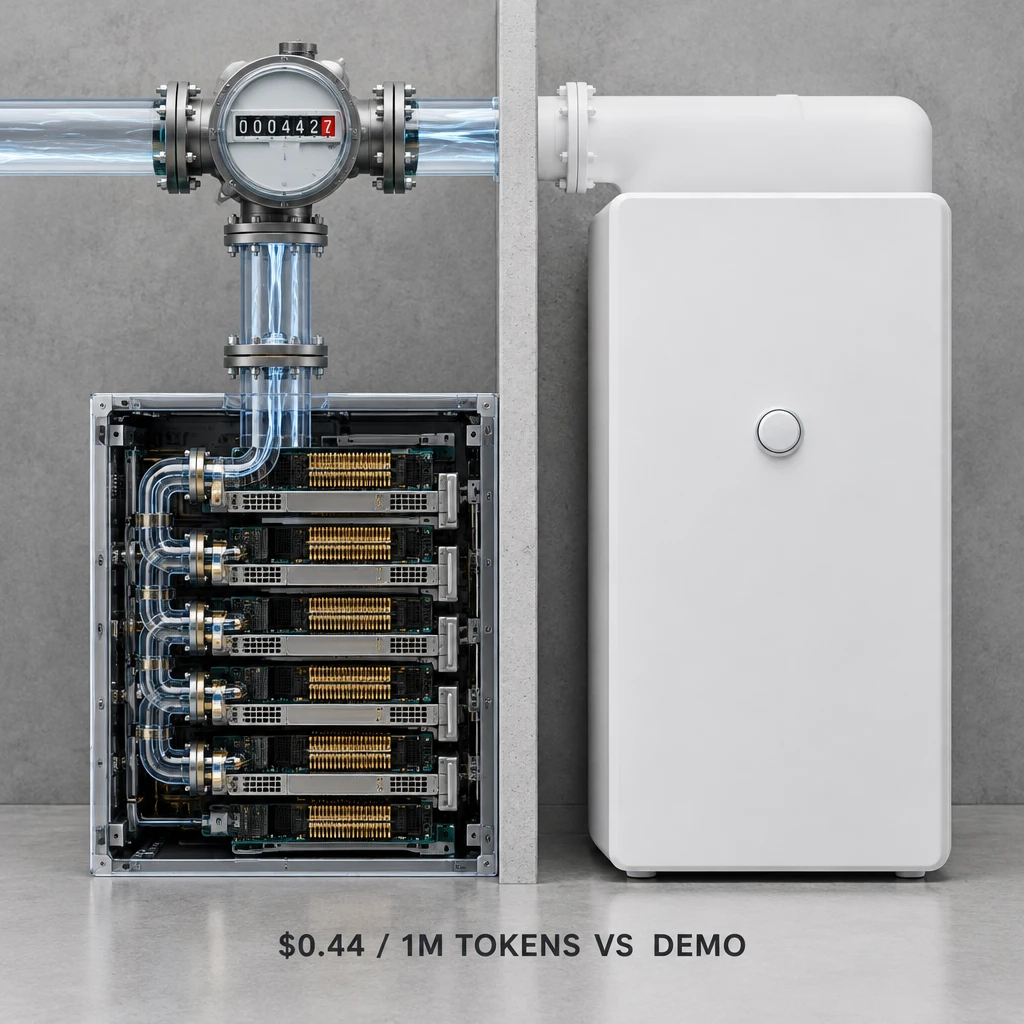
| Thinking Machines (Tinker) | 提供底层微调算力原语与 API | 明码标价:Qwen3-8B 为 0.44 美元/百万 token;桥水准确率达 84.7% |
| Prime Intellect | 砍掉共享 LoRA,转向独占 GPU 全参数训练 | 按 GPU 秒级计费,主攻企业自建与训练专属 Agent |
| Applied Compute | 自动化后训练结合深度驻场研究优化 | 估值达 32.5 亿美元,体量约为 Trajectory 的十倍 |
你看 Mira Murati 的 Tinker,走的是极其透明的水电煤路线。他们在 2026 年 10 月 19 日更新了公开价格表,训练 Qwen3-8B/32K 只要 0.44 美元/百万 token,训练 Qwen3.6-35B-A3B/64K 则是 1.177 美元/百万 token。桥水基金直接用 Tinker 训练 Qwen3-235B 来做 6 项金融筛选任务,准确率干到了 84.7%(同期最佳前沿模型只有 78.2%),单任务推理成本还暴降了 13.8 倍。另一边的 Prime Intellect 则干脆退役了共享按 token 计费的 LoRA 服务,全面押注独占 GPU 的全参数训练。
这就像二十年前的企业软件战争。Tinker 和 Prime Intellect 在卖标准化的云服务器和数据库原语,明码标价,让有工程师的团队自己动手;而 Trajectory 试图直接卖一套傻瓜式的业务工作流,去替代年薪数十万美元的前线部署工程师。
- 结论.给开源模型做后训练确实能帮垂直应用砍掉过半推理成本,但在评分器偏见和遗忘问题解决前,它还替代不了真正懂业务的驻场工程师。
回到开头那个新入职博士生的比喻。Trajectory 证明了用几十个专家样本捏出一个自动批卷机,确实能让阿里 Qwen 和 Nvidia Nemotron 这类开源模型在特定考卷上多拿几分。但律所和投行需要的不是一个为了押中一道大题、把原本 76.7% 的日常及格率砸到 60.0% 的偏科生。在 Trajectory 敢于公开透明的价格表、并交出跨越数月真实生产流量且不发生灾难性遗忘的留存数据之前,那位工作了 30 年的老专家,位置依然稳得很。